何が起きたか
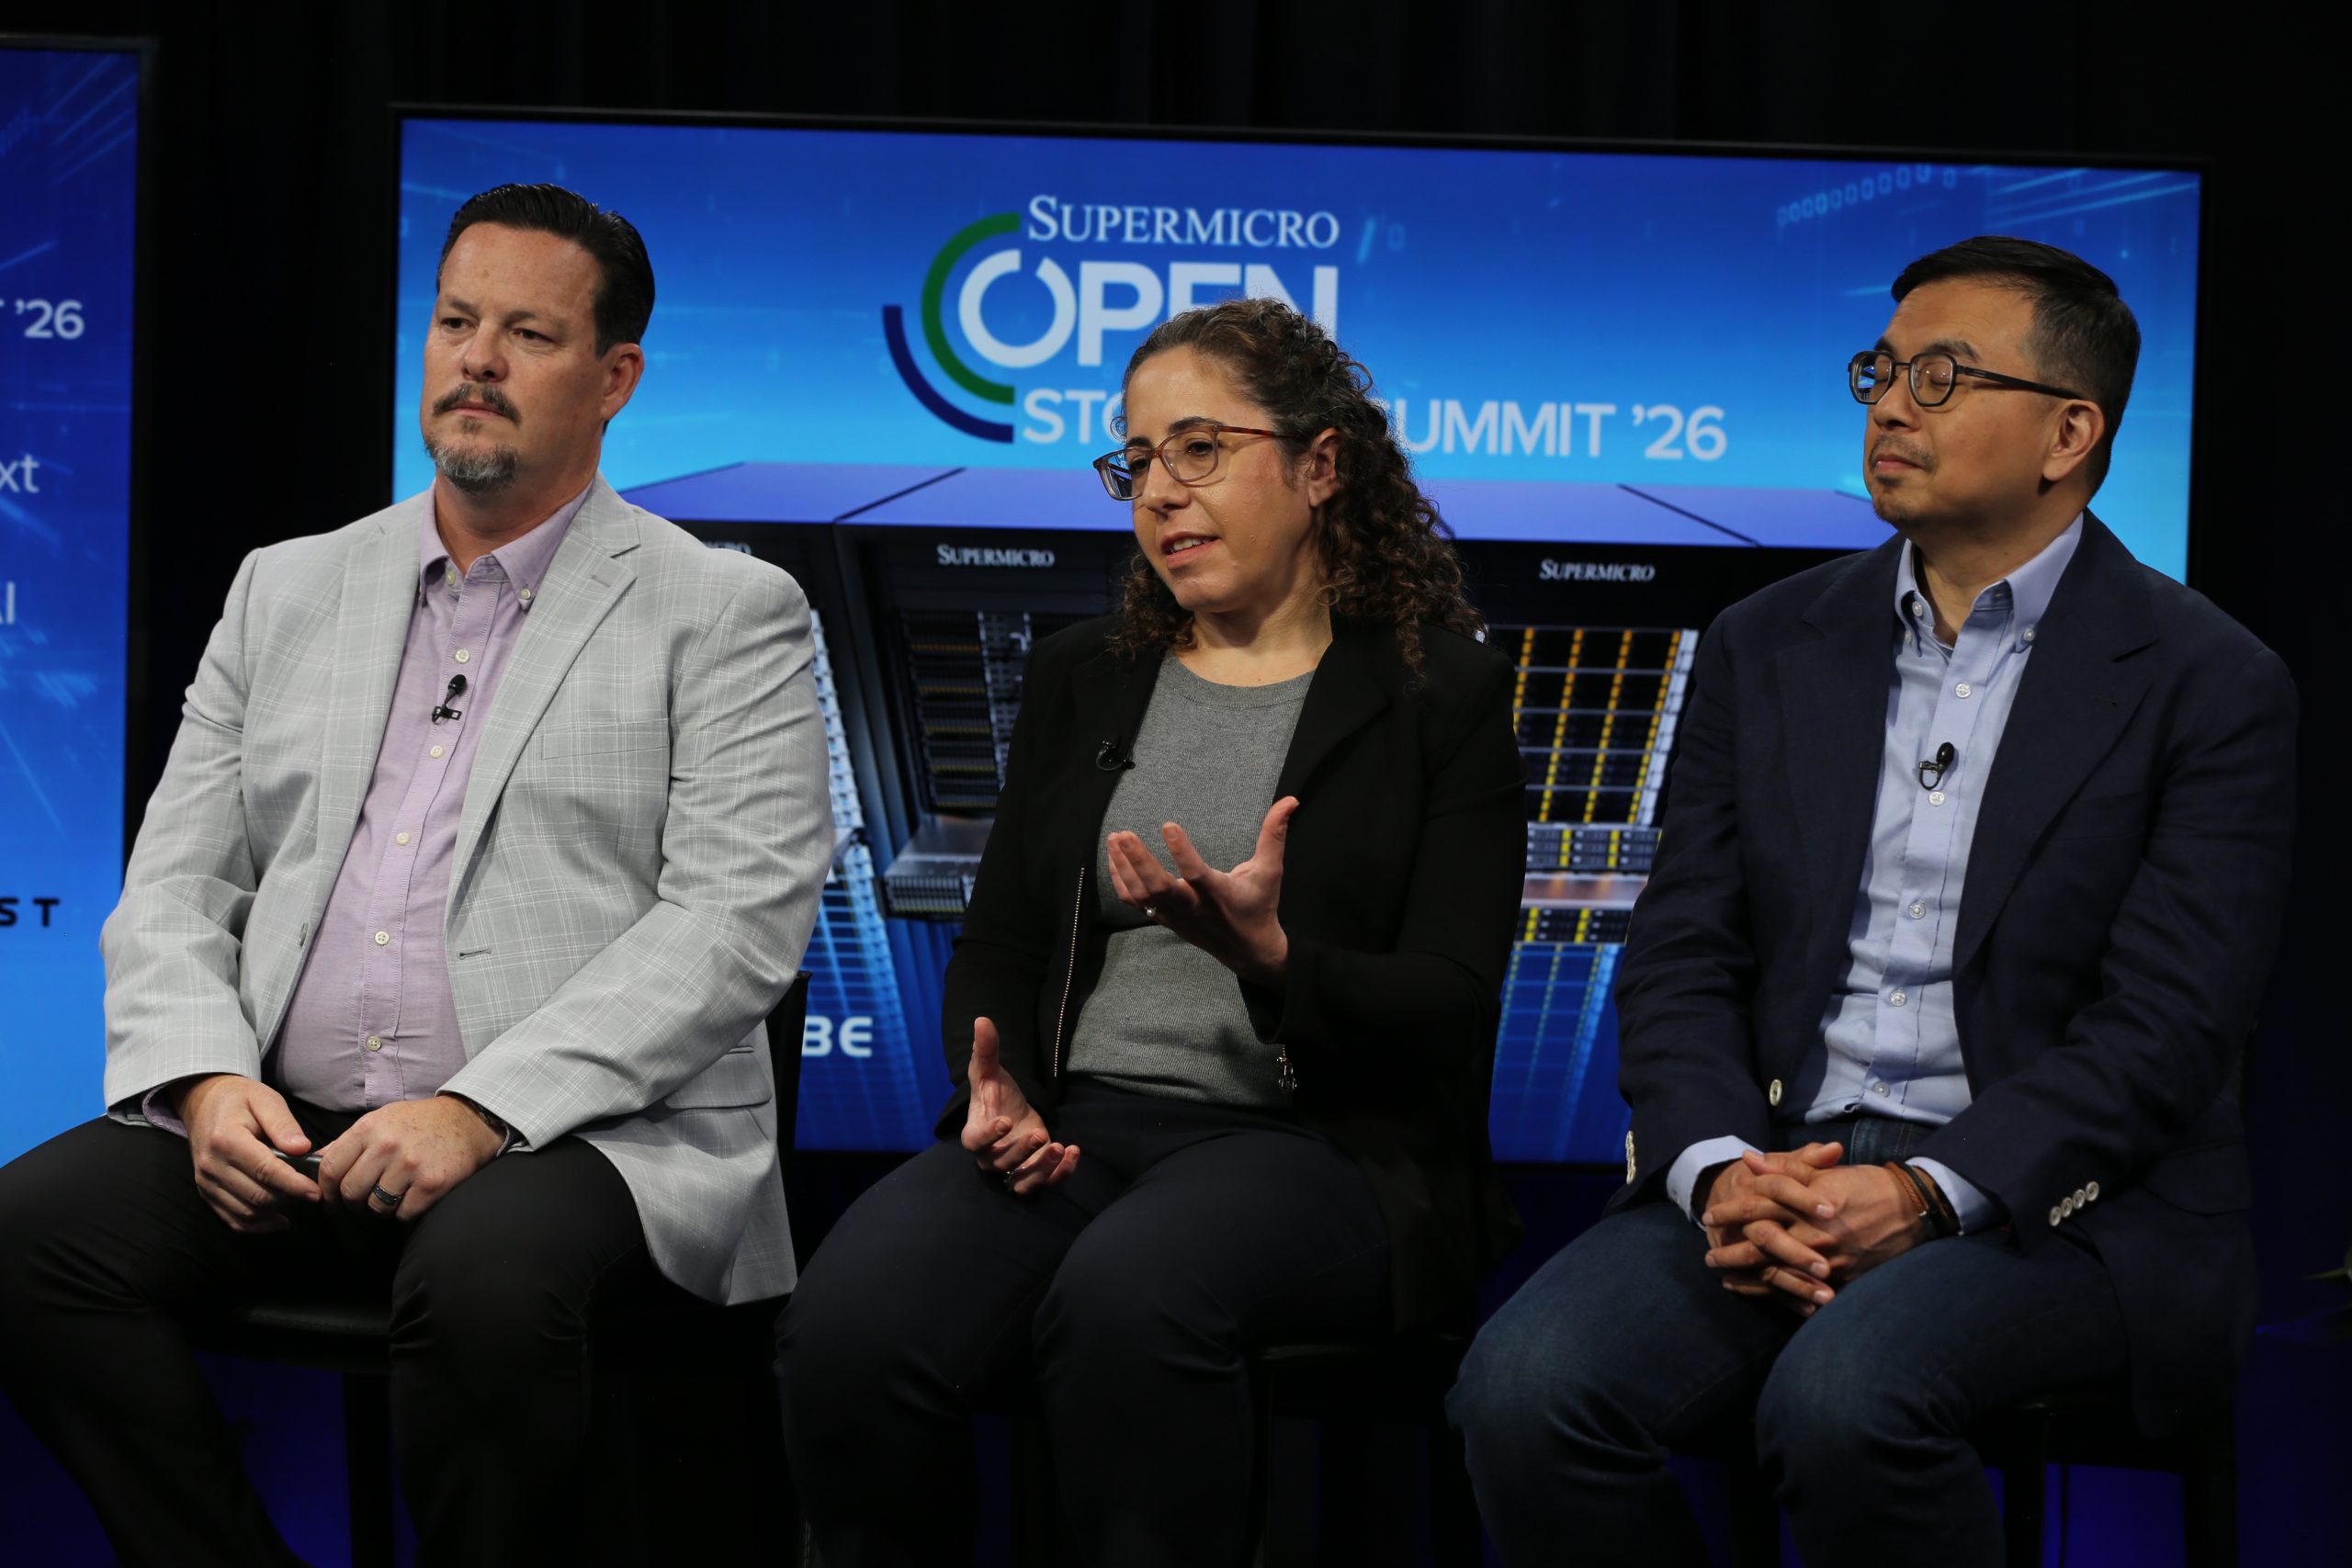
Supermicro Open Storage Summitで、Solidigm、Vast Data、Supermicroが、エージェント型AIの長いコンテキストに対応するため、SSDやKVキャッシュを含むストレージ階層の追加が必要と議論。Vast DataはNvidia Dynamoでトークン初出までの時間が20倍速く、GPU時間を90%削減と報告。
なぜ重要か
エージェント型AIが拡大する中、GPUメモリだけでは全コンテキストを保持できないため、ストレージ階層が近接性、容量、速度のバランスを提供。KVキャッシュのオフロードは高価な計算をストレージに置き換え、レイテンシを減らし、GPUコストを節約。国内のAI基盤を運用する事業者では、長い文脈の処理に伴うGPUコストが、ストレージの活用で抑えられる可能性がある。
注目点
SupermicroのCMX提案は大規模AIクラスタ向けで、AIネイティブKVキャッシュとしてG3.5階層を導入。SolidigmのD7-PS1010とD5-P5336 SSDは、まだ進化するストレージ階層の異なるポイントに対応。
こういう要約が、毎朝あなたのメールに届きます。
Supermicro Open Storage Summitでの議論は、AIインフラの優先順位の変化を浮き彫りにした。組織がモデル学習からエージェント型AIの導入へ移行する中、ストレージが新たな役割を担う推論に注目が集まる。コンテキストウィンドウの拡大により、GPUメモリだけでは不十分で、近接性・容量・速度のバランスを取る追加のストレージ階層が必要になる。SolidigmのSSD、Supermicroのシステム、Vast DataのAIオペレーティングシステムは、推論中のデータ管理を多層的に支える。
KVキャッシュのオフロードは中心的な概念であり、高価なGPU計算をストレージに置き換える。Vast Dataが報告したトークン初出までの時間の20倍改善とGPU時間の90%削減は、その潜在的な利点を示す。このアプローチは万能ではなく、SupermicroのLee氏が指摘するように、導入形態によってメモリ、ローカルSSD、ネットワークストレージの組み合わせは異なる。G3.5のような新たな階層が登場し、アーキテクチャは進化を続けている。
企業への影響は大きい。AI推論が普及するにつれ、ストレージインフラの管理は性能とコストに直結する。Solidigm、Supermicro、Vast Dataの連携は、単一コンポーネントではなく統合ソリューションへのトレンドを示唆する。この進化は、AIワークロードの最適化とGPU使用コスト削減の追求により、今後も続くだろう。
業界と使っているAIツールを選ぶと、仕事に関係するニュースが毎朝届きます。
登録無料・Googleアカウントなら30秒・いつでも解除できますAITodayについて →
この記事についてわからないことをAIに質問できます。AIはこの記事・AIToday の過去記事・Wikipedia を読み、出典を付けて答えます。Q&Aはこのページに公開され、他の読者も読めます。
Motley Foolは、2026年上期にAWSがAmazonの売上の21%ながら営業利益の大半を稼ぎ、Amazonが2200億ドルの設備投資を計画し、AI企業なのはAmazonだと論じた

バークレイズがHPEとデルを保有相当に格下げし、HPE株は5%安の55.87ドル

Vercelが木曜に公表したデータによると、TypeSafe AIのJevは、9月15日の限定リリースから2週間以内に有料チームの35%が使用した

Chunghwa Telecom社長のRong-shy Lin氏は、会話型AIから自律型AIエージェントへの移行が企業導入を変え、大規模導入にはデータガバナンス、アクセス制御、説明責任が不可欠だと述べた

CoreWeaveは金曜の時間外取引で5%下落し、週間で15%安となる見通し

AppleとMetaは、ハイエンドMacでの動作を想定した新しいオープンウェイトAIモデルを共同で公開すると発表した


