何が起きたか
AI検出器をしきい値で二値化する分類器とみなす分析。Liangら(2023年、Patterns)が7種の検出器をTOEFL論文91本と米国8年生の論文88本に適用した。
なぜ重要か
同じ検出スコアでも正直な学生が疑われることがある。書き手の語彙が単純になると信号がずれることを示しており、表示される単一の割合は重要な判断への信頼を過大に見せかねない。
こういう要約が、毎朝あなたのメールに届きます。
仮想例から始まる。教師が学生の論文に「AI 87%」を見て、それを測定値と受け取る。著者の主張は、それが代理分類器の出力であり、著作性を読み取ったものではないということだ。どの検出器も文書をスコアに変換し、しきい値を超えれば検出とするが、真のラベルを観測しているわけではなく、表面のテキストのみを見ている。したがって検出器が試しているのは、調整データにおいて人間と機械の文章の間にたまたま存在した差異にすぎない。
著者が依拠する証拠は分布外のテストだ。Liangら(2023年、Patterns)は広く使われる7種の検出器を、人間が書いたTOEFL論文91本と米国8年生の論文88本に対して実行し、TOEFL論文の偽陽性率は平均約61%だった。著者はさらに介入実験を強調する。ネイティブが書いた語彙を第二言語の分布に近づけるよう単純化すると、誤分類が急増し、ラベルが交絡因子に従うことが示された。著者はまた、この研究自体の限界も指摘する。小規模な予備的サンプルであり、2023年初頭の検出器は主に旧式で小型の言語モデルに依存していた。
そこから記事は運用面に広がる。表示される単一の割合は誤りがどこに集中するかを隠し、検出器間の不一致自体が不確実性に関する情報を含んでいる。設計チェックリストは、局所的な証拠、グループ別の誤り率、不確実性の範囲、人間の関与を求めている。検出器の結果を証明ではなく証拠の一つとして位置づけ、最終判断は人間が下すべきだとする枠組みだ。
業界と使っているAIツールを選ぶと、仕事に関係するニュースが毎朝届きます。
登録無料・Googleアカウントなら30秒・いつでも解除できますAITodayについて →
この記事についてわからないことをAIに質問できます。AIはこの記事・AIToday の過去記事・Wikipedia を読み、出典を付けて答えます。Q&Aはこのページに公開され、他の読者も読めます。
このようなAIの動きを、御社の業界・競合に合わせて毎日届ける法人プランもあります → 詳しく見る
Discovered Materialsは、学術諮問グループが提示した材料科学の5課題——銅酸化物超伝導やシリコン-二酸化シリコン界面など——の解決策に100万ドルの賞金プールを設けると発表した
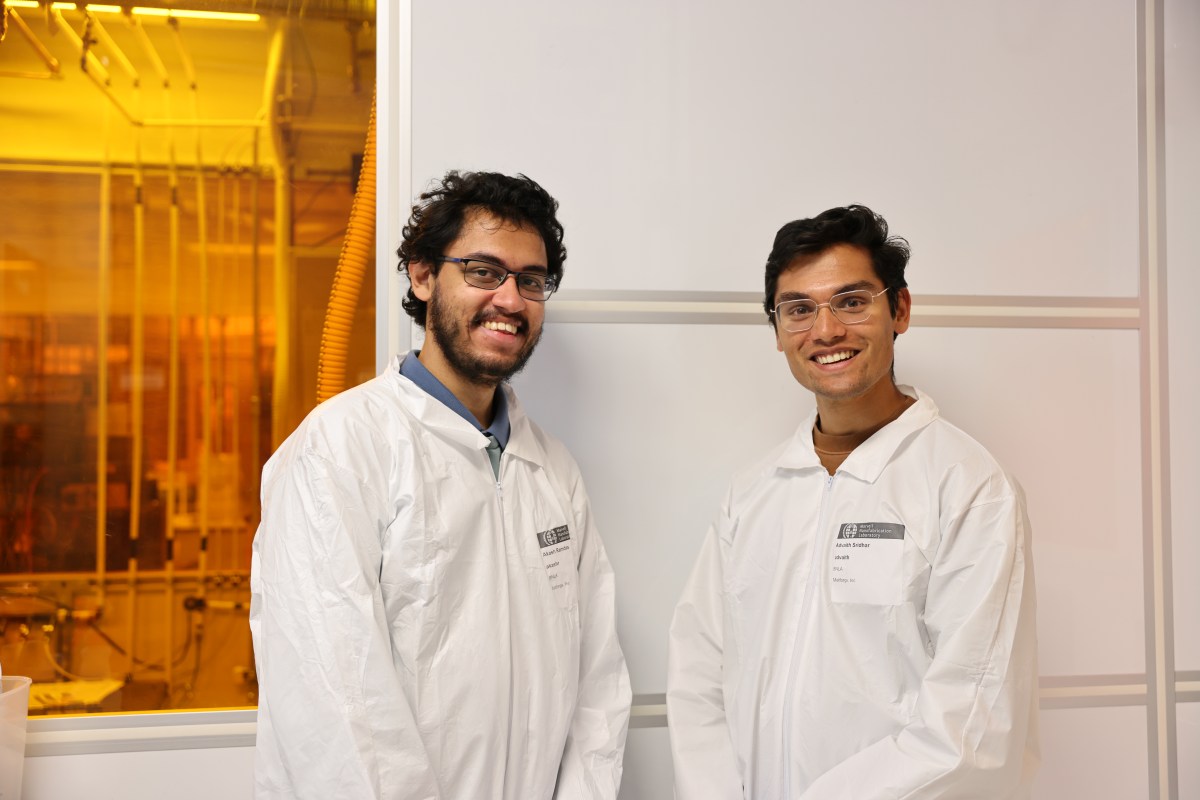
2026年10月21日、Anfini CEOの橋本淳氏が明治大学理工学部で特別講義を行い、Anfini AIX Methodや請求書入力、為替影響予測などの事例を紹介した

13日間・5,065リクエストのセッションで終盤は約0.42ドル、新規は約0.013ドルで31倍の差
2026年4月にClaude Proへ登録し後にMaxへ移行したWebデザイナー歴6年の人物が、ClaudeのチャットアプリとClaude Codeは参照範囲と必要なプランが異なると説く全3回ガイドの第1回を公開した
EC自動化工房がAI翻訳前に標準化すべき4項目を示した
OpenAIのGreg Brockman社長は11月4日のWSJ Techで、2026年第3四半期の年換算売上高が70%増加し、法人向けが「2倍」となり、事業顧客が売上高の半数超を占めたと述べた