何が起きたか
Zennの解説記事がRAG(検索拡張生成)を分解。LLMが答える前に外部データを検索する仕組みで、チャンク化やEmbedding、単なるベクトル検索との違いを説明。
なぜ重要か
RAGはハルシネーションを排除しない。検索が成功してもLLMが誤読したり根拠のない詳細を加えたりするため、アクセス制御と回答の検証が欠かせない。
こういう要約が、毎朝あなたのメールに届きます。
解説記事はRAGを、大規模言語モデルの基本的な限界への実用的な対処法として位置づける。LLMは大規模データセットで学習するが、企業の最新マニュアルや社内規則、顧客情報は知らず、学習後に追加された情報を自動で学ぶこともできない。RAGはモデルが答える前に外部データを検索することでこれを補う。経費精算は毎月25日締めという社内規則の例が、関連するテキストを検索してLLMに渡す流れを示している。
仕組みは準備と回答に分かれる。文書をチャンクに分割し、Embeddingモデルでベクトルに変換して保存する。利用者が質問すると質問もベクトル化され、保存済みのベクトルと比較して、最も近い箇所が質問とともにLLMへ渡される。RAGはベクトル検索に限らず、キーワード検索やハイブリッド手法も含むため、RAGをEmbeddingベースの検索と同一視するのは範囲を過小評価することになる。
注意を促す章が最も実務に関わる。検索が有用な情報を見つけられない場合や、LLMが正しい資料を誤読して根拠のない具体を加える場合にRAGは失敗しうる。マニュアルに25日とだけあるのにAIが「25日午後5時まで」と答える例が挙げられている。情報がない場合はそう伝えるようモデルに指示すること、出典文書を表示すること、重要な判断には人による確認を加えることが対策として提案されている。RAGの構築にはモデルの選定だけでなく、データ取り込み、検索、権限管理、評価、運用にわたる設計が必要だ。
業界と使っているAIツールを選ぶと、仕事に関係するニュースが毎朝届きます。
登録無料・Googleアカウントなら30秒・いつでも解除できますAITodayについて →
この記事についてわからないことをAIに質問できます。AIはこの記事・AIToday の過去記事・Wikipedia を読み、出典を付けて答えます。Q&Aはこのページに公開され、他の読者も読めます。
このようなAIの動きを、御社の業界・競合に合わせて毎日届ける法人プランもあります → 詳しく見る
外務省の要請を受け、来年度予算の裏付けを得た国際交流基金が、有名なアニメ・マンガのキャラクターと日本語会話を練習できるアプリを開発し、2028年度までの完成を目指す
SHLの6〜7月調査で、米国の回答者の19.1%がAIに職を代替された後、復帰を求められたと答えた
1,000件のリクエストを模したキューで、最初のトークンまでの中央値が452秒(7.5分)から14秒に短縮され、48トークンの単一回答も567 msから39 msになった
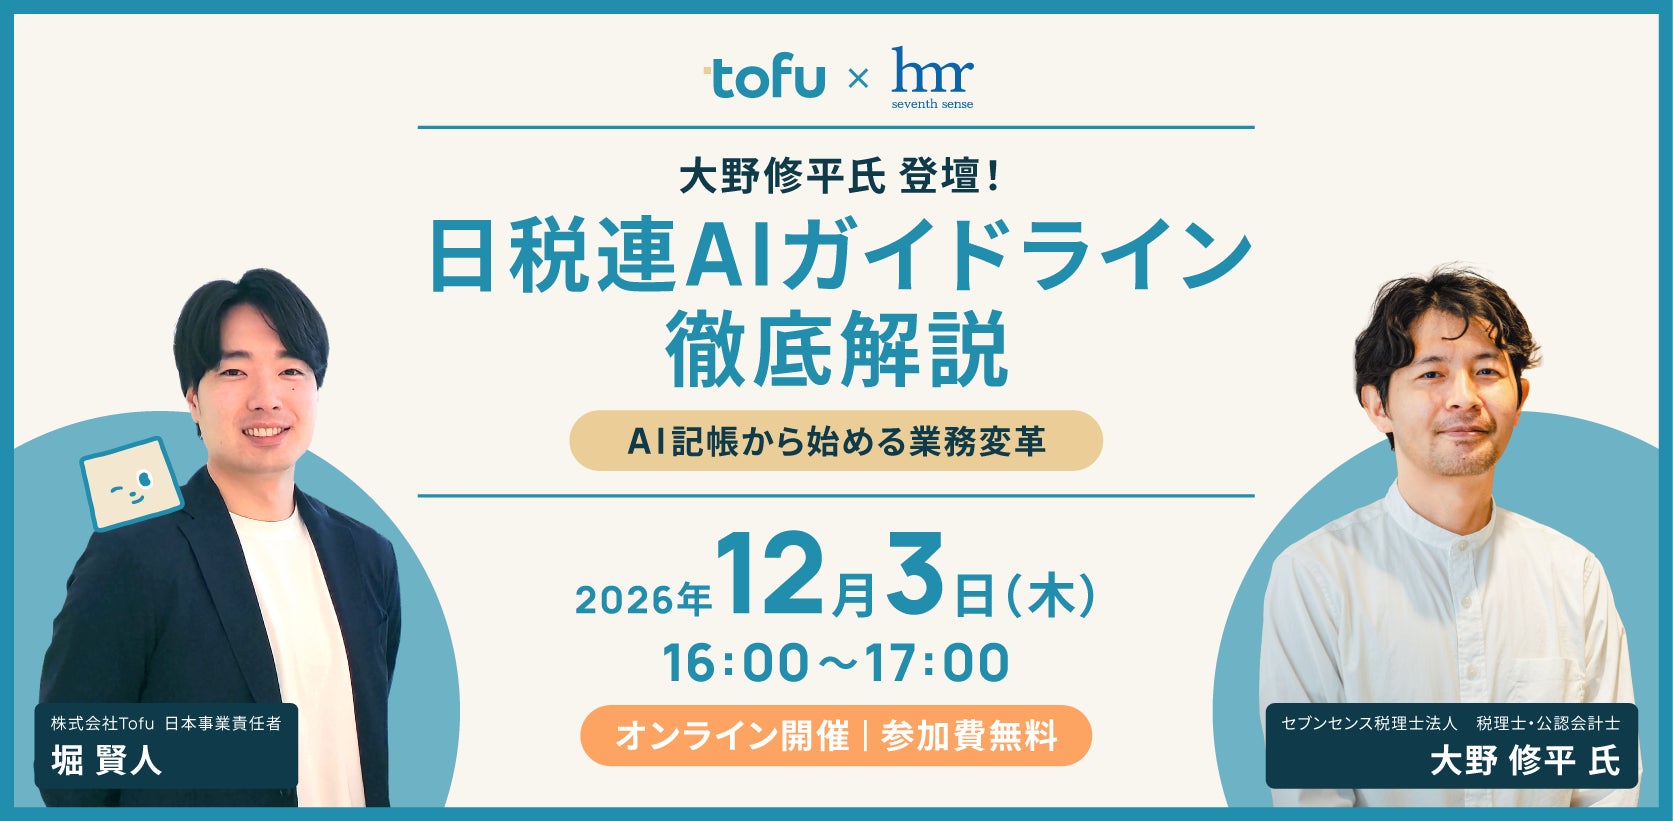
Tofuは税理士・大野修平氏が登壇するウェビナーを発表
ISFnetは3種のトレーニングとAIエージェントの要件ヒアリング・構築をまとめた「Microsoft 365 Copilot 導入フルサポートパッケージ」の提供を開始した
Shizuku AI技術部は11月5日、AI VTuber「しずく」とiPhoneだけで音声会話できる試作版を公開したと発表した