何が起きたか
Anthropicの調査で、エージェント型ワークフローは通常チャットの約4倍、マルチエージェント構成は約15倍のトークンを消費することが判明。モデルとツールの呼び出しごとに文脈を再読み込みするためだ。
なぜ重要か
トークン単価が下がっても消費量がそれを上回れば請求額は減らない。記事はプロンプトキャッシュ、モデルルーティング、文脈圧縮、バッチ処理、ツール絞り込みを効果順に紹介する。
注目点
最大の削減幅はベンチマーク値であり、ルーティングの効果はワークロード次第だ。記事はルーティングが無言で回答品質を落とすと警告しており、タスク別・ツール別にトークン消費を測定できるかが試される。
誰に効くかこれはAI APIの請求を負担するプラットフォームチームとFinOpsチーム、さらにモデル選定やエージェントへのツール公開を担うエンジニアに影響する。エージェント導入の予算を組む人にとってのチェックリストでもある。記事はコスト管理はタスク単位のトークン可視化から始まると主張している。
こういう要約が、毎朝あなたのメールに届きます。
この記事は、APIの挙動からAIの実態を読み解くシリーズの第4回であり、過去の回を踏まえている。第3回ではエージェントがモデルとツールを繰り返し呼び出し、そのたびにシステムプロンプトと会話履歴を再読み込みする理由を説明し、第2回では監査を扱った。この仕組みが安いトークンを高額な請求に変える。1つのタスクで多数の呼び出しが発生し得るからだ。
5つの対策は優先順位付きのツールボックスとして提示され、記事はそれぞれの効果を慎重に見積もっている。最も明確な効果があるのはプロンプトキャッシュで、Anthropicはキャッシュ済みトークンの入力を通常の10分の1で課金し、OpenAIは自動的に半額にする。バッチ処理は多くのサービスの料金を半減させ、キャッシュとの相性も良い。ルーティング、圧縮、ツール絞り込みはより条件付きだ。RouteLLMの数字(リクエストの4分の1をフロンティアモデルに送り、その品質の約95%を維持、コストを最大85%削減)はベンチマーク条件下のもので、記事は期待される削減幅の3分の1を実運用での安全な想定として挙げている。ツール絞り込みはプロンプトのトークンを半減させ、選択精度を3倍にするとされるが、圧縮には情報が欠落するリスクがある。
記事自身の注意点は、これらの対策は積み重ねられる一方で品質を少しずつ損ない、特にルーティングの失敗はエラーを出さず弱い回答を生むだけに気付きにくいというものだ。だからこそ記事は測定の話で締めくくる。見えないものは削れないのであり、クラウド支出で一般的なFinOps型のコスト可視化をトークンに適用すべきだと指摘する。重要なのは個々の手法よりも、トークン消費を特定のチーム、エージェント、タスク、ツールに紐付けられるかどうかであり、本文は多くの職場でこれが未解決だと述べ、次回は実装と2026年7月28日に正式化されたMCP仕様を扱うとしている。
業界と使っているAIツールを選ぶと、仕事に関係するニュースが毎朝届きます。
登録無料・Googleアカウントなら30秒・いつでも解除できますAITodayについて →
この記事についてわからないことをAIに質問できます。AIはこの記事・AIToday の過去記事・Wikipedia を読み、出典を付けて答えます。Q&Aはこのページに公開され、他の読者も読めます。
SOMPOホールディングスは2025年3月にAIリスクガバナンスを制定し、グループのAIシステムにリスク評価とモデル出力試験を義務付け、Dataikuが精度・堅牢性・セキュリティ試験を担う
Canonが家庭用インクジェットプリンター向けの新サポートサービスを開始
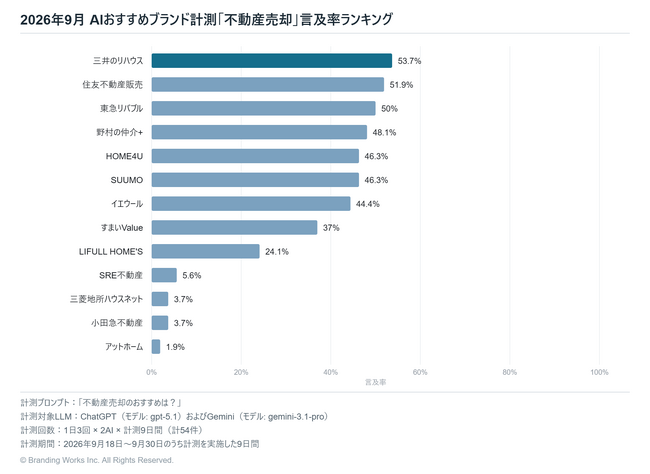
Branding Worksの2026年9月調査で、三井のリハウスが言及率53.7%で首位、住友不動産販売が51.9%、東急リバブルが50%で続いた
Exa Enterprise AIは本日、JA信金・JA共済・JA厚生・JA全中の業務向けに30以上のAIエージェントを備えた「Exabase AI for JA」の提供を開始した
アナリストがKLAをZacksランク2に格上げし、コンセンサス利益予想を約9%引き上げた
デルはNVIDIA RTX Spark搭載のXPS 16 Creator EditionとCreator Edition Desktop、Windowsで動くGB300搭載Dell Pro Precisionを発表