何が起きたか
llama.cpp v1.0.0が2026年11月13日に登場し、セマンティックバージョニングを採用。35の非推奨関数とllama_set_warmupなどのオプションが削除された。
なぜ重要か
llama.cppで開発する人はバージョン番号だけで互換性を判断できるが、削除された非推奨APIに依存するアプリは移行が必要だ。
こういう要約が、毎朝あなたのメールに届きます。
1.0というラベルは新機能よりも約束事の意味が大きい。今後は公開C APIの破壊的変更でメジャー、機能追加でマイナー、バグ修正でパッチの番号が上がる。これまでのllama.cppのバージョンはb12359のようなコミット番号で、依存するアプリ開発者には互換性の判断材料にならなかった。今回のリリースに伴う整理では、35の非推奨関数とllama_set_warmupや--defrag-tholdなどのオプションが削除されたため、旧APIに頼るアプリは今すぐ移行する必要がある。
実機テストは実用的な姿を描き出している。GPUなしで空きメモリが1〜2GBしかない共有8GBのLinuxマシンで、ビルドは11分45秒で完了し、llama-serverはモデル読み込みから約1.6秒で待ち受けを開始、OpenAI互換エンドポイントはJSONを返した。生成速度は0.8B〜1Bモデルで毎秒約12〜15トークン、メモリ使用量はQwen3.5-0.8Bで最大約971MiB、Gemma-3-1b-itで937〜960MiBだった。モデルファイルに約400MBのオーバーヘッドを加えた値で、7Bクラスのモデルなら約4〜5GBで8GBのPCに収まる可能性を示すが、テストマシンでは試せなかった。
最も明確な注意点はthinkingモデルのQwen3.5-0.8Bで、トークン予算を推論に費やしてしまう。-n 256ではフランスの首都を問う質問に英語で答えたが、-n 64では尽きた。日本の首都を問う質問では256でも512でも予算を使い切り、同じ文を繰り返して答えなかった。/no_thinkを追加しても推論は止まらず、モデルが指示自体を推論して128トークンの上限に達した。モデルとチャットテンプレートのどちらに問題があるかは特定できず、llama.cpp自身の推論制御(--reasoning-formatなど)は未検証だとしている。
業界と使っているAIツールを選ぶと、仕事に関係するニュースが毎朝届きます。
登録無料・Googleアカウントなら30秒・いつでも解除できますAITodayについて →
この記事についてわからないことをAIに質問できます。AIはこの記事・AIToday の過去記事・Wikipedia を読み、出典を付けて答えます。Q&Aはこのページに公開され、他の読者も読めます。
このようなAIの動きを、御社の業界・競合に合わせて毎日届ける法人プランもあります → 詳しく見る
Microsoftは11月17日から20日までサンフランシスコでIgniteを開催し、CEOのSatya Nadella氏が基調講演を行う
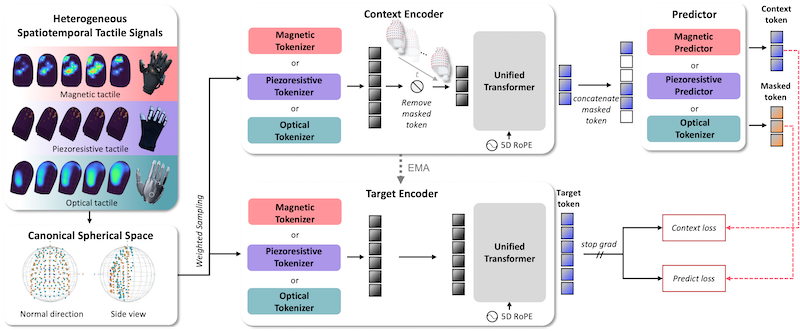
Robbyantは触覚モデルLingBot-Touchを公開した
PostgreSQL 19 RC2が11月12日に公開された
11月12日、Googleは日常的なコーディングと多段階のエージェントタスク向けにGemini 4 Hydrogenを発表し、GeminiアプリとGoogle検索での展開を開始した
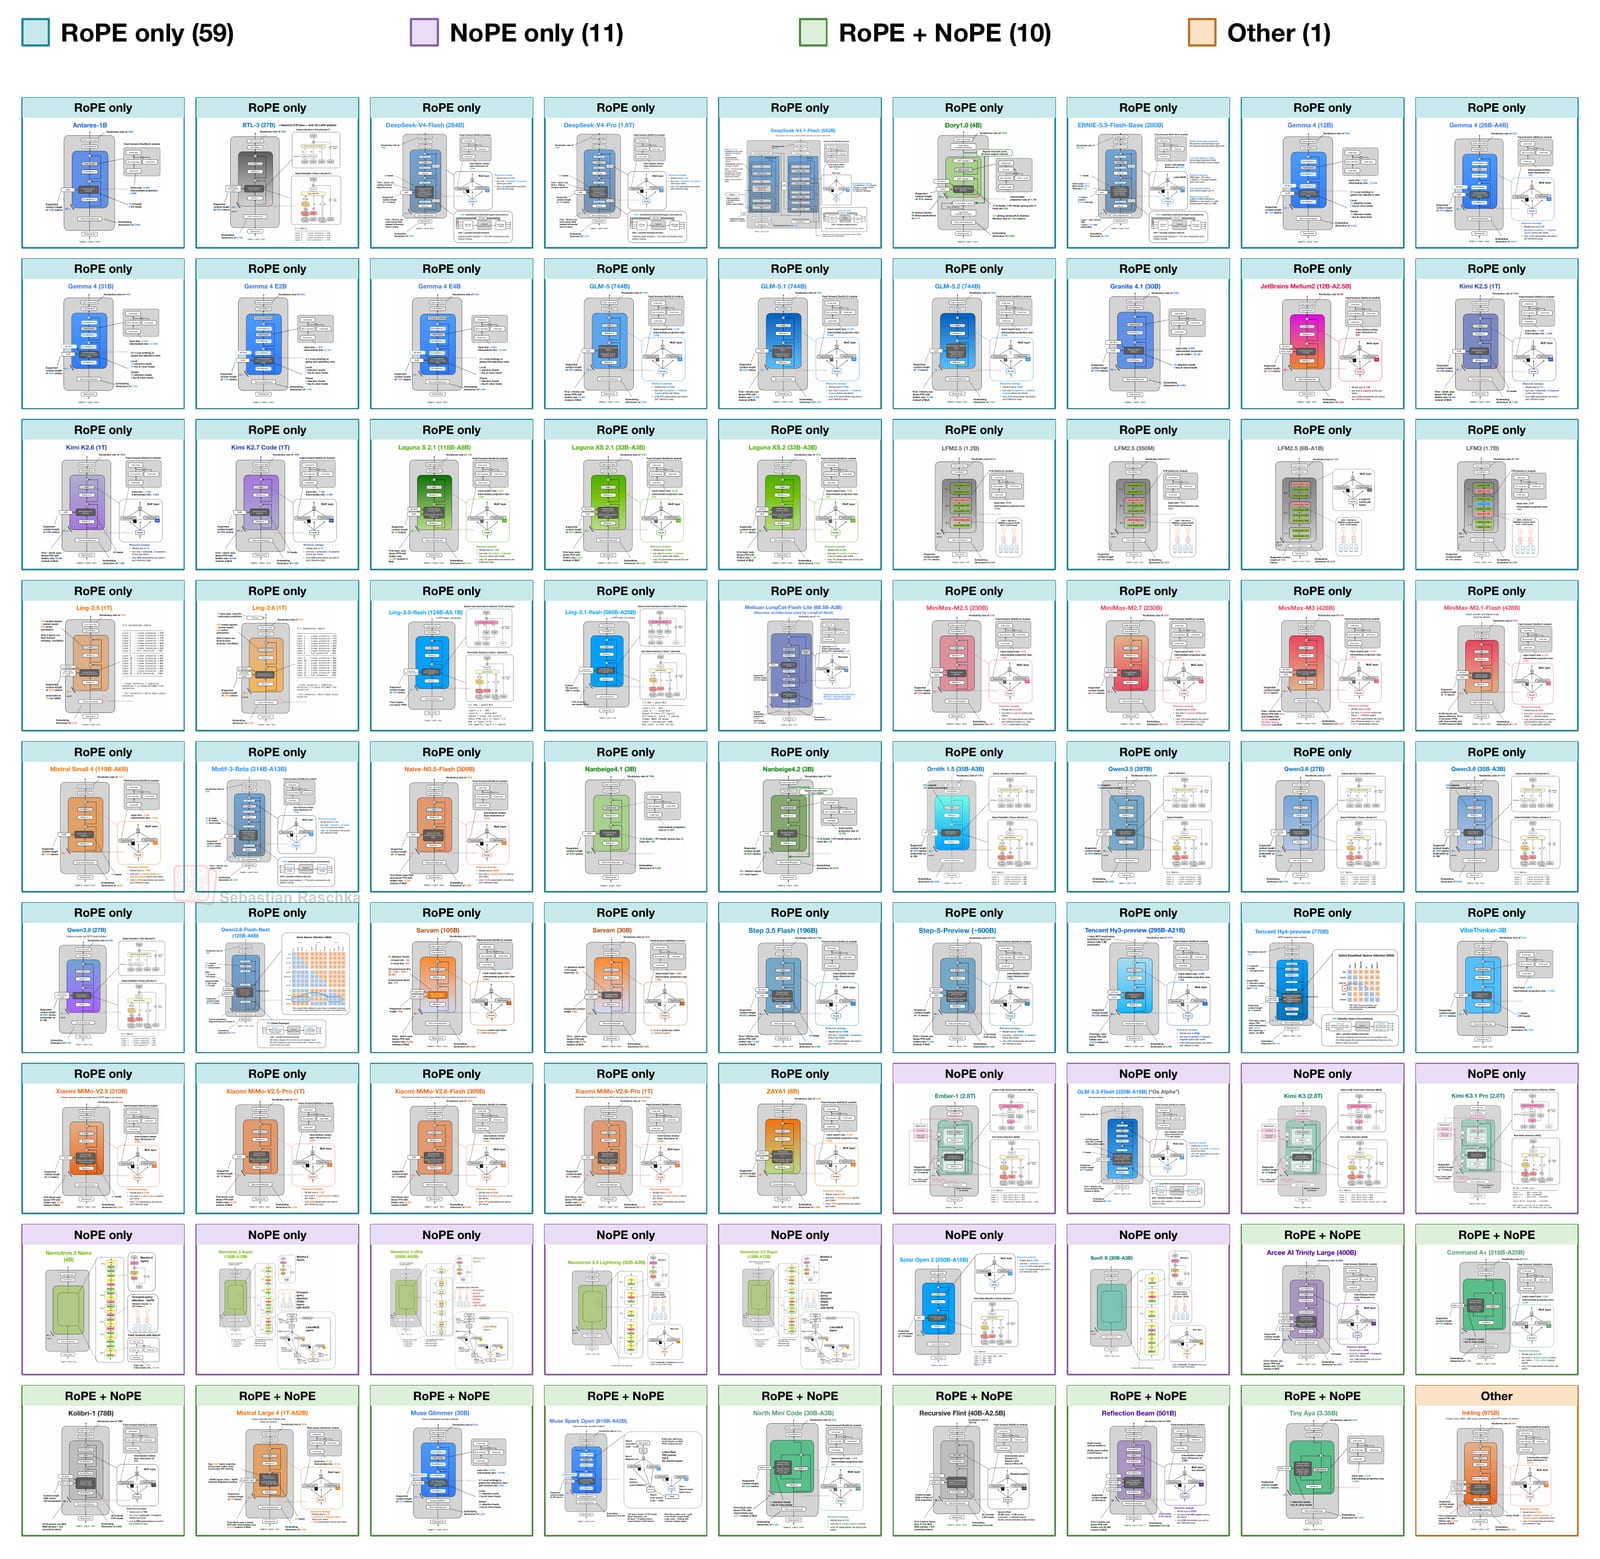
Sebastian Raschka氏がLLMの位置埋め込みを解説
Daehwa Kim氏がACMシンポジウムでOATsを発表