何が起きたか
Prism ML Inc.がBonsai 2 27Bを公開。Qwen3.8 27Bベースのモデルを約56ギガバイトから約5.9ギガバイトに圧縮し、能力の約98.2%を維持する。
なぜ重要か
サイズを大幅に縮めながら元の能力の大半を保つと主張。データをクラウドに送らず、高性能AIをローカルで動かせる可能性がある。
注目点
優位性はテストスコアだけでなく実タスクでベンチマーク並みの性能が保てるかにかかる。元モデルに対するエージェントとツール呼び出しの3ポイント差に注目。
誰に効くかプライバシー重視のタスク向けにオンデバイスAIを検討する企業ITチームや、ローカルアプリを開発する開発者にとって、データを第三者のクラウドサービスに送らずに済むより小さな選択肢となり得る。
こういう要約が、毎朝あなたのメールに届きます。
Prism ML Inc.のBonsai 2 27Bは、高性能モデルを民生ハードウェアに詰め込む第2世代の試みとして登場した。同社は三値圧縮を用い、モデルの重みを16ビットから+1、0、-1で表す3ビットに簡素化することで、はるかに小さなメモリfootprintで情報を保存できるようにした。記事は、量子化と呼ばれる他の圧縮手法は通常、精度や知識などの能力を削ぎ落とすこと、Qwen3.8の最小メモリfootprintが9.4ギガバイトであることに言及している。
ベンチマークでは、Bonsai 2はエージェントとツール呼び出しでQwen3.8に3ポイント以内と迫り、それぞれ77.6と79.8だった。コーディングでは81.6と82.2、知識と推論では82.7と81.3を記録した。同社によると、このモデルはトークンあたり0.714メガワット時と極めて低消費電力で、完全精度で動作する他の8Bモデルより40%エネルギー効率が高いという。
超小型モデルの魅力は、推論をクラウドに送らずにAIをローカルで動かせる点にある。クラウドは遅延を招いたり、機密情報を第三者に露出したりする恐れがある。Bonsai 2 27Bが一般ユーザーや企業にとってその約束を果たせるかは、ベンチマークでの互角さが実タスクでどこまで通用するか、そして対象とするローカルハードウェアがユーザーが実際に気にするワークロードを処理できるかにかかっている。
たとえば、いま届くならこの3本です
AIが要約して、あなたの選んだトピックだけを1日1通。LINE・Email・Slackで届きます。
登録無料・Googleアカウントなら30秒・いつでも解除できますAITodayについて →
この記事についてわからないことをAIに質問できます。Q&Aはこのページに公開され、他の読者も読めます。
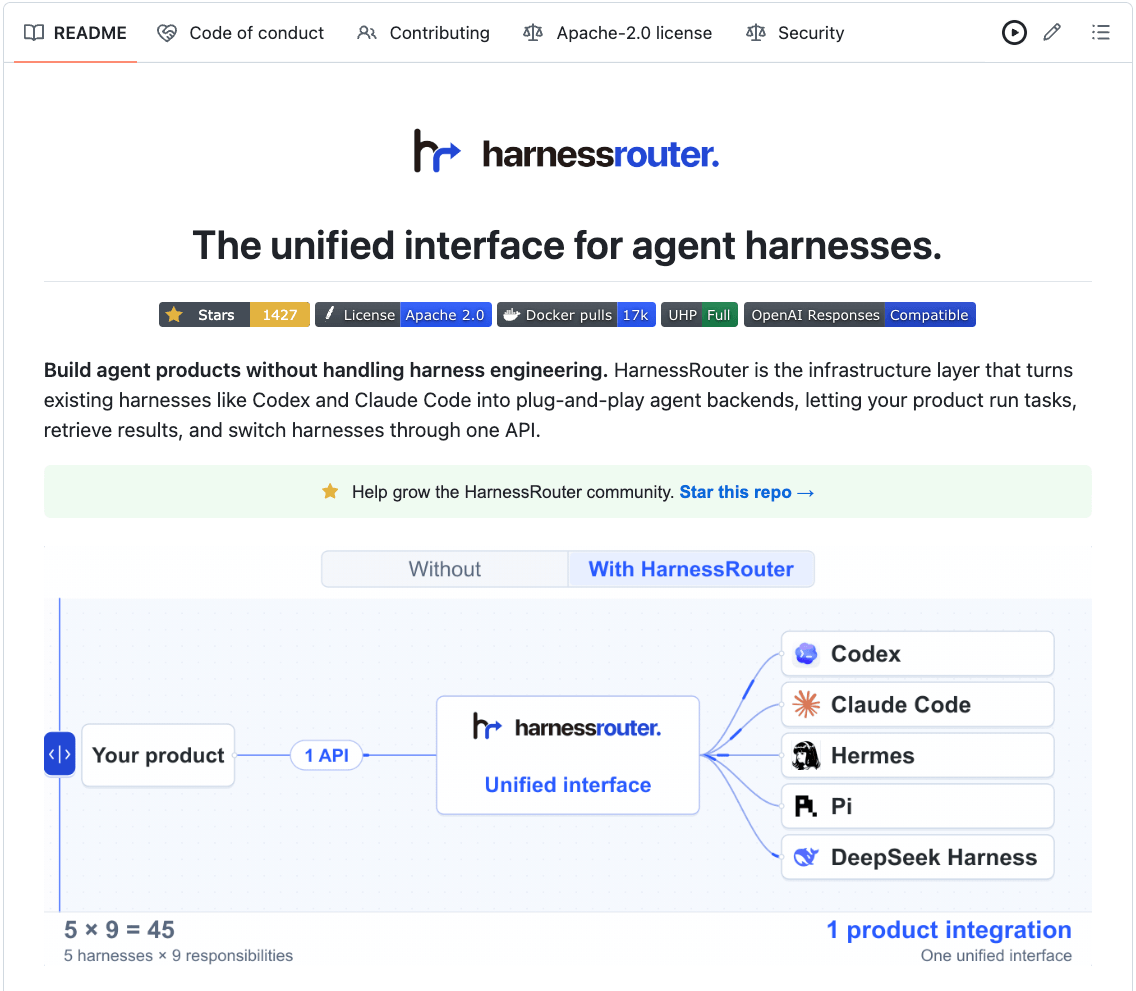
Unified Harness Protocolのオープンソース実装HarnessRouterがCodexとClaude Codeを単一のResponses形式APIで実行
DisneyはCharacter.AI元CEOのKarandeep Anand氏を初のCTOに任命
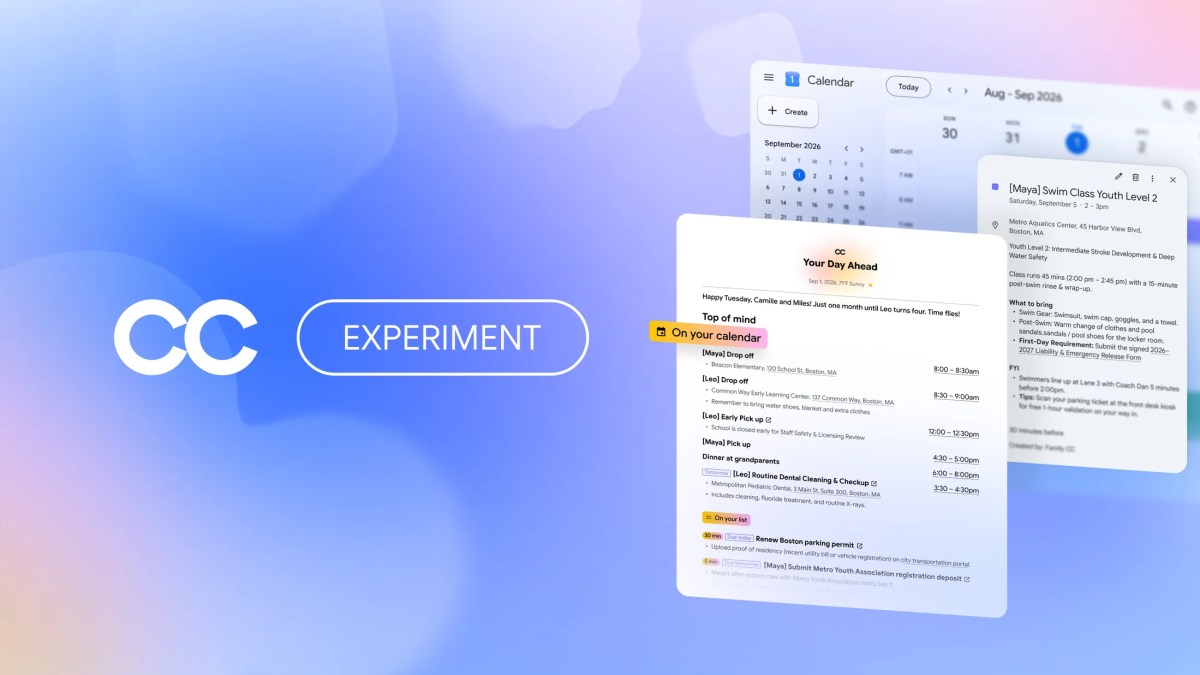
GoogleはCC AIエージェントの新版を発表し、仕事の生産性ツールから家庭の調整役へと方向転換した
Moonshot AIのKimi K3がAmazon Bedrockで利用可能に
KDEの年次会議Akademyが9月19日からGraz University of Technologyで開幕し、Eva BrucherseiferとJan Muehligが「Kadai」構想を発表する
Meta Platformsの株価は過去1カ月で24.34%上昇した