何が起きたか
MicroLLM labが、135Mパラメータモデルを含む小型LLMを客観的チェックで評価するブラウザツールとして登場。速度はtokens/s、精度は合格率で報告し、数値はすべてローカルに保持される。
なぜ重要か
失敗そのものを測定結果として扱う点が特徴で、135Mモデルの失敗も許容される。文章品質ではなく客観的チェックを用いるため、結果の比較が可能になる。
注目点
実行はユーザーのブラウザとハードウェアに限定されるため、端末をまたいだスコアの直接比較はできない。利用時にどのモデルと客観テストが選ばれるかに注目。
誰に効くか小型モデルを自分のノートPCで評価する開発者やAI愛好家は、データを端末外に送らずに客観的ベンチマークを実行できる。結果は各ユーザーのブラウザとハードウェアに依存するため、マシン間の比較には限界がある。
こういう要約が、毎朝あなたのメールに届きます。
MicroLLM labは、文章品質でモデルを評価するベンチマークスイートに対する、ブラウザベースの代替として登場した。チェックが客観的、つまり正規表現か完全一致トークンであるため、135Mモデルがチェックに失敗しても問題ではない。失敗こそがこのツールが生み出す測定結果なのだ。ツールは速度と精度を分けて扱う。速度は持続デコードのtokens/sとスイートの実時間、精度は客観テストの合格率で報告し、グラフには各モデルの最新スイートを用いる。
またユーザーはJavaScriptで独自のベンチマークを書くこともできる。エディタはページオリジン内でeval()され、各チェックはモデルがデコードしたテキストに対して実行される。より大きなLLMにプロンプトを送るオプションもあり、読者の直近のtok/s値があればそれを使った推定も行う。
最大の制約は結果が端末内に留まることだ。データをローカルに保てる一方、スコアは各ユーザーのブラウザとハードウェアに左右される。このツールがどれだけ有用かは、客観的チェックが共通の基準点になるかどうか、そしてユーザーがどのモデルを試すかにかかっている。
業界と使っているAIツールを選ぶと、毎朝7時に仕事に関係するニュースが届きます。
登録無料・Googleアカウントなら30秒・いつでも解除できますAITodayについて →
この記事についてわからないことをAIに質問できます。AIはこの記事・AIToday の過去記事・Wikipedia を読み、出典を付けて答えます。Q&Aはこのページに公開され、他の読者も読めます。
Anthropicは2026年9月29日公表のレビューで、Z.aiのGLM-5.3がExploitBenchの410回中50回でエクスプロイトを構築したと報告
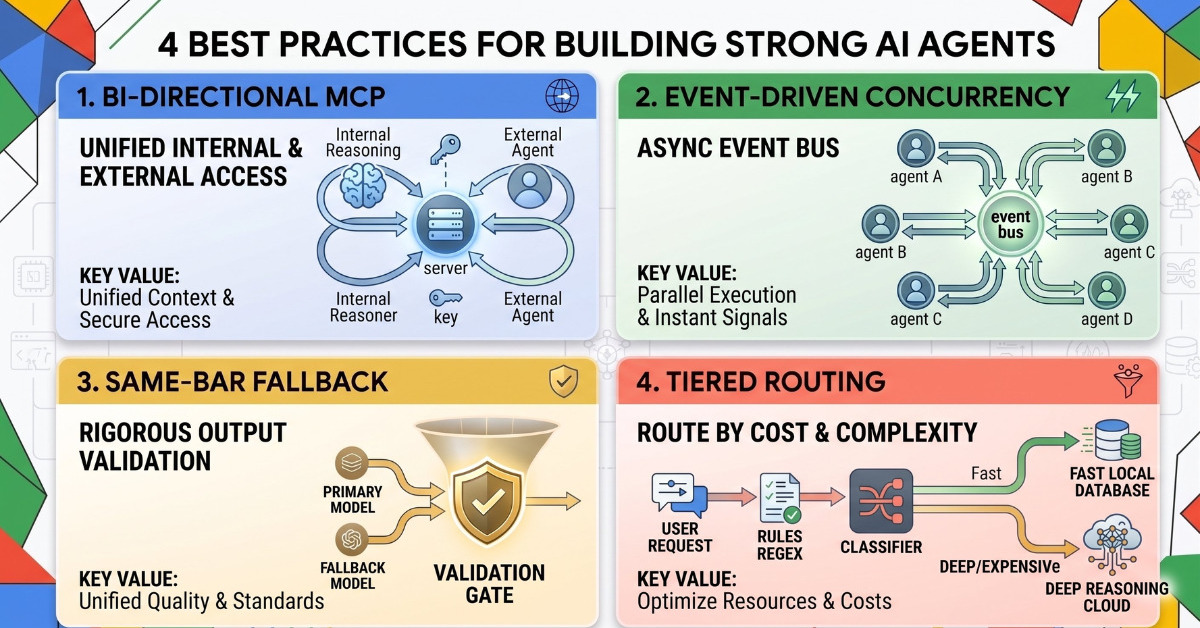
Googleは「Google for Startups AI Agents Challenge」の上位応募作から4つの設計パターンを公開
OpenAIが「Codex CLI」を刷新し、全画面インターフェースや「/agents」「/fork」コマンドを追加した
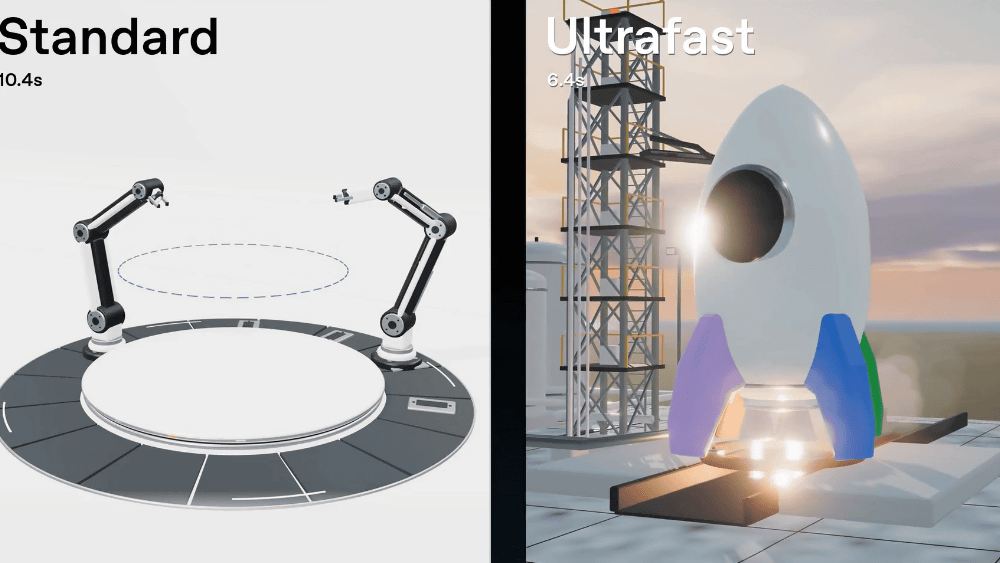
OpenAIはUltrafastを本日よりCodex、ChatGPT Work、APIのGPT-6 Astraで提供開始
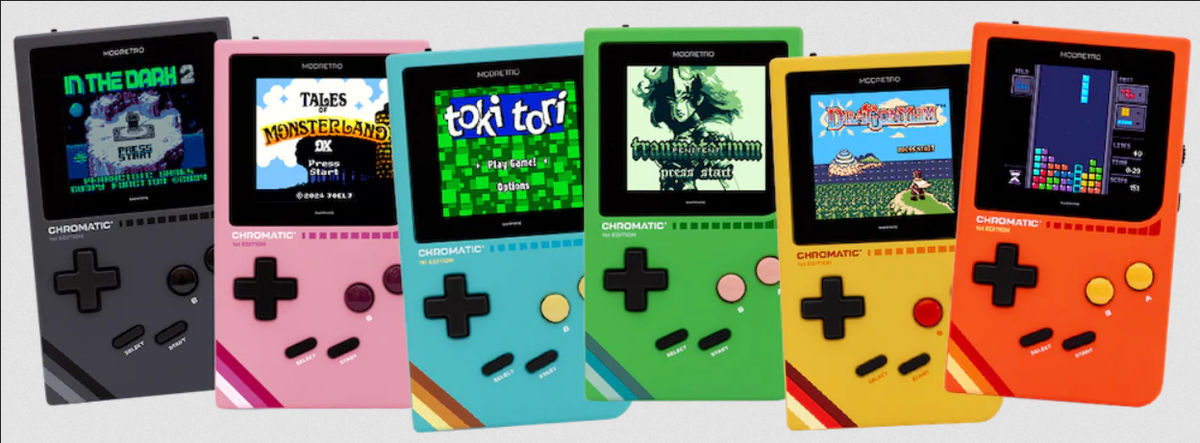
OpenAI DevDay 2026でOpenAIは、ModRetroの携帯機Chromatic向けのCodexプラグインを発表した
cmux(バージョン0.64.25)ではNODE_OPTIONSにcmuxのプリロードファイルが含まれ、消えるとnodeが起動せずnpx wranglerやカスタムnodeスクリプトが壊れる


