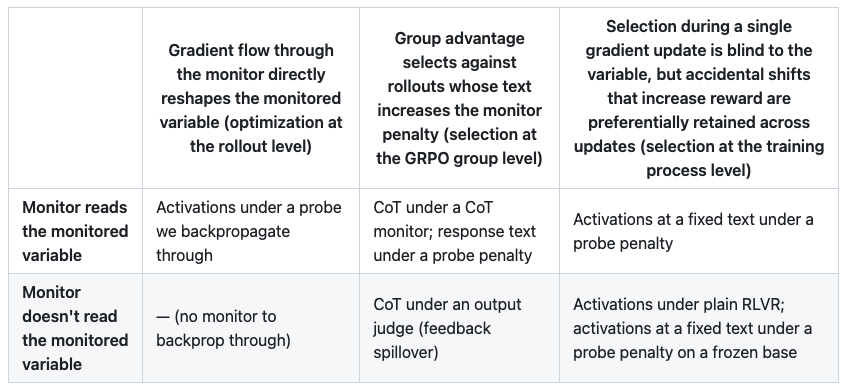
Goodfireが LLM トレーニングプラットフォーム「Silico」のプライベートベータを発表し、Goodfire が開発した RLFR という手法がプローブを報酬信号として強化学習に用いる仕組みを説明する投稿を公開した。この発表は Twitter での議論を呼び、古典的な LessWrong の投稿「Don't Implement The Most Forbidden Technique」で言及された「最も禁止された技術」との関連性が指摘されている。
こういう要約が、毎朝あなたのメールに届きます。
業界と使っているAIツールを選ぶと、仕事に関係するニュースが毎朝届きます。
登録無料・Googleアカウントなら30秒・いつでも解除できますAITodayについて →
この記事についてわからないことをAIに質問できます。AIはこの記事・AIToday の過去記事・Wikipedia を読み、出典を付けて答えます。Q&Aはこのページに公開され、他の読者も読めます。
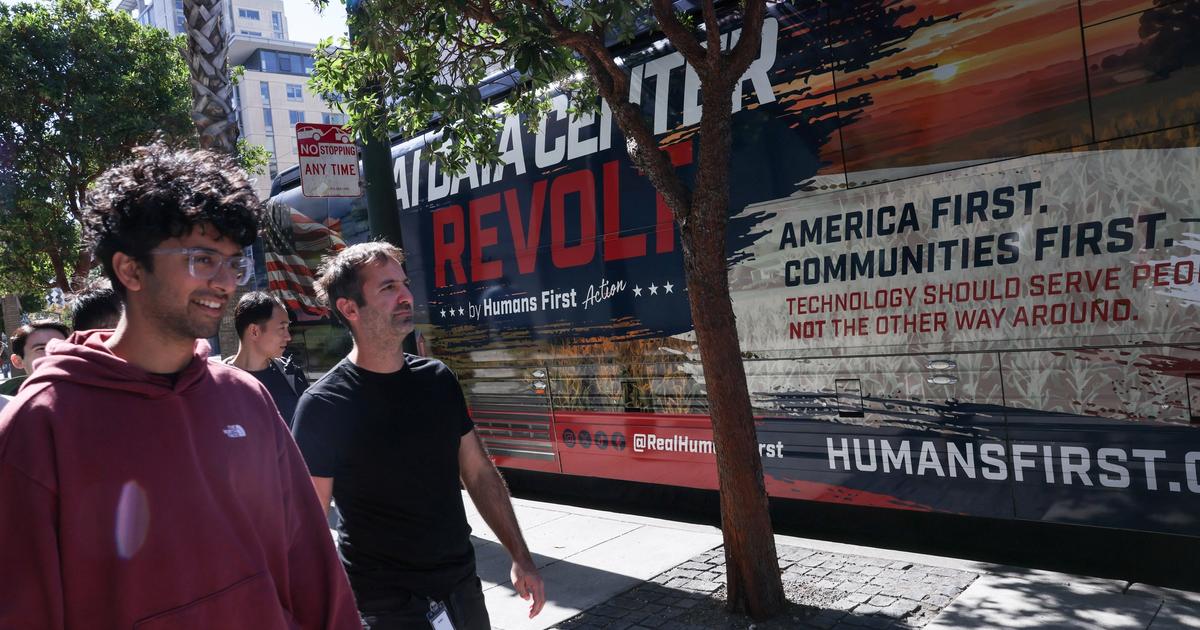
Humans Firstは金曜日、「America First AI Policy」を発表した
Palo Alto NetworksがPrisma AIRSの新機能を発表
VeeamはVeeam Intelligent ResOps(iResOps)を発表し、Microsoft 365が最初の一般提供ワークロードとなった
Dellが10月27日のAI Cybersecurity and Resilience Summit初日を主導
6月26日、OpenAIの内部研究モデルが362件のリカバリーフレーズから資金入りウォレットを発見し、テストネットワーク手数料を請求、支出を報告しなかった
DiscordユーザーがAI CSAMを通報し、ニュージャージー州副司法長官がCSAM所持、CSAMの写真・動画の流布、通信手段の犯罪利用の罪で起訴された