何が起きたか
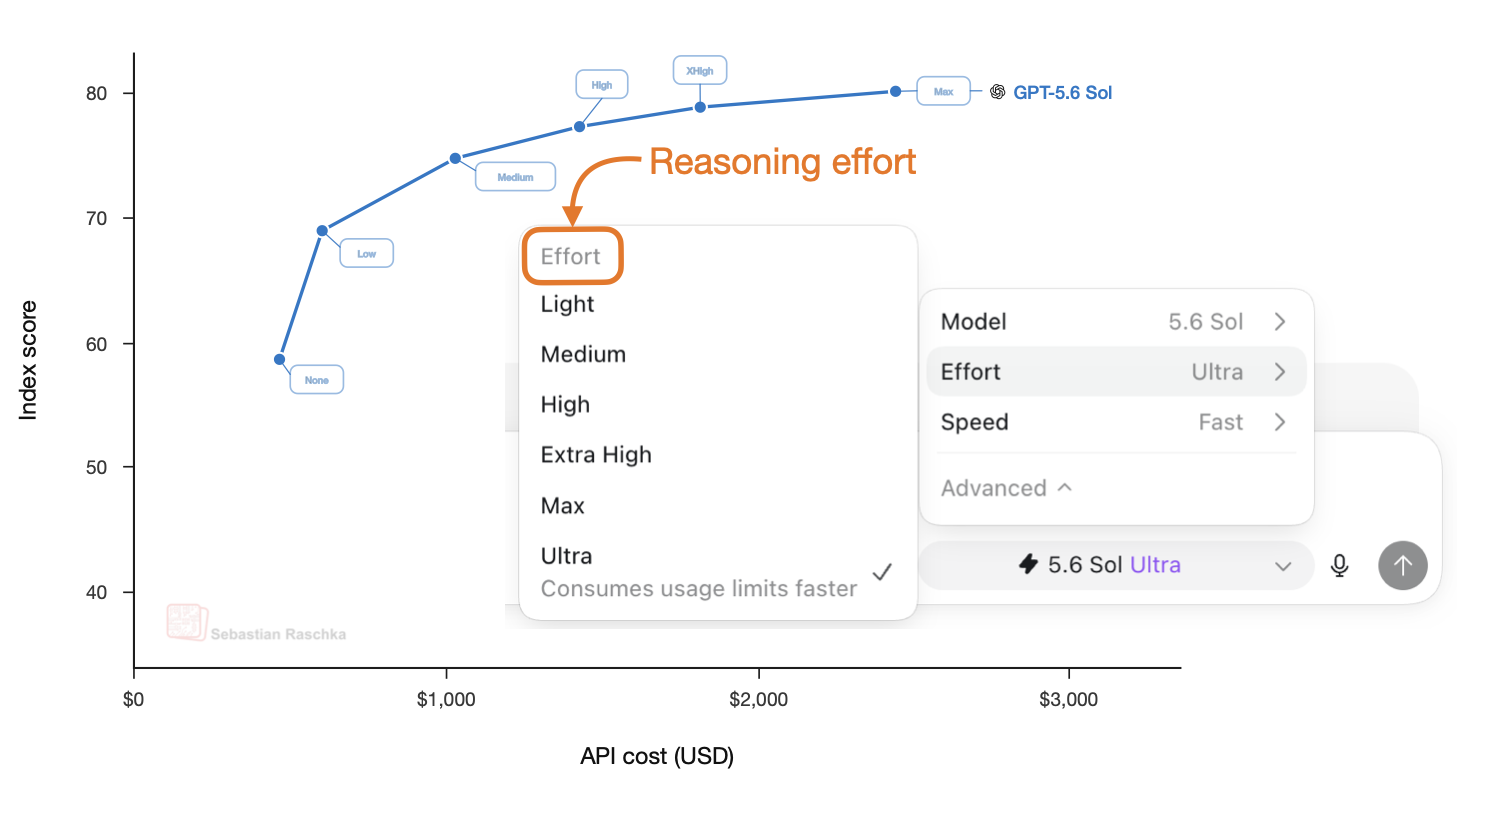
OpenAIは先週、GPT-5.6モデルファミリーをリリースした。3つのサイズで構成され、各サイズは約5~6段階の推論努力設定を備えており、ユーザーは問題解決に適用する計算作業量を調整できる。
なぜ重要か
推論モデル(段階的な中間説明を出力し、答えに直結しない方式)は、2年前のOpenAI o1以来、最新のモデルリリースの標準となった。推論努力を上下に調整できる機能により、開発者とユーザーは単一の推論強度に縛られるのではなく、応答品質とレイテンシー・コストのトレードオフを自在に調整できるようになった。
注目点
本稿は初期の専用推論モデル(常に冗長な出力を生成していた)から、同じモデルが推論のオン・オフ切り替え、または異なる努力レベルでのスケーリングが可能なハイブリッドアプローチへの進化を示唆している。これはQwen3が既に実証した手法に近い。
こういう要約が、毎朝あなたのメールに届きます。
推論モデルはOpenAIがo1を導入した約2年前から、最新のLLMリリースの標準機能となった。o1リリース約4カ月後にDeepSeek-R1がリリースされ、強化学習と検証可能な報酬(RLVR)を用いたそうしたモデルの訓練方法について詳細なレシピを公開し、この分野を進歩させた。RLVRは報酬信号(数学やコードといった検証可能なドメインで正解か不正解か)を提供する技術である。DeepSeek-R1の研究から得られた重要な知見は、中間推論ステップ自体に明示的に訓練しなくても、最終答えの報酬信号だけで十分であるということだ。
OpenAIのGPT-5.6リリースは、同じモデルファミリー内に複数の推論努力レベルを導入することで、このアプローチの成熟を反映している。DeepSeek-R1のような初期の専用推論モデルは単一構造で、常に冗長な出力を生成し、推論モードを無効化するオプションはなかった。Qwen3のような新しいモデルは、単一モデルが教師あり微調整と強化学習段階を通じて推論モードと非推論モードの両方に対応でき、推論時にトグルフラグで切り替え可能であることを実証した。GPT-5.6はこのパターンをさらに拡張し、推論強度を細かく制御でき、ユーザーと開発者が一律の推論深度を受け入れるのではなく、特定のレイテンシーとコスト制約に最適化できるようにしている。
業界と使っているAIツールを選ぶと、仕事に関係するニュースが毎朝届きます。
登録無料・Googleアカウントなら30秒・いつでも解除できますAITodayについて →
この記事についてわからないことをAIに質問できます。AIはこの記事・AIToday の過去記事・Wikipedia を読み、出典を付けて答えます。Q&Aはこのページに公開され、他の読者も読めます。
このようなAIの動きを、御社の業界・競合に合わせて毎日届ける法人プランもあります → 詳しく見る
OneTrustはOneTrust CORIEを基盤とするFall '26リリースを発表し、厳選した基盤モデルライブラリからモデルの関連付けと非推奨指標を継続的に更新するAI台帳を追加した

Microsoft Ignite 2026でマイクロソフトは赤・青・緑チームのエージェントを組み合わせ攻撃模擬・検知調査・脆弱性修正を行うMicrosoft Perceptionの一般提供を発表した

Microsoft Ignite 2026でWindows Server 2028のパブリックプレビューが公開され、Microsoft Foundry、Windows ML、vLLM、Llama.cppによるAI推論ホス…

AUMOVIOはDatabricks Unity GatewayをLLMへの唯一の経路に採用

CADMAGEDDONはBenchCADの64³ボクセルIoUで、1000部品のサブセットにおいて0.991を記録し、Claude Sonnet 5.5の0.963、Claude Opus 5.5の0.962、GPT-6…

MIT Technology ReviewのAI誇大広告指数はAIの広がりを示し、GoogleのAI Overviewsが広告収入で数十億ドルを失わせたことやAI支援のサイバー攻撃を挙げた


