何が起きたか
NVIDIAは日本の大手金融機関の協力を得て構築したNemotron Personas Finance JapanとNemotron PII JapanをHugging Faceで公開した。
なぜ重要か
合成データにより、実際の個人情報を使わずに日本語AIエージェントを構築でき、金融など機密性の高い分野のプライバシー制約が緩和される。
誰に効くかNVIDIAによると、実在の個人データを容易に利用できない金融、医療、公共部門などの日本のAI開発者は、代わりに合成記録でエージェントを学習・評価できる。
こういう要約が、毎朝あなたのメールに届きます。
NVIDIAはこれらのデータセットを、精度と計算効率のバランスを取りながらAIエージェントを低コストで構築・導入するためのシステムNemotronの一環と位置付ける。今回の公開は実務上の障害に対応するものだ。AIエージェントは国の言語や文化、人口動態、業界事情を反映する必要があるが、個人データはプライバシーやセキュリティ上の懸念から、特に金融、医療、公共部門では入手・利用・共有が難しい。
Nemotron Personas Finance JapanはNemotron Personas Japanを基に、基本的な属性と個人の文脈を保ちつつ、収入や資産といった金融特有の特性を加え、支出や貯蓄、投資、金融に関する意思決定をより現実的かつ多様に表現できるようにする。NVIDIAによると、2025年に公表された公開の人口・労働統計を基にしており、日本の大手金融機関の協力を得て作成された。
Nemotron PII Japanはそれを補完するもので、個人識別情報がどこにあり、どのカテゴリーに属するかを示す注釈付きの文書を提供する。実在の個人情報を含まずに文書と正しいラベルが揃って提供されるため、検出・マスクモデルの微調整や評価、改善が可能になり、地域や業界の要件を満たす日本語AIエージェントを構築しやすくなる可能性がある。
業界と使っているAIツールを選ぶと、仕事に関係するニュースが毎朝届きます。
登録無料・Googleアカウントなら30秒・いつでも解除できますAITodayについて →
この記事についてわからないことをAIに質問できます。AIはこの記事・AIToday の過去記事・Wikipedia を読み、出典を付けて答えます。Q&Aはこのページに公開され、他の読者も読めます。
このようなAIの動きを、御社の業界・競合に合わせて毎日届ける法人プランもあります → 詳しく見る
Bay AI Inc.が5000万ドルで始動した
Cyanogen共同創業者のKirt McMaster氏率いるKora Systemsが、アプリ間でAIモデルと自律エージェントを動作させるLinuxベースのデスクトップOSを発表
AnthropicはクラスA株8億2500万株を1株70〜78ドルで売り出し、577億5000万〜643億5000万ドルを調達する
GoogleはAMDと共同開発し機密トレーニングと推論向けのTPU 8txと、TPU 8iを2つ組み合わせて単一パッケージでメモリ・処理能力・帯域幅を2倍にしたTPU 8i Maxを発表した
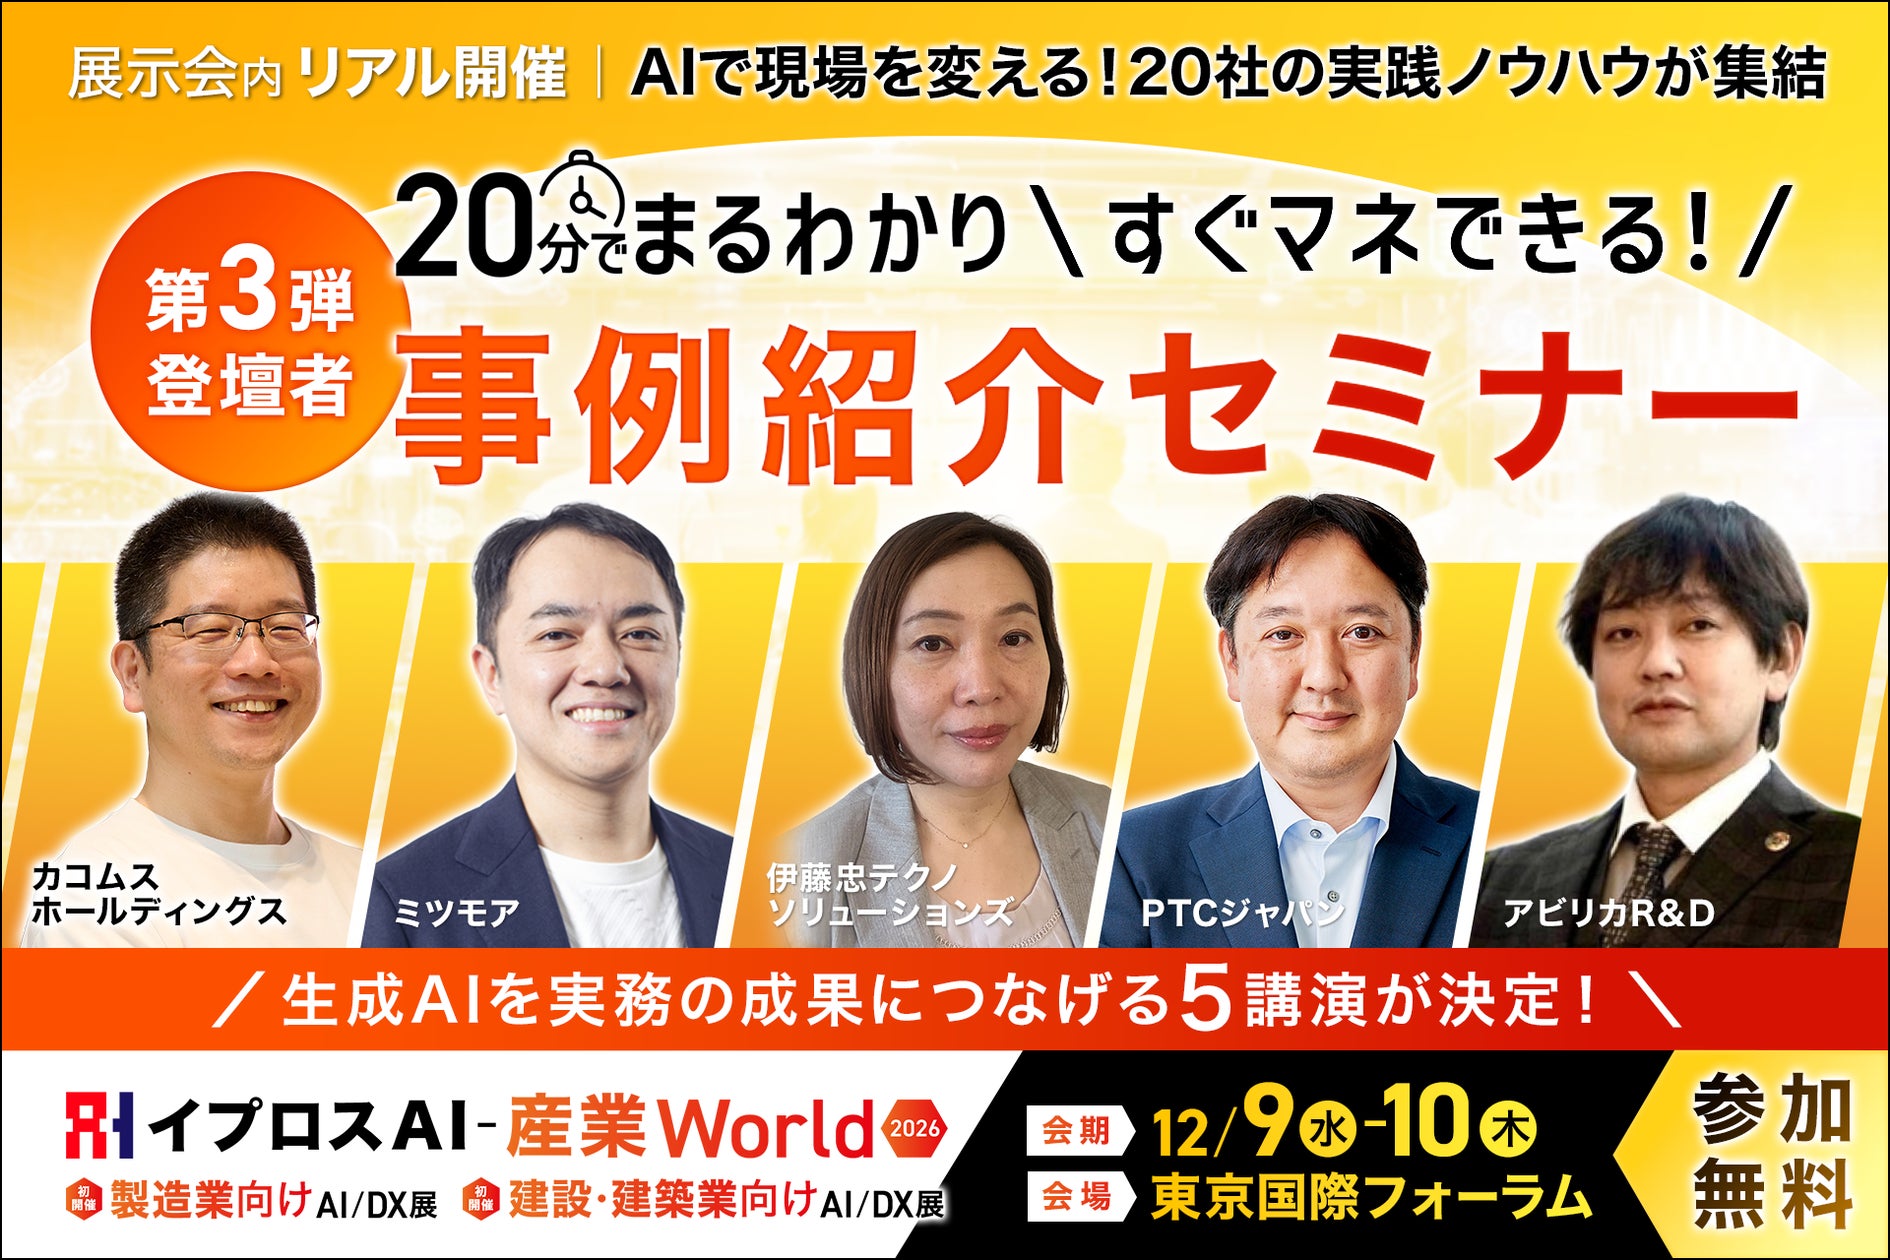
IPROSはAI-Industry World 2026で20分の無料セッション5本を発表
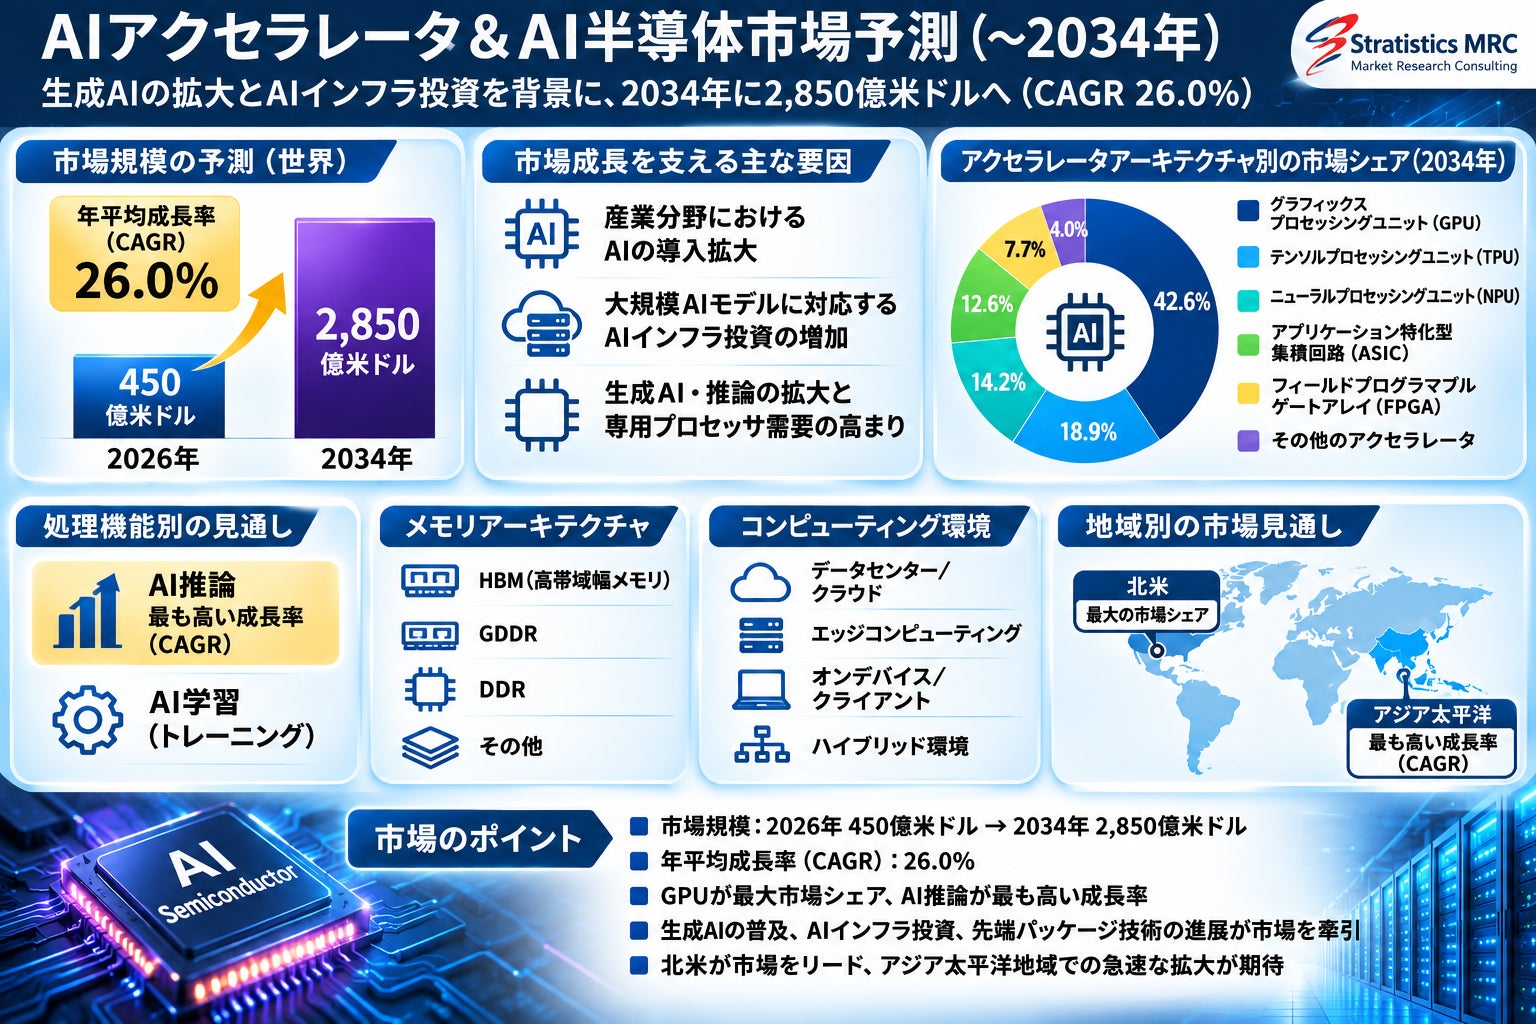
Stratistics MRCは、AIアクセラレータ・AI半導体市場が2026年の450億ドルから2034年に2850億ドルへ拡大すると予測