何が起きたか
DeepgramとAWS Forward Deployed EngineeringチームがNova-3をAWS Trainium2へ移植し、trn2.3xlarge上で8つのモデルレプリカを稼働させた。
なぜ重要か
コンタクトセンター分析や医療文字起こしといったオフラインのバッチ処理では、この構成が従来のコンピュート選択肢より1ドル当たり11〜70%多く音声を処理できる。
誰に効くかDeepgramのエンジニアリングチームとインフラチームは、大容量バッチ文字起こしのためのよりコスト効率の高い手段を手に入れる。Amazon SageMaker AI上の自社VPCでDeepgramモデルをセルフホストする組織も、同様のセットアップと信頼性の改善を得られる可能性がある。
こういう要約が、毎朝あなたのメールに届きます。
Deepgramのモデルは年間数京規模の音声トークンを、20万人超の開発者と1,400組織のために処理しており、配信効率がそのまま、一定のインフラ予算で扱える音声量を決める。大容量のバッチワークロードはこの予算に重い負荷をかけるため、推論効率は当然の改善対象となる。移植作業はNova-3を標準的なPyTorchコードとして出発点にし、AWS Neuronスタックを通じてAWS Trainium2へ移行。公開NKIライブラリによるレイヤー単位のカーネル置き換えと、バッチサイズ32超を可能にする手書きのconv2dカーネルを採用した。データ並列のRustランタイムは配信経路からPythonとPyTorchを排除し、参照トークン列を正確に再現しつつスループットを改善した。単一のtrn2.3xlargeインスタンスで測定された価格性能の向上は、AWS TrainiumがDeepgramの推論ワークロードにとって有力な選択肢であることを裏付けており、その利点はAmazon SageMaker AI上のセルフホスト導入にも及ぶ可能性がある。
業界と使っているAIツールを選ぶと、仕事に関係するニュースが毎朝届きます。
登録無料・Googleアカウントなら30秒・いつでも解除できますAITodayについて →
この記事についてわからないことをAIに質問できます。AIはこの記事・AIToday の過去記事・Wikipedia を読み、出典を付けて答えます。Q&Aはこのページに公開され、他の読者も読めます。
NTTデータとNTTデータ東海が10月26日、あいち銀行と共同で実証を開始
VertivとNVIDIAは14日導入目標のモジュール式AIファクトリー参照設計「DSX POD」を発表
IBMのQ3売上高は171億ドル(前年比5.9%増)、調整後EPSは2.95ドルと市場予想を上回り、時間外で一時7.3%高となった
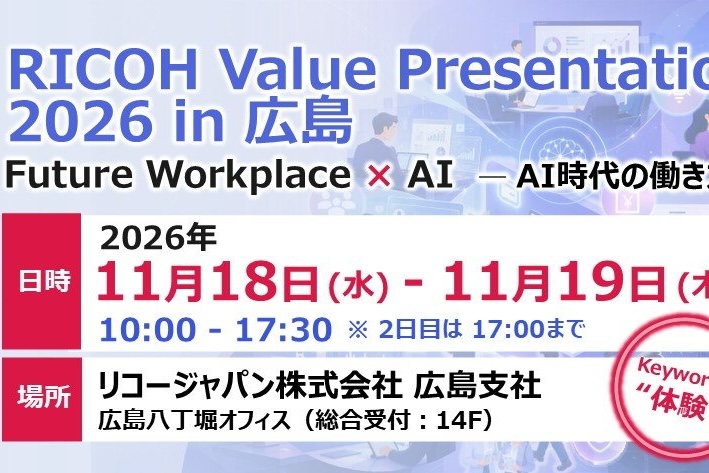
リコージャパンが11月18日・19日、広島八丁堀オフィスで「RICOH Value Presentation 2026 in 広島」を開催
GoogleとOpenAIはGPT-6 Astra、GPT-6.1 Sol、GPT-6 LunaをModel Garden経由で提供し、一部顧客向けプレビューを開始した
OpenAIがChatGPT広告を26カ国へ広げ、世界89市場に拡大