何が起きたか
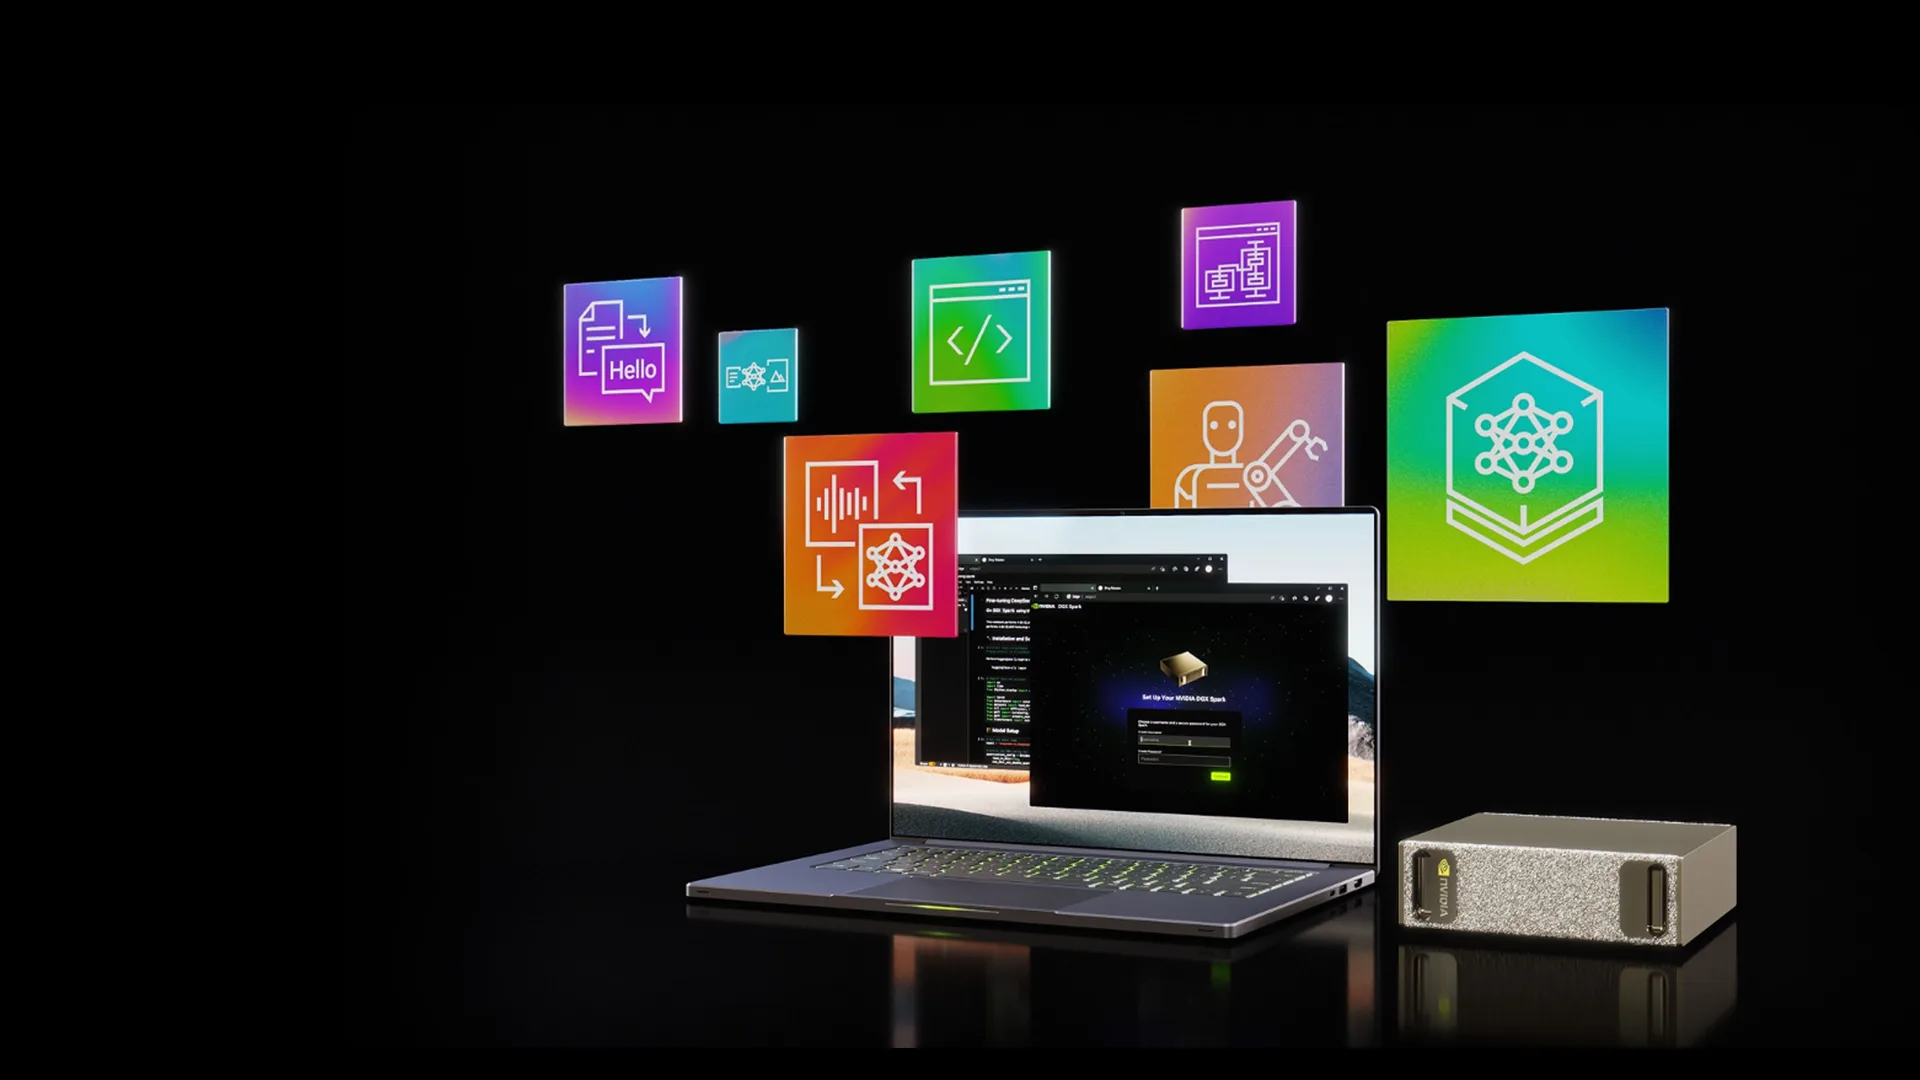
NVIDIAがDIN Deployを公開。ONNX RuntimeとTensorRT RTX実行プロバイダーを組み合わせたオープンソースC++サンプルで、WindowsとLinuxに対応する。
なぜ重要か
開発者は共有コードパスを使え、ベンダー固有のCUDAコードはオプションの高速化パスに限定される。必要なテンソルAPIに対応するシステムなら同じサンプルが動く。
注目点
ONNX RuntimeのテンソルAPI対応は実行プロバイダー次第だ。DGX Sparkに注目。whisper-large-v3-turboはGPUで実時間の58.5倍、CPUで3.8倍だった。
こういう要約が、毎朝あなたのメールに届きます。
DIN Deployは、NVIDIA自身が説明するギャップを埋めることを狙っている。AIモデルをローカルアプリケーションに追加するには、ポータブルなモデル形式、信頼できるランタイム、対象システム全体で動作する高速化が必要だ。このコレクションは、各サンプルを、モデルチェックポイントをONNXアーティファクトに変換するPythonエクスポーターと、ONNX Runtime上に構築されたネイティブC++ CLIに分割することで、この課題に対応している。
リポジトリは複数のタスク種別を同時にカバーする。自動音声認識、画像・動画向けのインタラクティブなマスキング、プロンプト駆動の画像生成だ。DGX Sparkで測定された性能値は、これらのワークロードでGPU高速化がCPUを大きく上回ることを示しており、openai/whisper-large-v3-turboはGPUで実時間の58.5倍、CPUで3.8倍、facebook/sam2.1-hiera-base-plusはGPUで38.3 FPS、CPUで0.5 FPSだった。
これらのサンプルが実用上どれほど役立つかは、実行プロバイダーが必要なONNX RuntimeテンソルAPIに対応しているかどうかにかかってきそうだ。NVIDIAが共有コードの実行条件として挙げているのがまさにこの点だからだ。WindowsとLinux(Arm64版を含む)の開発者は、リポジトリのCMakeプリセットから始められる。プリセットはデフォルトでONNX RuntimeとTensorRT RTXをダウンロードする。
業界と使っているAIツールを選ぶと、仕事に関係するニュースが毎朝届きます。
登録無料・Googleアカウントなら30秒・いつでも解除できますAITodayについて →
この記事についてわからないことをAIに質問できます。AIはこの記事・AIToday の過去記事・Wikipedia を読み、出典を付けて答えます。Q&Aはこのページに公開され、他の読者も読めます。
Time誌によると、2025年12月、トランプ氏はイーロン・マスク氏と秘密会談し、ベネズエラ国民がマドゥロ大統領の捕縛にどう反応するかGrokに何時間も尋ねた
Reutersが提出書類を基に、BroadcomがAnthropicにチップリース用として最大420億ドルを融資すると報じた
Googleは、宇宙にAIデータセンターを置く一歩とされるProject Suncatcherを立ち上げた
アプライド マテリアルズは2026年8月13日、第3四半期に過去最高の売上高を報告し、10月期の見通しは約50%の増収を示唆
イーライリリーのブライアン・ルイス氏がCoreWeaveのFully Connected 2026でLillyPodを詳述
MicronのCEO Sanjay Mehrotraが決算説明会で、自律走行車が200ギガバイト超のメモリと複数テラバイトのストレージを必要とし、人間型ロボットも同程度の要件になると述べた