何が起きたか
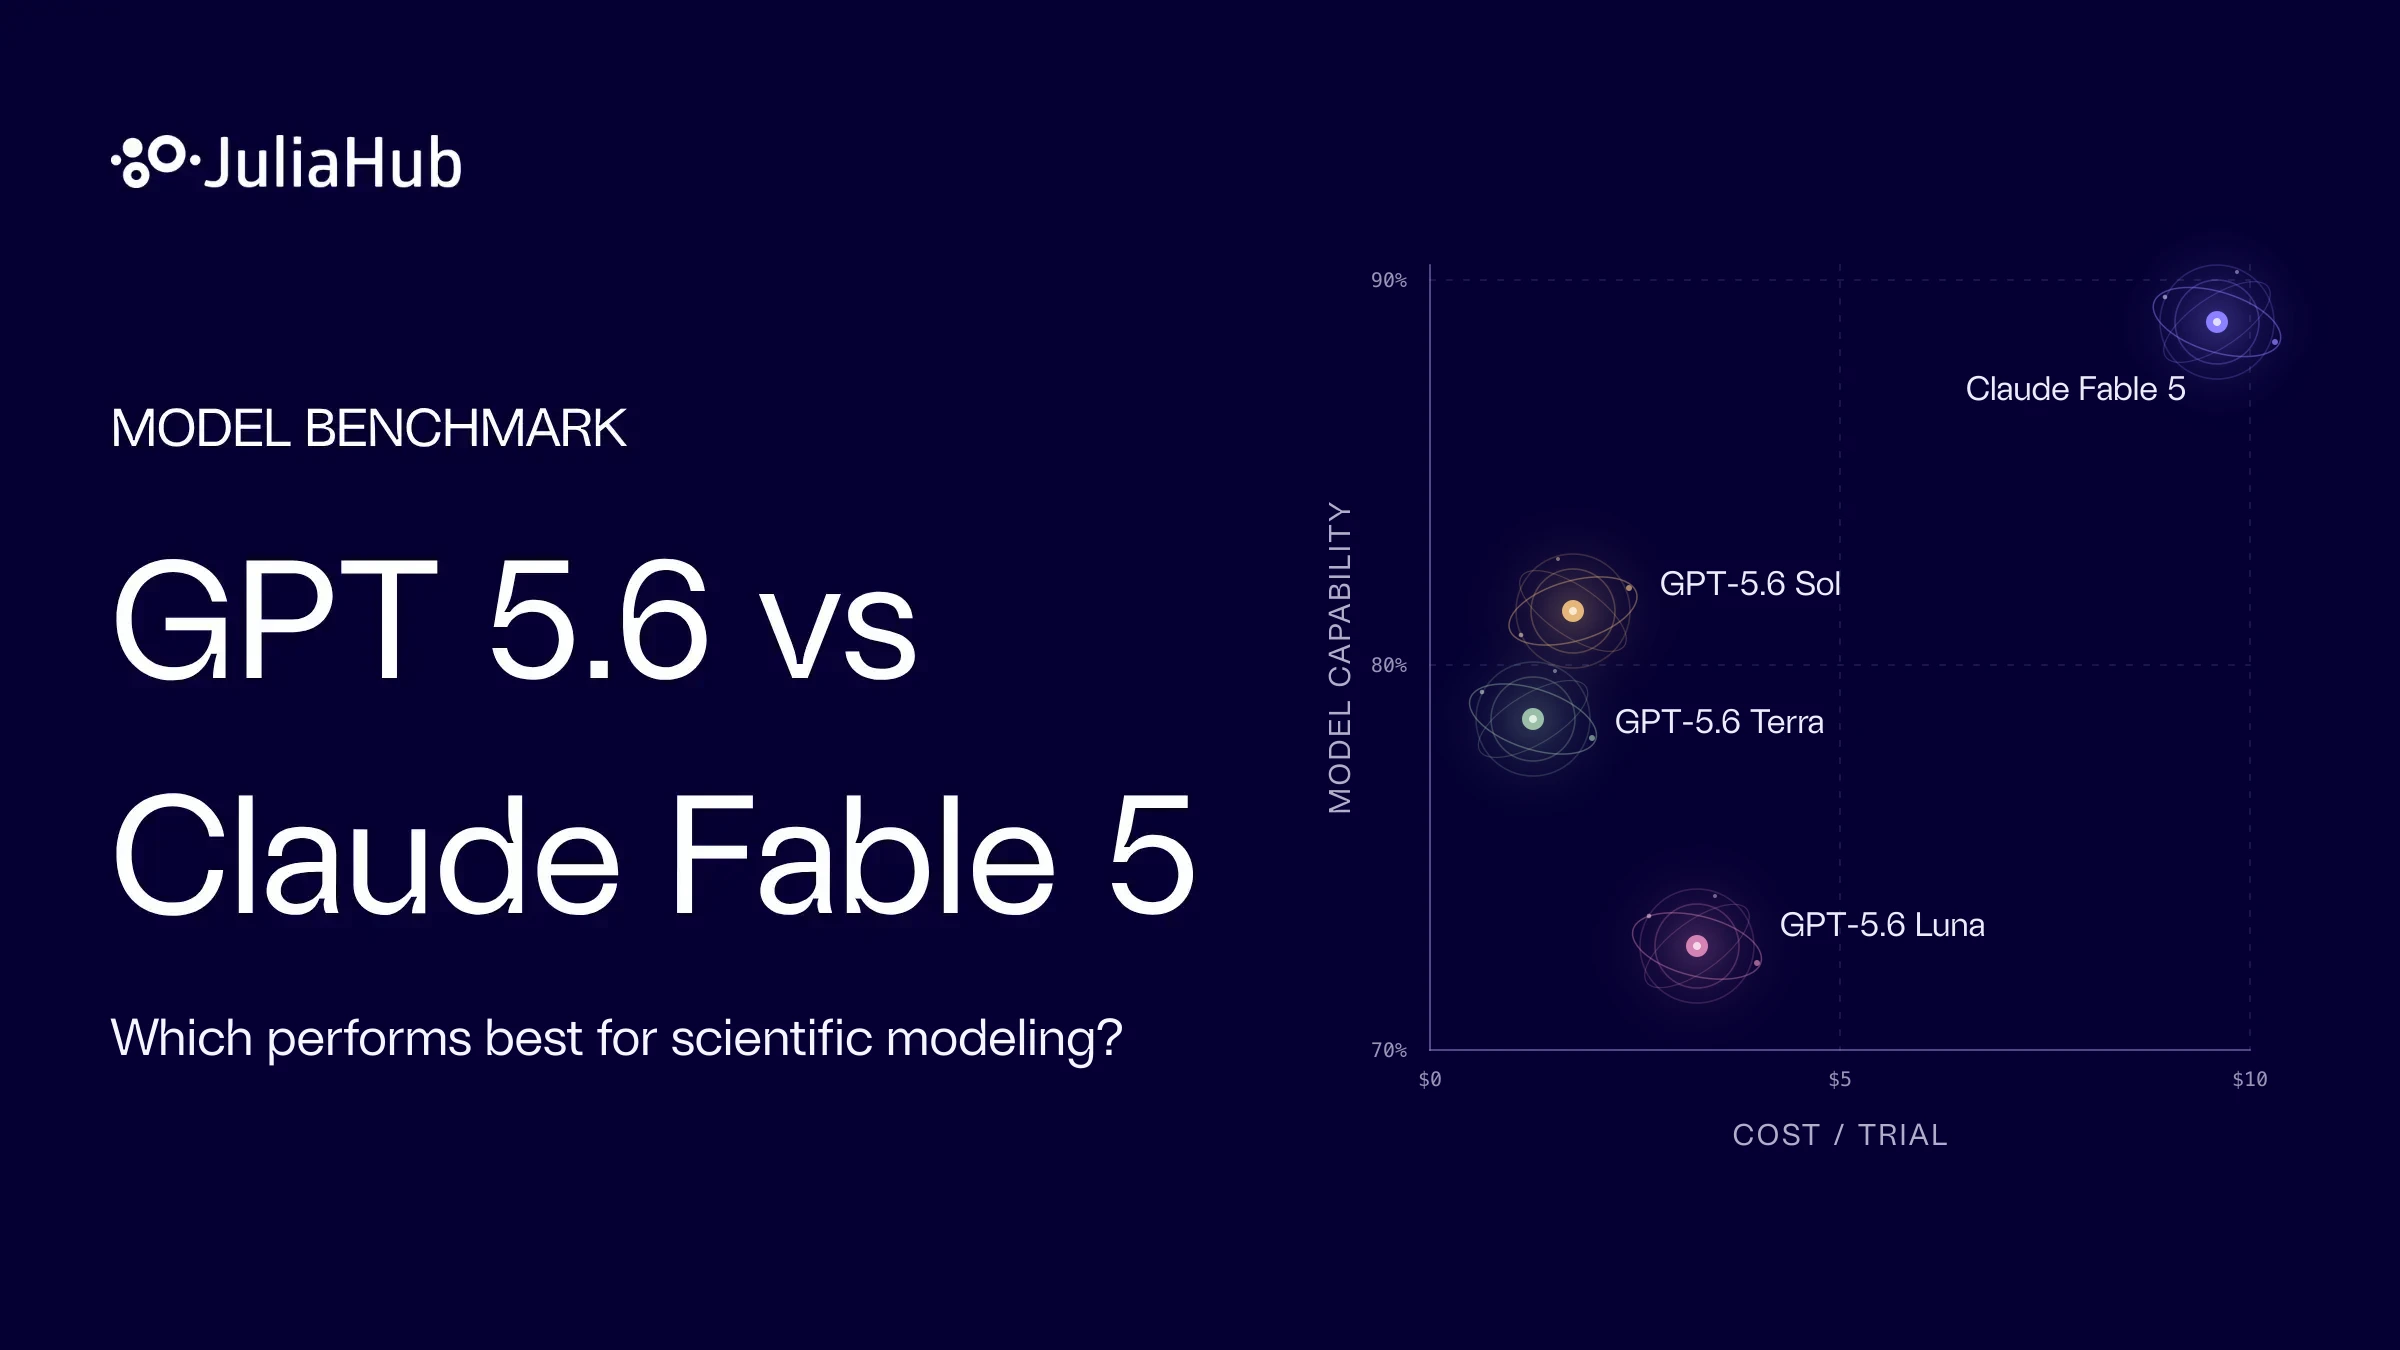
JuliaBubはClaude Fable 5、GPT-5.6-terra、GPT-5.6-sol、GPT-5.6-lunaの4つのフロンティアAIモデルを5つの物理モデリングおよびシミュレーション問題でテストしました。Claude Fable 5は加重難易度スケールで0.889を記録し最高スコア、GPT-5.6-terraは0.786、solは0.814、lunaは0.727でした。Fableは4つのコア問題の全12試行を解いた唯一のモデルであり、最難問題(NASAのHL-20飛行体)ではどのモデルも完全には成功しなかったものの最高スコアを得ました。
なぜ重要か
物理AIシステムは正しい物理を符号化する必要があります。コンパイルできるコードを生成するだけでなく、これはエージェントAIが増幅する失敗モードです。JuliaBubの独立評価はベンダー自己申告ベンチマークに頼らず封印された地上基準に対してテストするため、どのモデルが実世界のエンジニアリング制約を実際に処理できるかを明らかにします。Fableの優位性にはコストが伴い、1試行あたり9.60ドル(全体で124.76ドル)で、GPT変種の3~8倍の価格ですが、GPT-5.6-solは第2位のスコアで5分の1のコストで中道を提供します。
注目点
研究の逆実験はハーネス(AIエージェントフレームワークとツール)がモデル選択単独よりも重要であることを示しました。モデルを固定したままハーネスを変更すると0.366ポイントのスコア差が生じ、最高と最低のモデル間の0.162ポイント差の2倍以上でした。モデル間の選択は異なるトレードオフを反映しています。Fableは深い検証を通じて正確性を優先、solはパフォーマンスとコストのバランス、terraは速度と価格で経済化しますが利幅を減らし、lunaはすべての軸で後塵を拝します。
こういう要約が、毎朝あなたのメールに届きます。
JuliaBubの評価はフロンティアAIモデルをエンジニアリング作業でどう評価するかについての重大なギャップに対処しています。ベンダー自己申告ベンチマークは固有の利益相反に直面しています。発行者は発表するスコアに向けてチューニングするあらゆるインセンティブを持っています。JuliaBubのインセンティブは逆方向に走ります。同社はDyadを複数のベンダー向けエージェントバックエンドで出荷し、どのモデルが最良の体験を提供するかに関係なくユーザーが最良の体験を得たときに勝ちます。このアライメントはベンダー主張が信用できない場所でその発見を信用できるものにします。
研究設計は他のすべての変数を固定したままモデルパフォーマンスを分離します。Dyad AIエージェントハーネス、5つの封印された問題、推論努力レベル(xhigh)、コンテキストウィンドウ(100万トークン)、トークン予算(128k)です。モデルだけが変わります。評価はコード品質ではなく地上基準に対して採点をグラウンドします。これは物理AIにおいて重大な区別です。ソリューションはコンパイルでき、内部チェックに合格でき、それでも不可能な物理を符号化できます。研究の最難問題、NASAのHL-20リフティングボディはこれを具現化します。2つの技術メモを読み、170個の風洞テーブルを抽出し、6自由度剛体ダイナミクスを実装し、8つの飛行シナリオを実行する必要がありました。どのモデルも完全に解きませんでしたが、トランスクリプトは各モデルがどう失敗し、なぜ失敗したかを明らかにします。
逆実験——モデルを固定したままハーネスを変更——は著しい発見を提供します。フレームワークはモデル選択よりも重要です。これはエンジニアリング作業にフロンティアモデルを評価する企業が、生のモデル機能と同等にエージェントインフラストラクチャと検証ツールを重視すべきであることを示唆しています。コスト対パフォーマンスのトレードオフも重要です。Fableのより高いコストはその深い検証戦略を反映し、GPT-5.6-solは中道を提供し、terraは速度とコストを優先しますが利幅を犠牲にします。正確性が譲歩できない場所のチームではFableの確信が支出を正当化します。値を最適化するチームでは、solは信用できる代替案を提示します。
業界と使っているAIツールを選ぶと、仕事に関係するニュースが毎朝届きます。
登録無料・Googleアカウントなら30秒・いつでも解除できますAITodayについて →
この記事についてわからないことをAIに質問できます。AIはこの記事・AIToday の過去記事・Wikipedia を読み、出典を付けて答えます。Q&Aはこのページに公開され、他の読者も読めます。
カマラータ氏はInceptionV1の猫・車ニューロンをV字検出器だと再解釈

Google DeepmindのGemini 4 ArgonがARC Prizeによると、4,800ドルでARC-AGI-3において97.5パーセントを記録し2位となった

MicrosoftのSurface Laptop UltraはNvidiaのRTX Sparkプラットフォームを採用し、2,599ドルから(最大5,899ドル)

Nieman Labによると、10月30日発効のMetaの新たな商用規約により、ビジネスユーザーと結びついたウェブサイトのコンテンツをクロールしAI学習に利用できる可能性がある

Vercelが木曜に公表したデータによると、TypeSafe AIのJevは、9月15日の限定リリースから2週間以内に有料チームの35%が使用した

Reflection AIがエージェント型コーディング向けオープンウェイトモデルBeamを発表


