何が起きたか
LangChainは評価駆動開発のガイドを公開した。成功の定義、構築前の評価作成、変更後の比較という3段階のループで、最先端のエージェントに適用したとしている。
なぜ重要か
一貫したデータセットで構築前にエージェントの実行を採点すれば、変更が改善か既存動作の破壊かを客観的に示せる。エラーが微細化する中、手作業の判断に頼らずに済む。
こういう要約が、毎朝あなたのメールに届きます。
LangChainは問題を身近な言葉で説明する。プロンプトの手作業テストは当初は機能するが、エージェントが成長すると最新の変更が改善か悪化かを判断しにくくなる。その答えとして、エージェントが非決定論的で同じ質問に異なる答えが返り、複数の正解があり得ることを踏まえて調整したテスト駆動開発の規律を取り入れた。
ガイドの実例は、create_ticketツールを追加する社内ドキュメントエージェントだ。ツール構築後は平均スコアが上がるが、VPN接続に関するハウツー質問がドキュメント検索ではなくチケット起票を始める。トレースからツール説明が広すぎることが分かり、IT対応が必要なリクエストに限定すると全例が通る。
LangChainはまた、小規模データセットでの満点が常に目標とは限らず、同じ例で調整すると過適合し得ると警告する。自動化として、プルリクエストでの高速チェック、夜間やリリース前の低速なLLM審査評価、さらに本番でのライブトレース採点、アノテーションキュー、ダッシュボードによる出荷後の回帰検出を提案する。
業界と使っているAIツールを選ぶと、仕事に関係するニュースが毎朝届きます。
登録無料・Googleアカウントなら30秒・いつでも解除できますAITodayについて →
この記事についてわからないことをAIに質問できます。AIはこの記事・AIToday の過去記事・Wikipedia を読み、出典を付けて答えます。Q&Aはこのページに公開され、他の読者も読めます。
このようなAIの動きを、御社の業界・競合に合わせて毎日届ける法人プランもあります → 詳しく見る
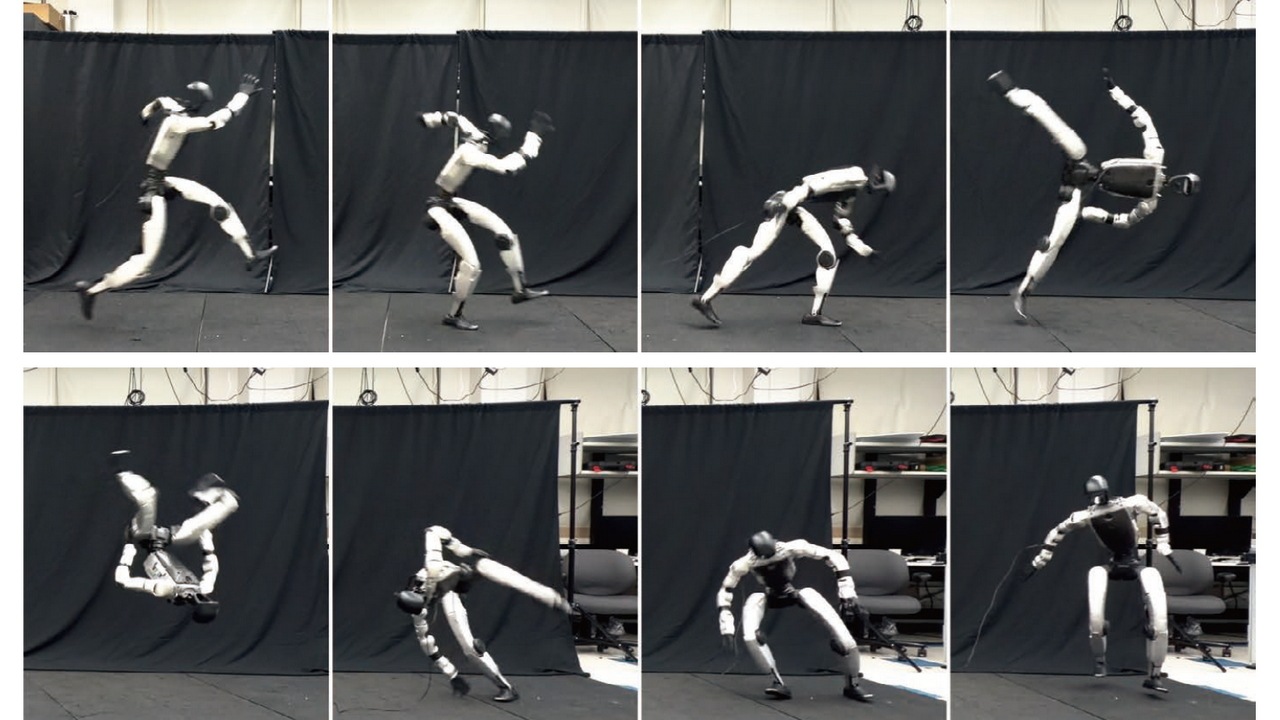
カリフォルニア大学バークレー校のPieter Abbeel氏のグループがSuperMimicを発表
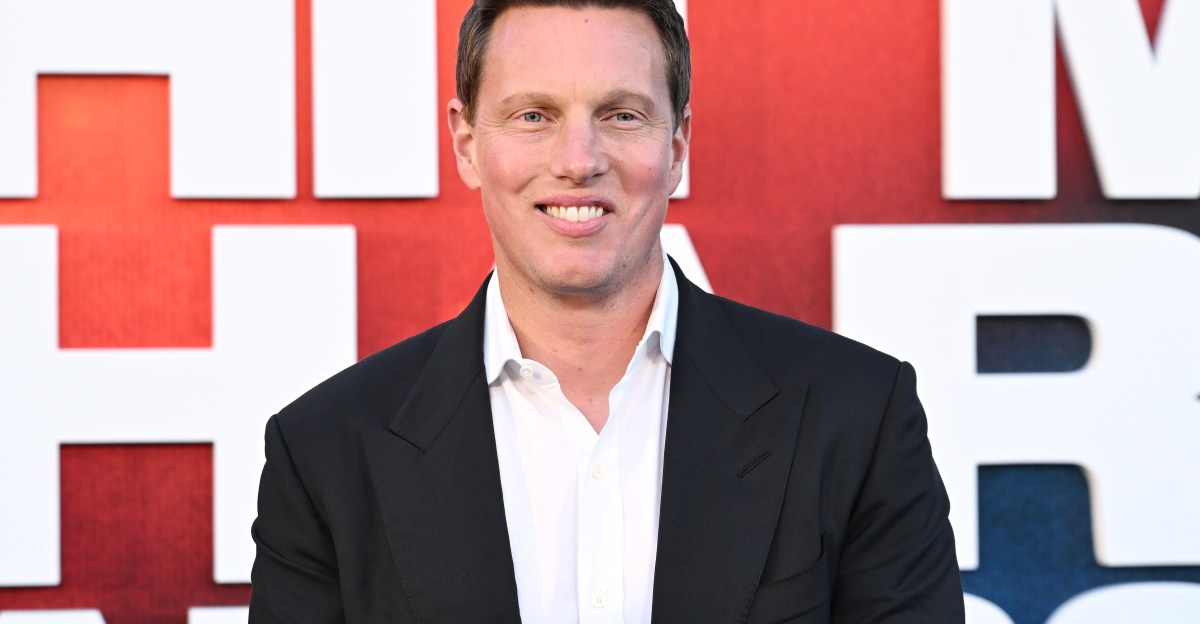
Paramount Skydanceの決算説明会で、CEOのDavid EllisonはAIが「現代史における最大の創造的解放」となり、CGIを上回る影響を映画に与え得ると述べた
AT&TがAIと自律型の時代に向けてネットワークを再構築していると、Fierce Networkが報じた
IBMはAnthropicのClaude Mythosのサイバー推論をIBM Concert Protectに取り込む計画
AppleのCEOがソフトウェア責任者に対し、より野心的なAI戦略を進めるよう圧力をかけているとBloomberg.comが報じた
PKSHA Technologyの上野山勝也CEOは14年間・4800社超のAI導入で代替型AIは定着せず連接型AIが根付いたと述べた