何が起きたか
AWSがAmazon Bedrock AgentCoreのプロンプト最適化ツールのベンチマーク結果を公開。
なぜ重要か
Sub-Agent Reflectorの95.83%はAppWorldで次善手法を16ポイント上回る。
注目点
Sub-Agent ReflectorはStrands GitHubリポジトリにある実験的なオープンソースの暫定版であり、マネージド offeringではない。
誰に効くかシステムプロンプトを調整する企業AIプラットフォームチームやエージェント開発者は、本番トレースを使って設定変更を提案・検証できるようになり、最適化時間を数時間から数分に短縮できる可能性がある。特殊な研究ニーズを持つチームは同じパターンをカスタムワークフローに応用できる。
こういう要約が、毎朝あなたのメールに届きます。
AgentCoreの最適化はAmazon Bedrock AgentCoreの可観測性と評価機能を基盤とし、本番トレースを使って設定変更を提案し、オフラインバッチ評価とオンラインA/Bテストで検証して優れたものを採用する。システムプロンプト最適化ツールは、ファイルシステムに保存された評価済みトレースを調査するエージェント型リフレクターを通じて動作し、成功した実行と失敗を分けるパターンを特定し、プラットフォームレベルのガードレールを通過した編集案を返す。
2つのリフレクター設計が比較されている。Single Agent Reflectorはトレースセット全体を1回のパスで処理し、一貫した編集セットを返す。実験的なSub-Agent Reflectorはエージェントの群れを使い、個々のトレースを独立に分析した後、オーケストレーターが結果を集約する。ベンチマーク結果はこの設計上のトレードオフを反映している。Single Agent Reflectorは品質あたりのコストで最良のバランスを提供し、Sub-Agent Reflectorは最高の品質上限を達成する。特に多様な失敗モードが1回のパスでは見逃されうるAppWorldで顕著だ。
チームにとっての実践的な意味はガードレールと検証ワークフローにある。長さ上限、安全審査、トレースの逐語フレーズ禁止は、よくある最適化のドリフトを防ぐことを目的とする。しかしSub-Agent Reflectorは実験的リリースの位置づけであり、本番での幅広い利用への道はマネージド offeringに移行するかどうかにかかっている。このアプローチを評価するチームにとって、本文のベストプラクティス(多様な10〜50件のトレースから始め、スカラー報酬と並んで自由記述のフィードバックを含める)は、既存の評価ルーチンを全面的に置き換えるのではなく、段階的な導入を想定した設計であることを示唆している。
たとえば、いま届くならこの3本です
AIが要約して、あなたの選んだトピックだけを1日1通。LINE・Email・Slackで届きます。
登録無料・Googleアカウントなら30秒・いつでも解除できますAITodayについて →
この記事についてわからないことをAIに質問できます。Q&Aはこのページに公開され、他の読者も読めます。
MozillaのAIブラウザアシスタント「Firefox Smart Window(ベータ版)」がMistralのモデルで動作し、まずフランスと北米で提供、英国とドイツは今年後半に続く
TypeSafe AIが、開発者が定義した質問と選択肢を採点し70〜500ミリ秒でラベルと確率を返すモデル「Jev」を公開した
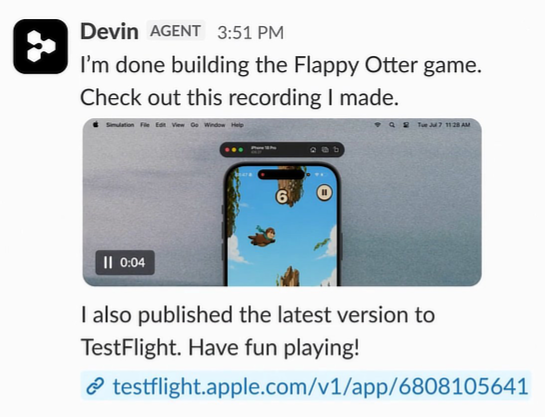
CognitionのDevinが2026年9月15日、ホスト型仮想環境でmacOSの提供を開始した
AnthropicのChris Cronbaugh氏はSleuthconで、プリペイドアカウントがClaudeに1日10万件超のAPIリクエストを送り、約28の出会い系アプリのAIペルソナ網を発見した
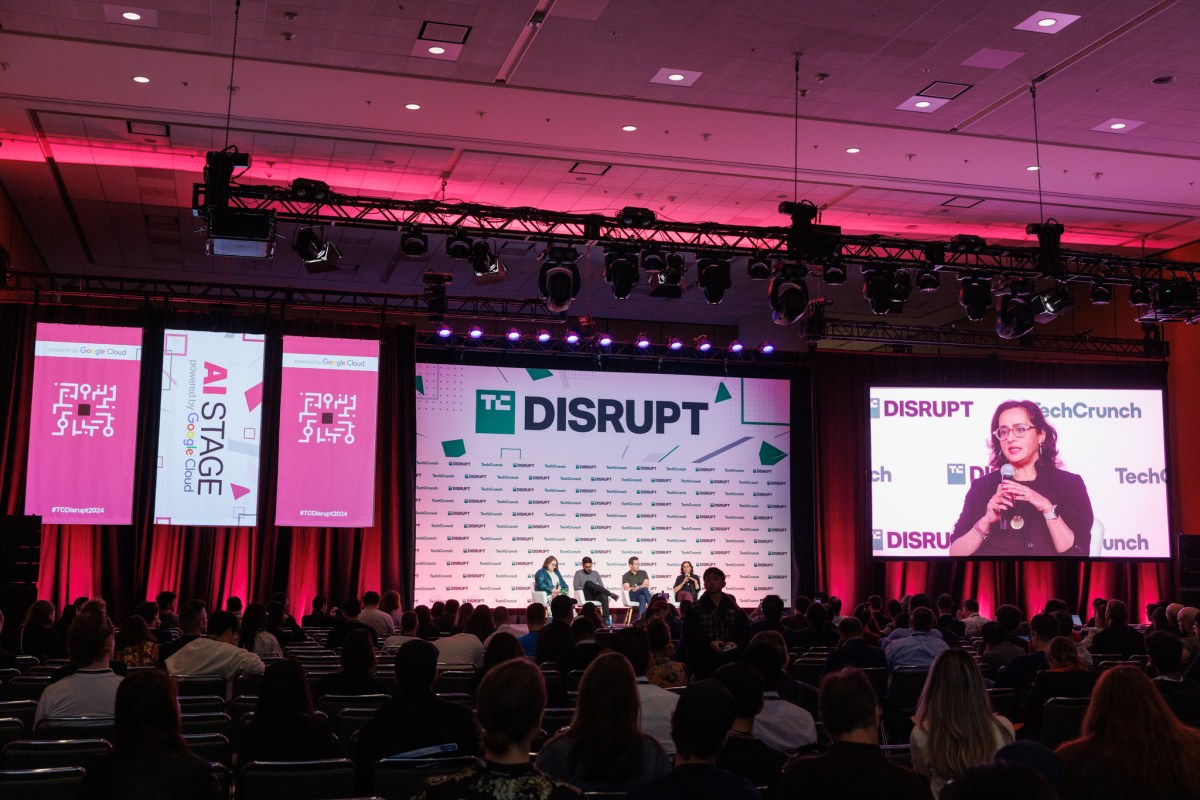
Nvidia InceptionでPhysical AIを統括するLes Karpas氏が、TechCrunch Disrupt 2026で、汎用ロボットにインターネット規模のデータセットがない理由を説明する
OpenAIは「Sponsored Agents」をテスト中