何が起きたか
Daily Dose of Data Scienceが、GRPOとRULERを使った現代的なファインチューニングの解説を公開。
なぜ重要か
報酬関数を書かず、ラベル付き事例も集めずに、経験を通じて改善するエージェントを訓練できると主張。典型的なファインチューニングからの転換だと位置づける。
注目点
鍵はARTのようなフレームワークの採用。100%オープンソースでGRPOをあらゆるPythonアプリに導入できる。3Bモデルのノートブックが任意のMCPサーバーURLで訓練できるとも記す。
誰に効くか狙いは、検索やAPI呼び出し、多段推論を行うエージェントを構築する機械学習エンジニアや開発者だ。データセットの選定や出力のラベリング、報酬関数の手作りではなく、GRPOとRULERで訓練できると記事は述べている。
こういう要約が、毎朝あなたのメールに届きます。
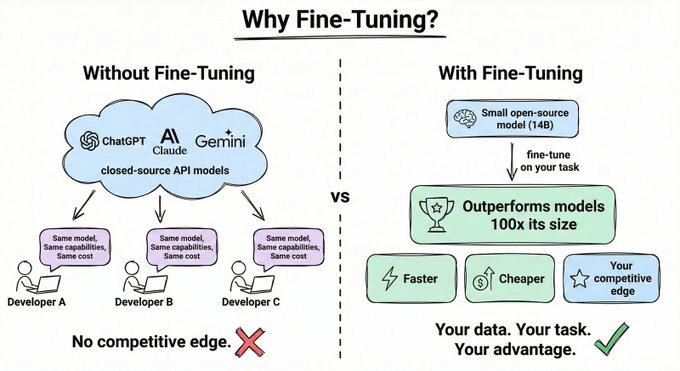
記事は対比を軸に議論を組み立てる。GPTやClaudeを使えば、誰もが同じ能力・コストの同じモデルを使うことになり、競争上の優位はない。一方、特定のタスクでファインチューニングした小規模オープンソースモデルは100倍の規模のモデルを上回り得る。この主張は、すでに起きたと記事が言う変化に支えられている。つまりファインチューニングには、データセットの選定も、出力のラベリングも、報酬関数の手作りも不要になったという変化だ。
技術的な要はGRPOとRULERの連携にある。GRPOはプロンプトごとに複数の補完を生成して相互に相対評価するため、絶対スコアではなく相対的な順位付けだけを必要とする。RULERはLLM審判に複数のエージェント軌跡を比較させることでその順位を提供する。単一の試行を0〜10で評価させるより信頼できると記事は論じる。ARTはその提供手段として位置づけられ、各エージェント実行をTrajectoryとして記録するClientと、推論と訓練を担い各ステップ後に新しいLoRAチェックポイントを読み込むBackendに分かれる。
別のアーキテクチャ項目、すなわちLlama 3 70Bが8つのクエリヘッドごとに1つのKVヘッドを共有するgrouped-query attentionは、コスト管理が訓練だけでなくモデル設計にも宿るという注意喚起として示されている。報酬不要のファインチューニング手法が約束を果たすかどうかは、ARTのようなフレームワークの採用と、任意のMCPサーバーURLに対して訓練する3Bモデルのノートブックにかかっている。
業界と使っているAIツールを選ぶと、仕事に関係するニュースが毎朝届きます。
登録無料・Googleアカウントなら30秒・いつでも解除できますAITodayについて →
この記事についてわからないことをAIに質問できます。AIはこの記事・AIToday の過去記事・Wikipedia を読み、出典を付けて答えます。Q&Aはこのページに公開され、他の読者も読めます。
このようなAIの動きを、御社の業界・競合に合わせて毎日届ける法人プランもあります → 詳しく見る
2026年10月21日、Anfini CEOの橋本淳氏が明治大学理工学部で特別講義を行い、Anfini AIX Methodや請求書入力、為替影響予測などの事例を紹介した

13日間・5,065リクエストのセッションで終盤は約0.42ドル、新規は約0.013ドルで31倍の差
2026年4月にClaude Proへ登録し後にMaxへ移行したWebデザイナー歴6年の人物が、ClaudeのチャットアプリとClaude Codeは参照範囲と必要なプランが異なると説く全3回ガイドの第1回を公開した
EC自動化工房がAI翻訳前に標準化すべき4項目を示した
OpenAIのGreg Brockman社長は11月4日のWSJ Techで、2026年第3四半期の年換算売上高が70%増加し、法人向けが「2倍」となり、事業顧客が売上高の半数超を占めたと述べた
リベルスカイは2026年11月11日開催のGoogle Cloud Japanウェビナーに登壇すると発表した