何が起きたか
AWSはvLLM-Omni Deep Learning ContainerでFLUX.2-klein-4Bをリアルタイム推論、Wan2.1-VACE-1.3Bを非同期推論で動かすサンプルを公開した。
なぜ重要か
同じコンテナで画像と動画の両モデルを動かせるため、モデルごとに別の推論基盤を用意せず、応答時間やデータ量に応じて推論方式を選べるとみられる。
注目点
動画設定は17フレーム・30ステップが既定で、4ステップは動作確認用にとどまる。記事が示す所要時間は単発の再現用チェックポイントで、性能指標ではない点に注意が必要だ。
誰に効くか生成AIの画像・動画機能を自社サービスに組み込む開発・運用担当者に影響する。SageMaker AI上でGPUインスタンスの確保と課金が前提となるため、コスト試算とインスタンス選定が導入判断の鍵になる。
こういう要約が、毎朝あなたのメールに届きます。
この記事は、AWS Deep Learning ContainersのうちvLLM-Omniを扱うシリーズの第2弾である。第1弾では双方向ストリーミングによるリアルタイム音声を扱っており、今回は画像と動画という別の生成メディアに範囲を広げた。同じpinnedのコンテナイメージを使い、環境変数SM_VLLM_MODELの切り替えだけで、画像用のFLUX.2-kleinと動画用のWan VACEを別々のエンドポイントに配備する構成になっている。
画像はbase64のPNGとして即時に返り、それを動画用の寸法にリサイズしてJPEG化し、Wan VACEのマルチパート要求に埋め込む。要求はAmazon S3に置かれ、非同期エンドポイントに渡され、生成されたMP4はS3から取得される。128,000バイトのインラインBodyでは足りないため、この構成ではInputLocationが使われている。
この使い分けはあくまで「ワークロードに合わせた選択」であり、すべての動画モデルに当てはまる規則ではないと本文は明言する。実運用では、モデルの遅延やペイロード、クライアントの対話方式に応じて推論方式を選ぶことになり、GPUエンドポイントのコストと性能検証をどこまで詰められるかが導入の分かれ目になりそうだ。
業界と使っているAIツールを選ぶと、仕事に関係するニュースが毎朝届きます。
登録無料・Googleアカウントなら30秒・いつでも解除できますAITodayについて →
この記事についてわからないことをAIに質問できます。AIはこの記事・AIToday の過去記事・Wikipedia を読み、出典を付けて答えます。Q&Aはこのページに公開され、他の読者も読めます。
このようなAIの動きを、御社の業界・競合に合わせて毎日届ける法人プランもあります → 詳しく見る
Sunoは、楽曲向けに最長15秒の画像やクリップを生成するVisualsを開始
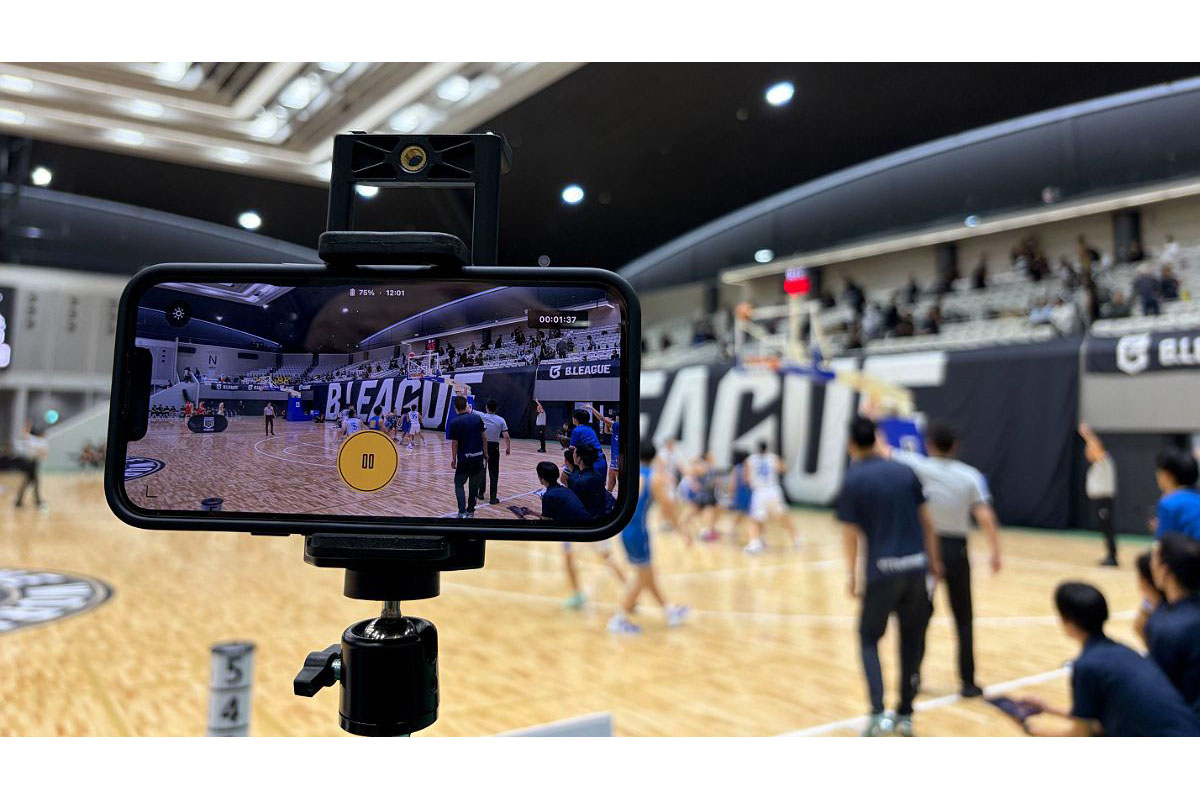
ソフトバンクは日本バスケットボール協会と連携し、米Built Different AIのHOOPERアプリを国内大会で実証
Googleスライドのファイルメニューに「動画に変換」が追加され、AIがスライドを読み取り、ナレーションとBGM、アニメーション付きの動画を生成し、Google Vidsで開く
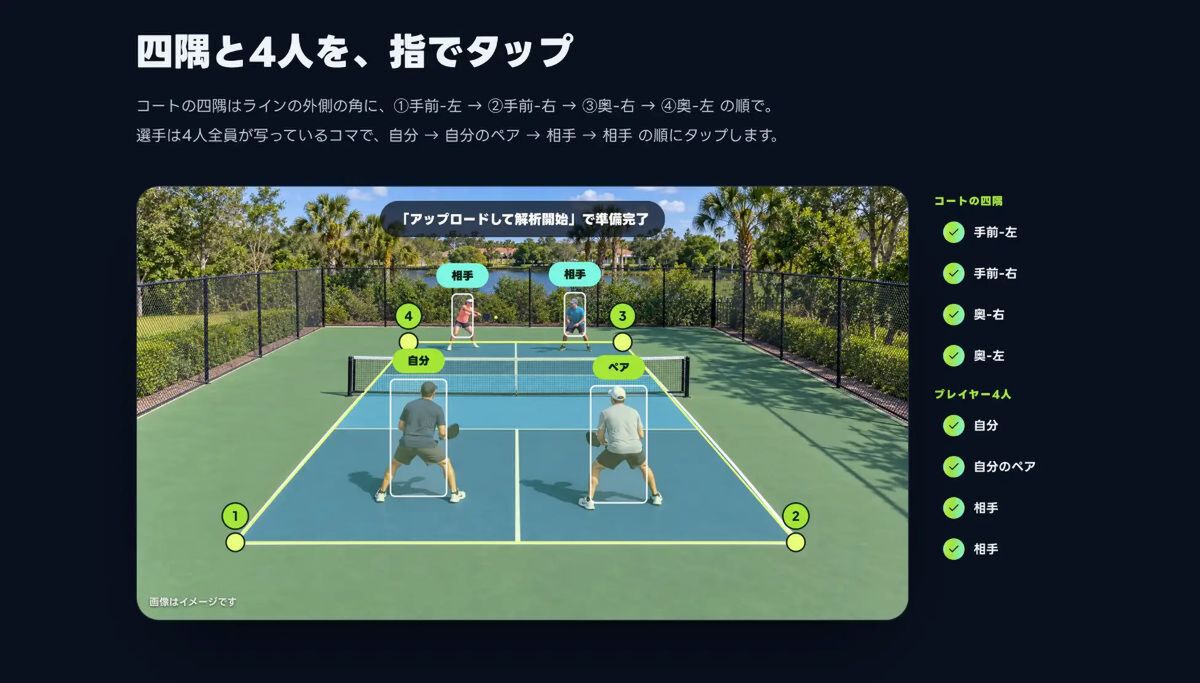
DWZは11月17日、PickleballMeをApp Storeでリリースした
Metaの最高AI責任者アレクサンダー・ワン氏が11月上旬、消費者向けAIエージェント「Muse」の宣伝としてサム・アルトマン氏ら4者ビデオ通話をAI生成した短いクリップをInstagramに投稿した
Appleの研究者らが論文「Split-and-Scale Latent 3D Representations」を発表した