何が起きたか
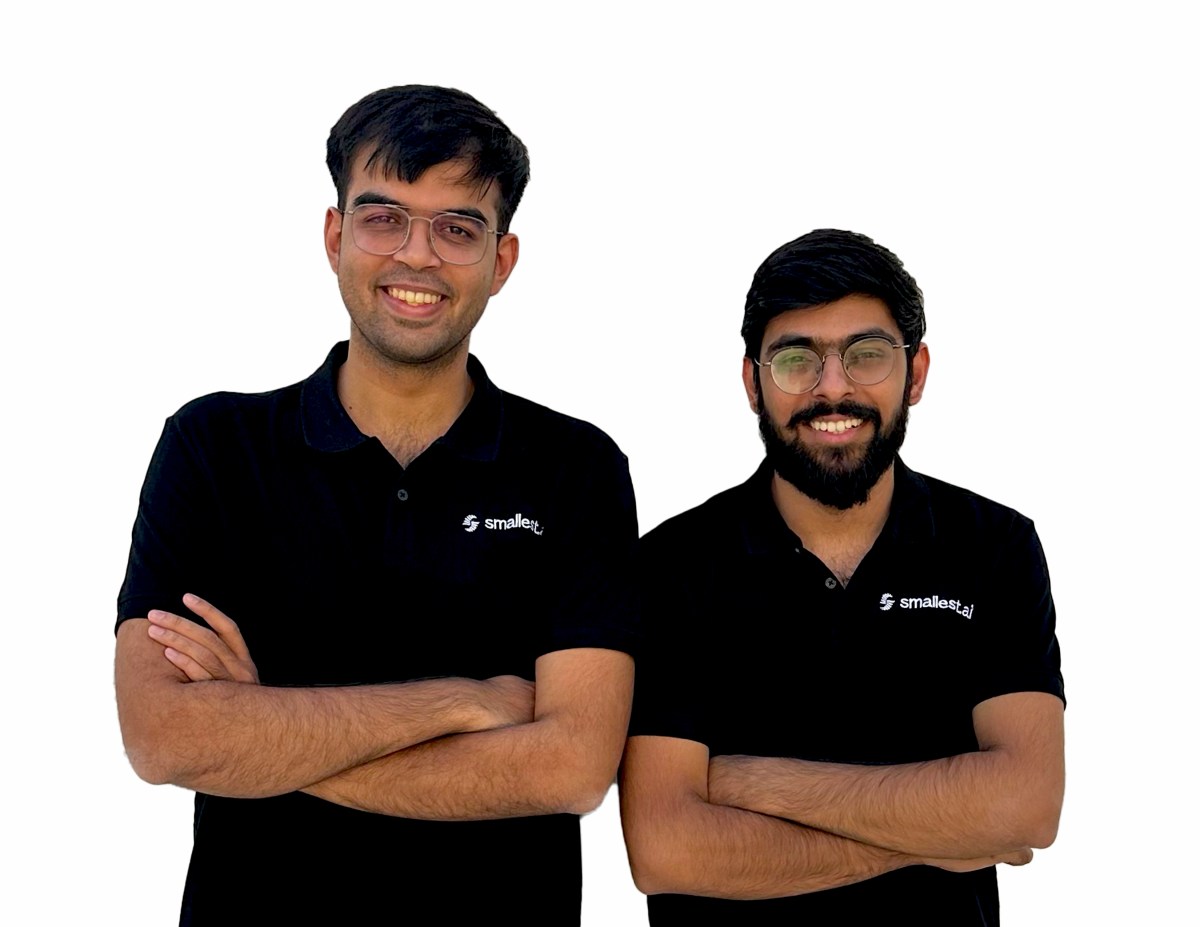
2024年後半に設立されたSmallest.aiが、Seligman Venturesが主導するシリーズAで1300万ドルを調達した。Sierra VenturesおよびOneone4 Capitalも参加し、総資金調達額は2100万ドルを超えた。同社は人間のように同時に聴き、考え、話すことで、AIエージェントの不自然な遅延を排除する小規模な特化型音声モデルを開発している。
なぜ重要か
ほとんどのAI顧客サポートエージェントはまだ機械的に聞こえ、会話における不自然な一時停止がある。Smallest.aiのアプローチは、よく知られたトピックに対して即座に対応する小規模なリアルタイム音声モデルを使用し、複雑な質問が必要な場合のみより大きなモデルに引き継ぐ方式で、人間のサポートエージェントが不慣れな問題を簡単に調査するやり方を模倣している。既存の顧客にはRingCentralとTruecallerが含まれており、このモデルは社内音声AI専門知識を持たない顧客サポート企業に訴求する可能性がある。
注目点
Smallest.aiはElevenLabs、Cartesia、Sarvamなどの地域プレイヤーと競合している。同社はリアルタイム会話型音声エージェントの企業向けに絞って注力し、多様なアクセント、数十言語、騒音環境に対応している。音声ダビングやポッドキャスティングなどのより広い音声ユースケースは対象ではない。
こういう要約が、毎朝あなたのメールに届きます。
同社は、AIカスタマーサポートにおける根強い問題点に対処している。大規模言語モデルが入力を処理して出力を生成するときに発生する、不気味でロボット的な一時停止である。標準的なLLMベースのエージェントは順序立てて動作する。入力を受け取り、その後に思考し、その後に話す。これにより測定可能なレイテンシーが導入され、自然な会話の流れが中断される。Smallest.aiの創業者らは、次のフロンティアはより大きなモデルでの高速推論ではなく、人間の音声と会話のメカニクスについて特別に訓練された目的別設計の小規模モデルであると主張している。
同社の2段階アーキテクチャ。リアルタイム交換のための小規模音声モデル、複雑なクエリのための大規模基盤モデル。は、万能の基盤モデルが特殊なタスクに対して非効率である可能性があるという業界の新たな信念を反映している。音声固有の課題(多様なアクセント、多言語対応、ノイズロバストネス)およびリアルタイムカスタマーサポートに焦点を絞ることで、Smallest.aiはダビングからポッドキャスティングまで、より広い音声AI使用ケースに対応するElevenLabsなどの競合他社よりも、狭いがより競争が少ないニッチに自らを位置付けている。1300万ドルのシリーズA、顧客トラクション(RingCentral、Truecaller)、および2024年後半の設立日は、汎用モデルがより強力になるにつれても、特化された会話型音声AIが企業価値をキャプチャできるというテーゼに対するベンチャーキャピタルの信頼を示唆している。
業界と使っているAIツールを選ぶと、仕事に関係するニュースが毎朝届きます。
登録無料・Googleアカウントなら30秒・いつでも解除できますAITodayについて →
この記事についてわからないことをAIに質問できます。AIはこの記事・AIToday の過去記事・Wikipedia を読み、出典を付けて答えます。Q&Aはこのページに公開され、他の読者も読めます。
ElevenLabsが220億ドルの評価額で3億ドルの従業員向けテンダーを完了し、Mati Staniszewski氏は音声が主要なインターフェースになると予測した

日俳連は10月15日、生成AIの音声利用ガイドラインを発表した
Aratakoによる日本語専用のオープンTTSモデルIrodori-TTSを、Databricks Model Serving上で動かし、テキストを送ると音声を返すAPIとして使う手順が公開された
個人開発者がYuruneを制作した

開発者がMoonshine Voiceの日本語「Small Streaming」モデルをLinux CPU(16コア)上でfaster-whisperのsmallモデルと比較し、合成音声・FLEURSの20クリップ・自作…

日本俳優連合は10月15日、音声に関する生成AIガイドラインを策定し、学習・生成・公開の全段階で演者の事前同意を求めた