何が起きたか
自作の問い合わせメール18件を4カテゴリに分類させると、Jeffは全体94.4%、adversarial群でも87.5%で、ルールベース(72.2%、37.5%)を上回った。
なぜ重要か
文脈・否定・皮肉を扱えないキーワード一致の弱点が数字で示され、0.8Bという小ささでもゼロショット分類が実用になる可能性があるとみられる。
注目点
JeffはCPU4コア環境で約1,500ms/件とルールベースの0msに比べ明確に遅く、READMEの463ms/決定は再現しなかった。GPUやApple Silicon環境での速度が焦点となる。
誰に効くか問い合わせメールの振り分けを運用するカスタマーサポートの担当者や、分類器の内製を検討する情報システム部門にとって、小さなモデルで精度を取るかルールベースで速度を取るかの判断材料になる。
こういう要約が、毎朝あなたのメールに届きます。
JeffはQwen3.5-0.8Bをファインチューンして作られた、生成ではなく確率を返すゼロショット分類モデルである。READMEでは「27Bモデルの前にJeffを置き、Jeffが自信を持てる決定は自分で片付け、迷ったときだけ27Bに回す」という使い方が謳われており、今回の検証はその入り口として位置づけられている。
比較対象となったのは、文中の単語を先頭から見て最初にヒットしたキーワードのカテゴリを採用する、ありがちなルールベース分類器である。easyな10件では両者とも全問正解で差が出なかったが、否定文や皮肉を混ぜたadversarial 8件でルールベースが37.5%まで落ち込む一方、Jeffは87.5%を維持した。Jeffが唯一誤分類した例ではbillingとtechnicalが僅差でconfidenceも低く出ており、確率分布から「自信なく間違えている」ことが読み取れる点は、確信度が低いときだけ人間や大きいモデルに回すという想定用途の説得力を補強する。
一方で速度は、GPUなし・CPU4コアのクラウド環境で約1,500ms/件と、READMEが謳うCPU 463ms/決定(32スレッド)には届かなかった。1件ずつHTTPリクエストしてバッチ化していないことやコア数が少ないことが理由と考えられ、精度を取るか速度を取るかはユースケース次第とみられる。次に試すならREADMEにある9種類のLoRAアダプタを読み込み、ベース単体との精度差を見る余地がある。
業界と使っているAIツールを選ぶと、仕事に関係するニュースが毎朝届きます。
登録無料・Googleアカウントなら30秒・いつでも解除できますAITodayについて →
この記事についてわからないことをAIに質問できます。AIはこの記事・AIToday の過去記事・Wikipedia を読み、出典を付けて答えます。Q&Aはこのページに公開され、他の読者も読めます。
P&GのCFOアンドレ・シュルテン氏は、注文を行い買い物のあり方を変えるAIエージェントに先手を打って備えていると述べた
UberはChatGPT Workの全社展開を発表した
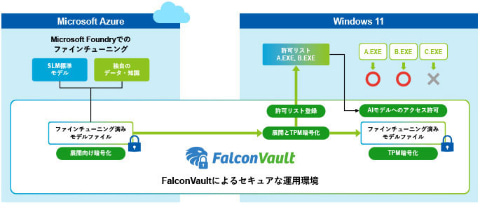
東京エレクトロン デバイスが20日、FalconVaultの販売を開始
アンソロピックは10月21日、iOS・Android・claude.ai向けにClaude Duetのリサーチプレビューを開始した
LINEヤフーの赤間氏、山口氏、佐藤氏によると、Agent iは30以上のドメインエージェントを共有メモリー、ルーティング、汎用エージェント、LINEとYahoo!
サムスンソウル病院がNewsweekの「World's Best Smart Hospitals 2027」で前年の15位から4位に浮上し、韓国の医療機関で過去最高位を記録、AI Innovation Leaderの認定…