何が起きたか
現代のAI性能向上は、事前学習、RLHF、RLVRと推論時スケーリング、MoEと蒸留、エージェントとコンテキスト設計の5つの方向から説明できると整理されている。
なぜ重要か
モデルを大きくするだけでは説明できず、人間の評価や自動採点、計算量を抑える構造、使う側の環境づくりまでが性能を左右するとみられる。
注目点
Epoch AIは人間が書いた公開テキストを約300兆トークンと推定し、2026年から2032年の間に使い切る可能性があると予測しており、データの壁が焦点となる。
誰に効くか自社でAI導入を検討する情報システム担当者や、AIモデルの選定に関わる企画担当者は、モデルの大きさだけでなく、RLHFやMoE、エージェント設計といった仕組みの違いを比較軸にする必要がある。
こういう要約が、毎朝あなたのメールに届きます。
AIの性能向上をめぐる議論は、かつてはモデルのパラメータ数を増やすことが中心だった。しかし2022年にDeepMindが発表した研究は、同じ計算量ならモデルの大きさと学習データ量をバランスよく増やす方が良いという結果を示し、700億パラメータのChinchillaが2800億パラメータのGopherを上回った。ここから「パラメータ数の約20倍のトークンを読ませる」という目安が広く知られるようになった。
その後、性能を押し上げたのは学習の工夫だけではない。人間の評価で回答を仕上げるRLHF、自動採点を報酬にするRLVR、考える時間を増やす推論時スケーリング、計算量を抑えながら大規模化するMoEと蒸留、道具と記憶を持たせるエージェントとコンテキスト設計が組み合わされている。DeepSeek-R1-Zeroが強化学習だけで推論能力を伸ばした事例や、DeepSeek-V3が6710億パラメータのうち1トークンあたり370億だけを動かす事例はその代表だ。
こうした仕組みは大量の高品質データを前提にしており、Epoch AIは2026年から2032年の間に公開テキストを使い切る可能性を指摘する。ただし合成データや効率化で越えられる可能性も示されており、今後はデータの制約と計算効率のどちらを軸に性能を伸ばすかが焦点になるとみられる。
業界と使っているAIツールを選ぶと、仕事に関係するニュースが毎朝届きます。
登録無料・Googleアカウントなら30秒・いつでも解除できますAITodayについて →
この記事についてわからないことをAIに質問できます。AIはこの記事・AIToday の過去記事・Wikipedia を読み、出典を付けて答えます。Q&Aはこのページに公開され、他の読者も読めます。
KDDIのELYZAは10月2日、「ELYZA RSI Research」を設置し再帰的自己改善を研究すると発表
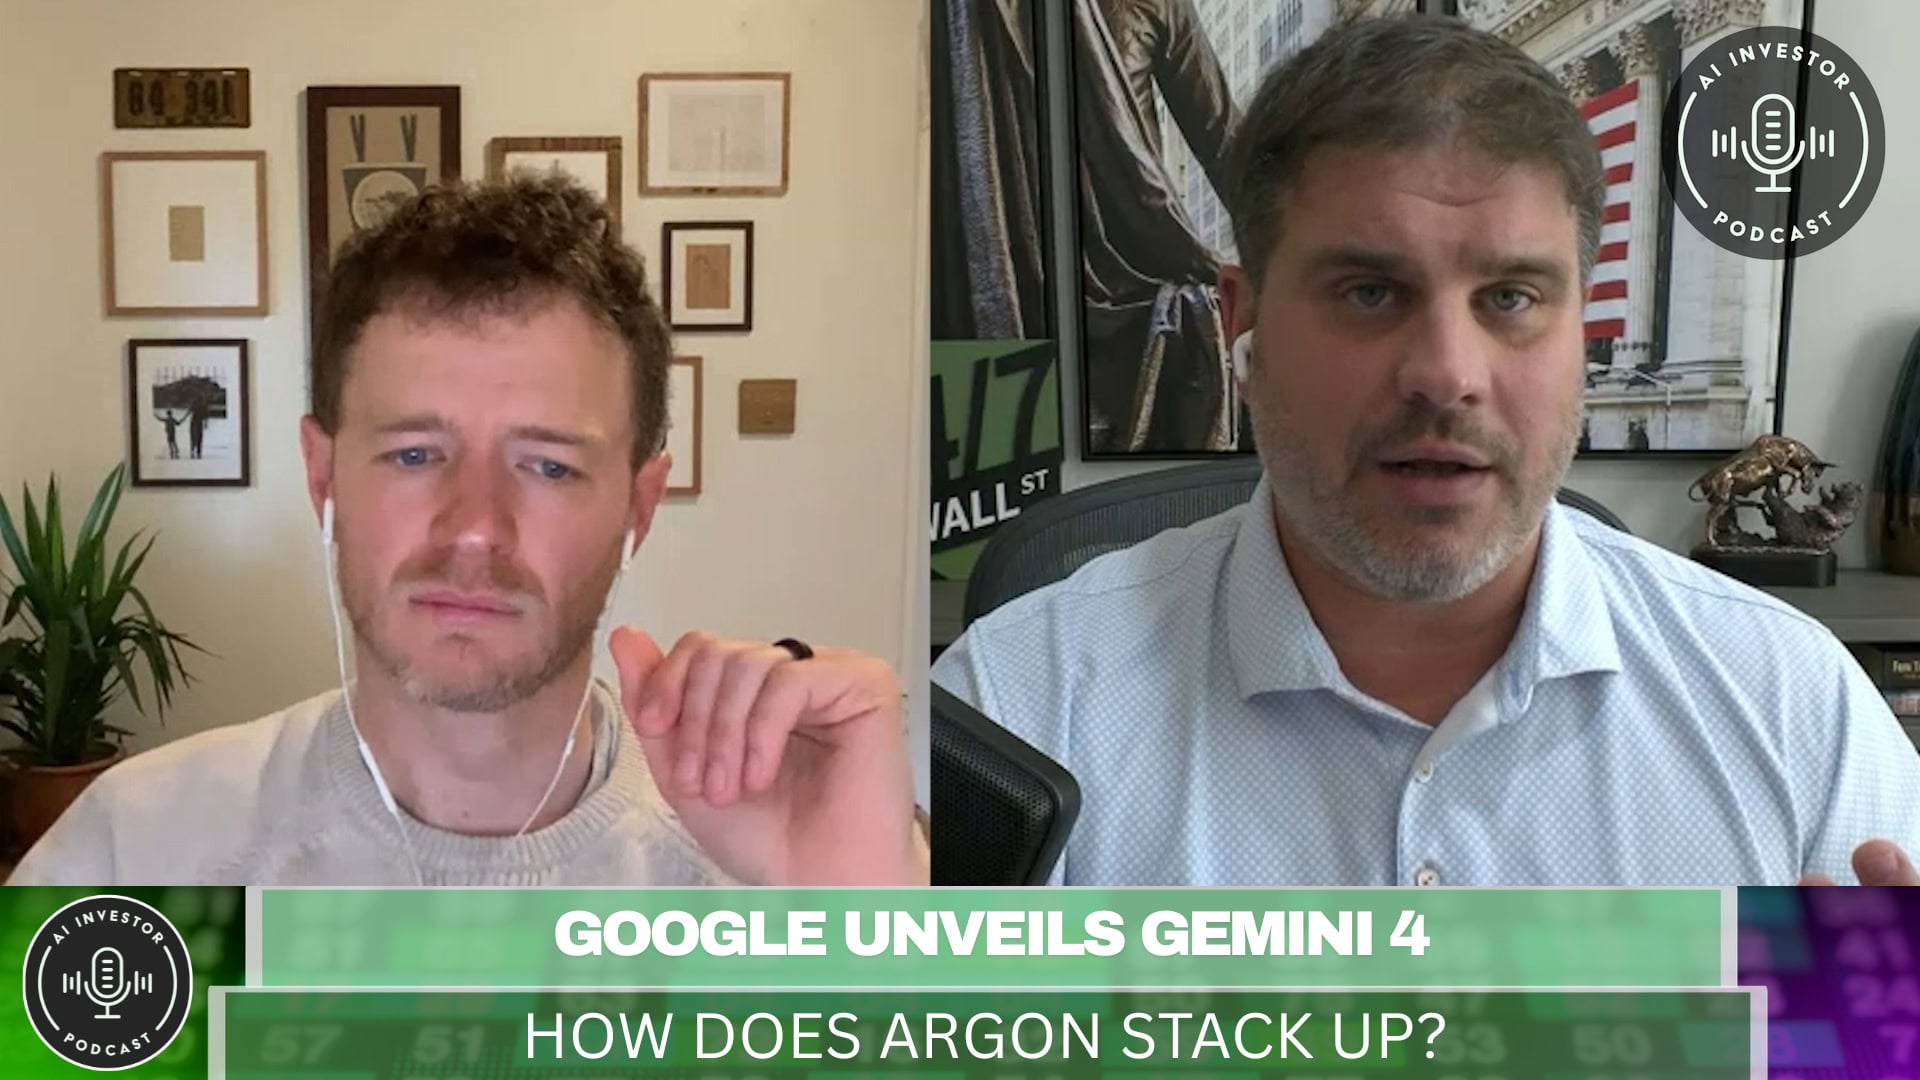
The AI Investor PodcastでEric BleekerとAustin SmithがGoogleのGemini 4 Argonリリースを分析し競合との位置づけを解説した
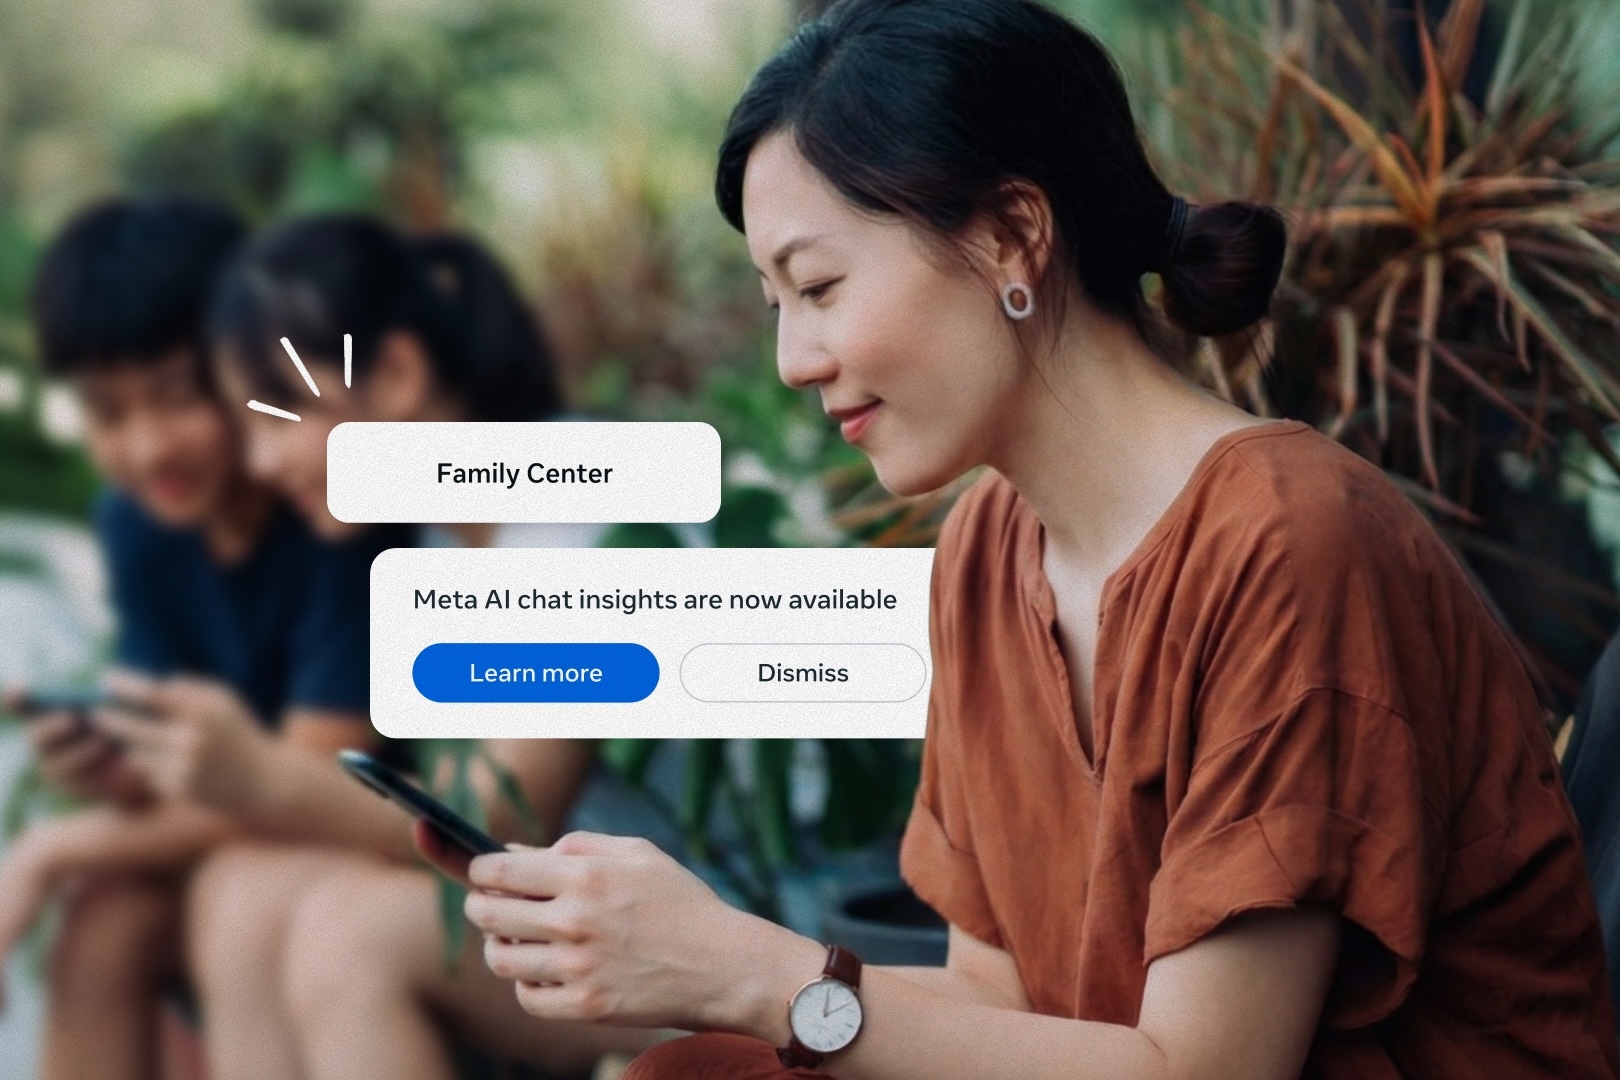
MetaがMeta AIで保護者向け機能の提供を始めた
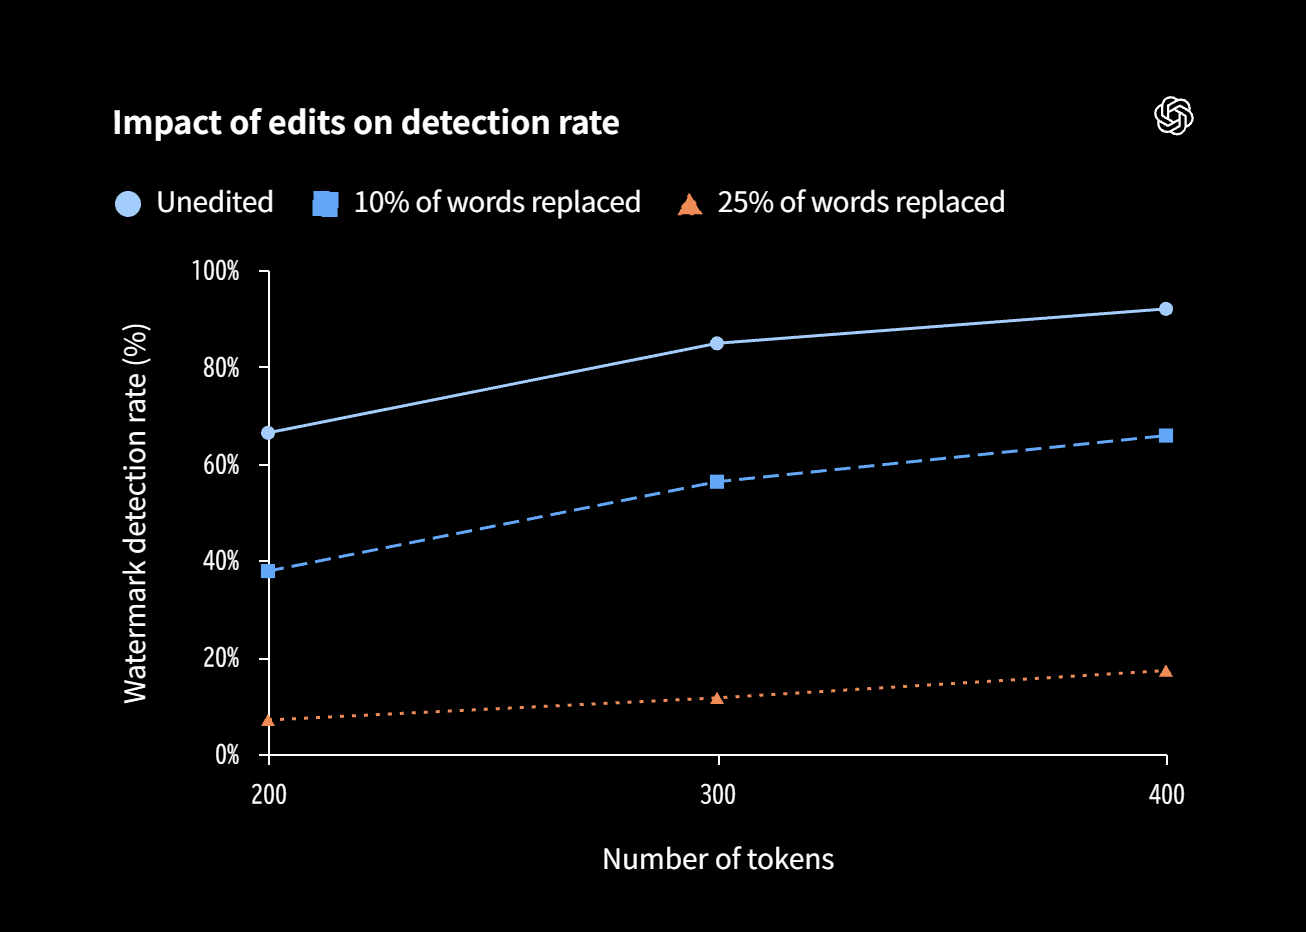
OpenAIはChatGPTとCodexのテキストにtextGrainの透かしを追加し、EU向け出力に数週間以内に適用する
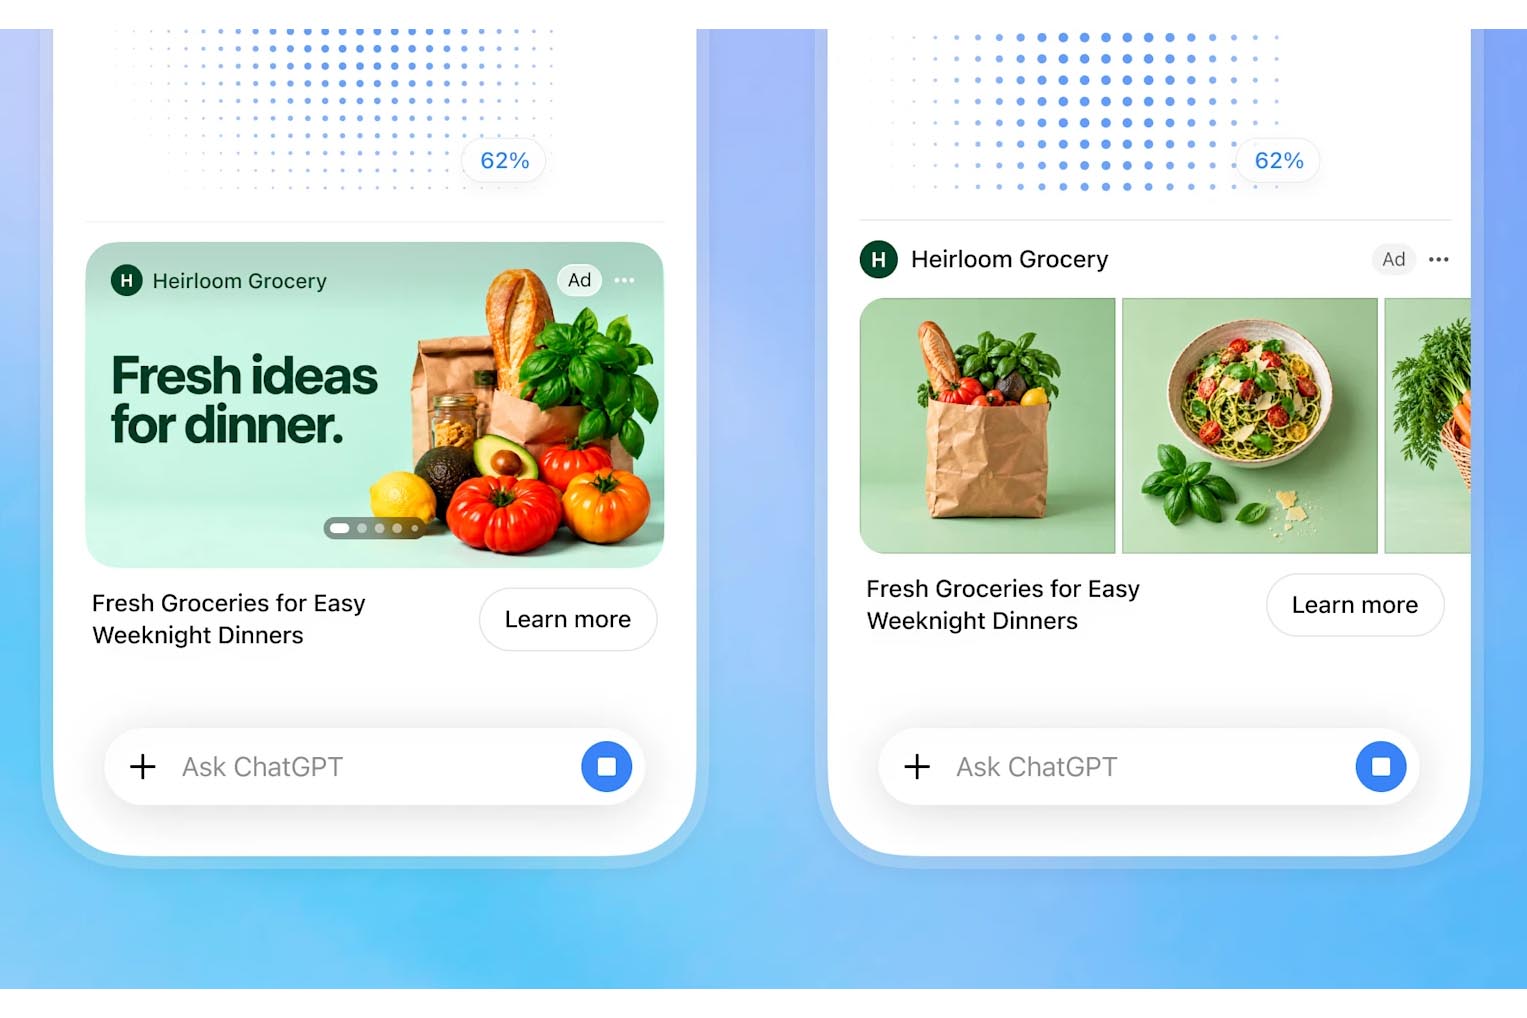
OpenAIはChatGPTの画像生成中に表示する新しいビジュアル広告フォーマットを展開し、10月後半から米国の一部広告主でテストする
Technology Innovation InstituteがFalcon-H1-Arabic基盤の70億パラメータモデルFalcon-Emirati-7Bを公開