何が起きたか
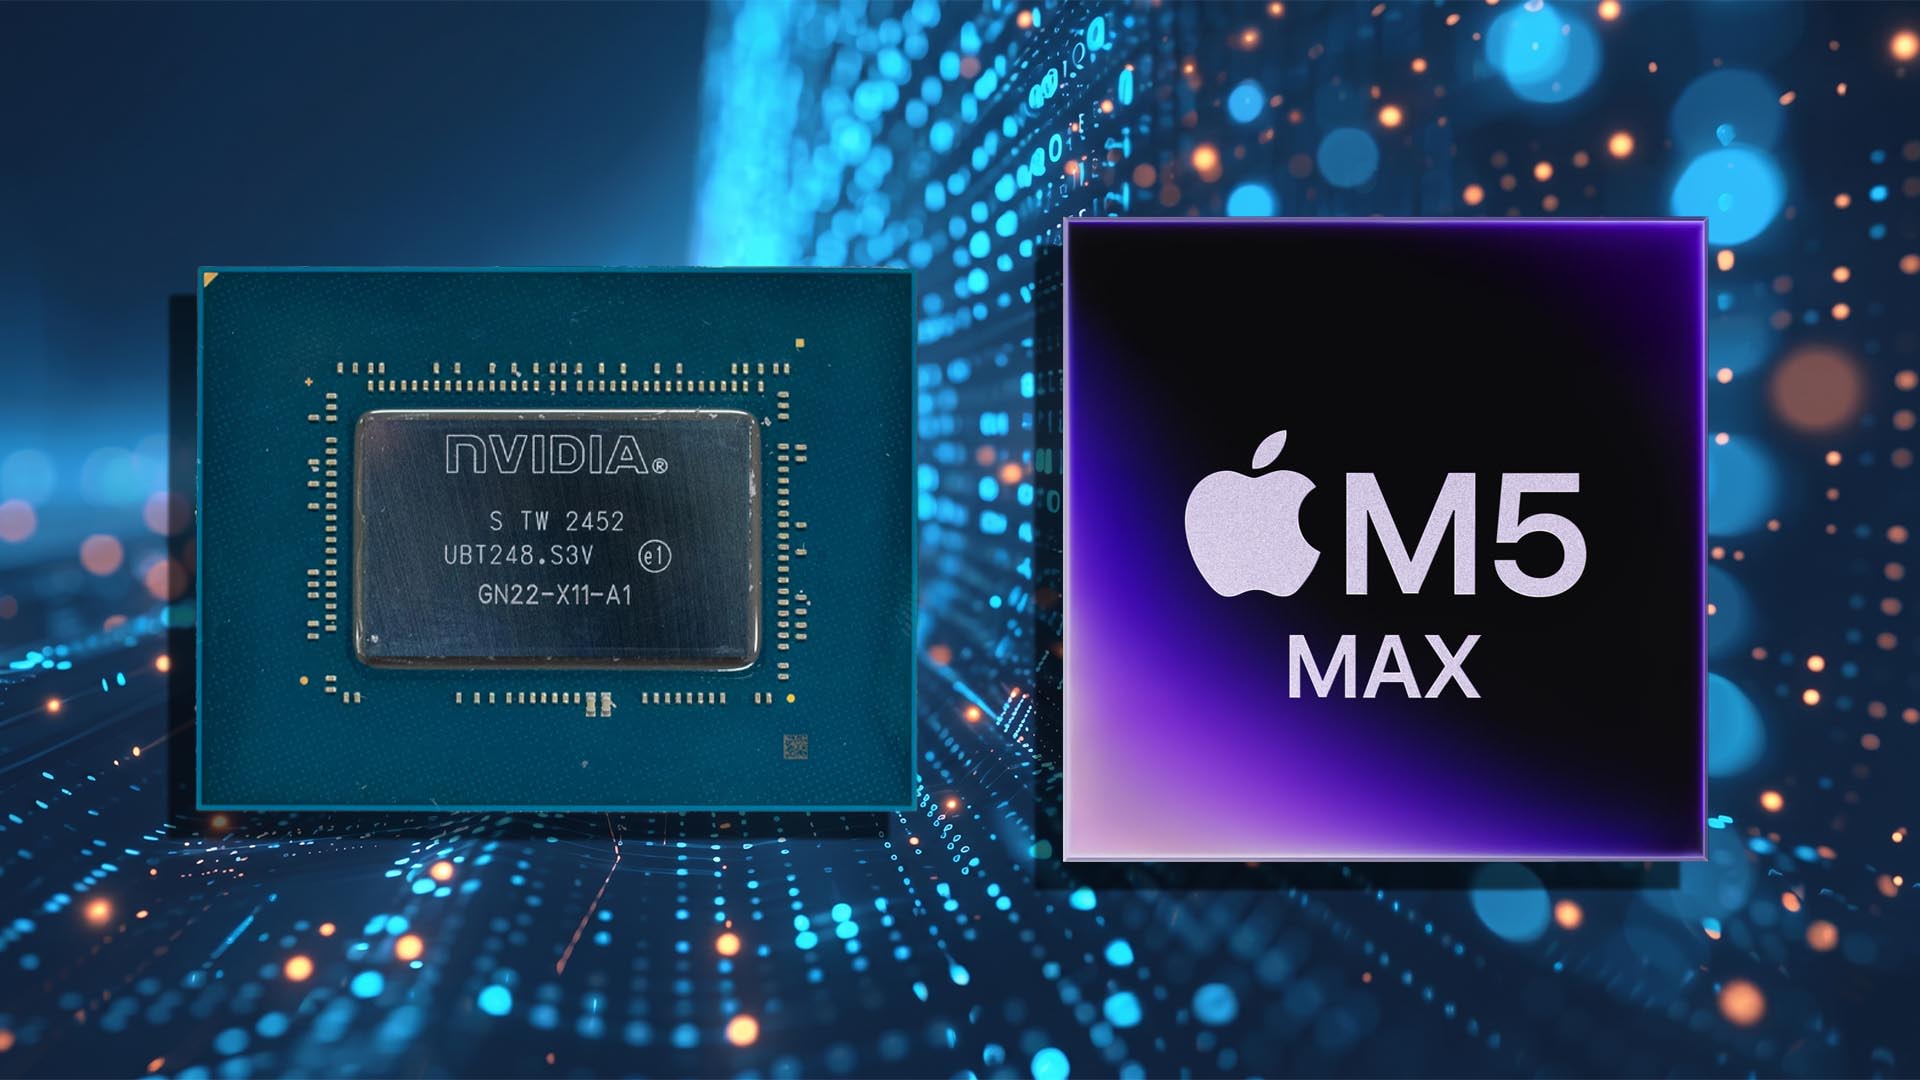
アレックス・ジスキンドのベンチマークテストで、NVIDIAのノートPC向けRTX 5090がAppleのM5 Maxを複数のLLMのプロンプト処理とトークン生成で上回り、一部のワークロードで最大133%の高速化を達成。
なぜ重要か
RTX 5090の24GB VRAMは、大規模モデルや長いコンテキスト長で性能が制限される。コンテキスト長が長くなると、M5 Maxのユニファイドメモリ(128GB)が明確な優位性を示し、181.40トークン/秒に対し、RTX 5090は25.28トークン/秒となった。国内のAI開発者が、搭載メモリ量を理由にノートPC向けGPUの選択を迫られる可能性がある。
注目点
RTX 5090はGemma 4 12B、Qwen3.5 27B、Qwen3.6 35B A3Bなどの小規模モデルで優れるが、Qwen3.5 122Bのような高密度モデルでは実用に耐えない。NVIDIAのRTX Spark投入は、より重いAIモデルを狙う可能性がある。
こういう要約が、毎朝あなたのメールに届きます。
ベンチマーク結果は、個別GPUとAppleのユニファイドメモリのアーキテクチャ上の大きな違いを浮き彫りにしている。RTX 5090の生の計算能力は、モデルが24GB VRAMに収まる場合に発揮され、小規模LLMのトークン生成で最大133%高速だ。しかし、コンテキスト長が長くなるとVRAMが不足し、性能は25.28トークン/秒に低下する。一方、M5 Maxは128GBのユニファイドメモリにより181.40トークン/秒を維持する。
このトレードオフは、AIワークロード用のハードウェア選びで重要だ。大規模モデルや長いコンテキストを扱うユーザーにはM5 Maxが実用的な選択肢となる。一方、小規模モデルを使う一般的なローカルLLMタスクではRTX 5090の速度が優れており、愛好家にとってはコストに見合うかもしれない。記事では、より重いAIモデルの実行も動機の一部とされるNVIDIAの今後のRTX Sparkがこのギャップを埋める可能性があるが、詳細は明らかにされていない。
業界と使っているAIツールを選ぶと、仕事に関係するニュースが毎朝届きます。
登録無料・Googleアカウントなら30秒・いつでも解除できますAITodayについて →
この記事についてわからないことをAIに質問できます。AIはこの記事・AIToday の過去記事・Wikipedia を読み、出典を付けて答えます。Q&Aはこのページに公開され、他の読者も読めます。
このようなAIの動きを、御社の業界・競合に合わせて毎日届ける法人プランもあります → 詳しく見る
FlashLabsがOrcaRouterゲートウェイのTrace Exportを強化し、SDKやコード変更なしでAIリクエストのトレースをGrafana、Datadog、Langfuse、LangSmithへリアルタイム…

KivaのSamurai Appに、ヤマト運輸「ビジネスメンバーズ」の顧客コードへログインし運賃と請求金額を取得、複数コード・複数月の運賃CSVを一括ダウンロードできるAPI連携を追加
Notion LabsのCISOデイビッド・ツァオ氏は、11月2日のFireworks AIへの不正アクセスでNotion AI Insightsのチャット記録が流出した可能性を受け、11月12日に影響を受けた日本顧客へ…
川崎重工業は11月16日、神戸須磨シーワールドでAIカメラによる実証実験を行うと発表した
SwitchBotはスマートリモコン「Hub 4」の予約販売を11月18日に19,980円で開始した