何が起きたか
NVIDIAのNemotron 3.5 Super VL(120Bパラメーターのマルチモーダルモデル)がAWSで利用可能になり、Amazon EKS、EKS Auto Mode、SageMaker HyperPod EKS向けの導入ガイドが提供された。
なぜ重要か
このオープンモデルはテキスト、画像、文書、動画のタスクを1つのシステムで処理でき、チームは自ら管理するインフラ上でエージェントのワークフローを実行できる。
誰に効くかテキストと視覚データを組み合わせたエージェントのワークフローを構築する企業のAIチームは、サービングスタックを一から作ることなく、文書化されたリファレンス実装を使ってAWS上にこのモデルを導入できる。
こういう要約が、毎朝あなたのメールに届きます。
Nemotron 3.5 Super VLは、より大型のNemotron 3 Ultraから蒸留されたモデルで、すでにAWSで提供されているモデル群に加わる。クローズドなAPIとは異なり、NVIDIAはモデルの重み、学習データセット、事後学習のレシピを公開しているため、チームは特定ドメインのワークロード向けにファインチューニングし、自社インフラで実行できる。
アーキテクチャは、長いコンテキストの推論を手頃なコストに保つよう設計されている。MambaとTransformerを組み合わせたMoE設計を採用し、120Bのパラメーターのうち12Bをトークンごとに活性化するため、全体の重みをGPUメモリに収める必要はあるものの、トークンあたりの計算量は低く抑えられる。Mamba-2層は生成中に一定サイズの状態を保持し、長いコンテキストを通常は高コストにするメモリ増加を避ける。
NVIDIAはp6-b200.48xlargeとp5en.48xlargeインスタンスで導入を検証し、集約型と分離型の導入でトークン間レイテンシーが同程度である一方、分離型構成では最初のトークンまでの時間が短くなるという性能データを公開した。こうしたデータは、サービスレベル目標に基づく容量計画に役立つ。
業界と使っているAIツールを選ぶと、仕事に関係するニュースが毎朝届きます。
登録無料・Googleアカウントなら30秒・いつでも解除できますAITodayについて →
この記事についてわからないことをAIに質問できます。AIはこの記事・AIToday の過去記事・Wikipedia を読み、出典を付けて答えます。Q&Aはこのページに公開され、他の読者も読めます。
このようなAIの動きを、御社の業界・競合に合わせて毎日届ける法人プランもあります → 詳しく見る
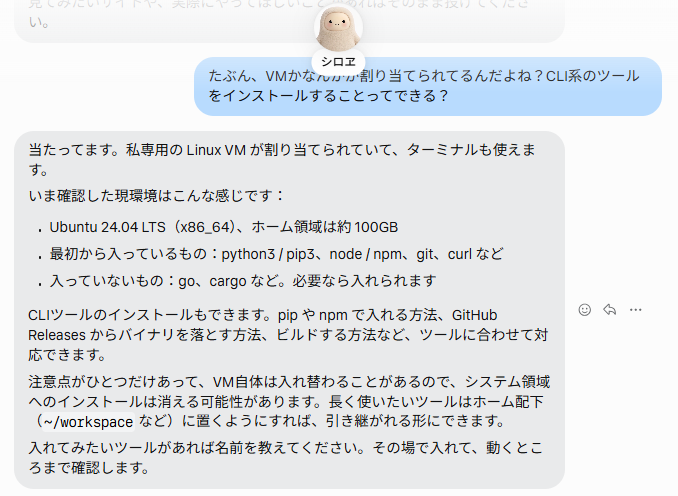
SORACOMの柴田氏がMetaのMuseエージェントのLinux VMからSORACOM Arcと共有Public Gate経由でIoTデバイスへの到達を検証
デジタル庁が政府AI「源内」で「国会答弁作成支援AIアプリ」の試作版を約18万人の職員に提供開始し、第222回国会で検証する
MetaのAIエージェントMuseが日本でスマホ・ウェブアプリから利用可能に
Amazon CEOのAndy Jassyは、外部の買い物エージェント経由の購入は少なく体験は不十分だとアナリストに語った
Charles SchwabはClaude for Financial Advisors、Ester、NevisをSchwab Advisor Centerに統合し、AI採用の小規模RIAにも直接インセンティブを提供する
Octusはデータサイエンスモデルを通じて年間200億超のトークンを振り分けていると発表