
何が起きたか
K-Dense-AI/scientific-agent-skills(177スキル、MIT)の追加APIキー不要の2スキルを検証。
なぜ重要か
価値は統計判断の訂正ではなく、口頭の結論を査読者が確認できる再現可能な数値で裏付けた点にあり、スキルは検定の選択よりも根拠の提示の仕方を変える。
こういう要約が、毎朝あなたのメールに届きます。
この検証は毎日AIニュースを1本確認するチャレンジの17日目として実施され、有料APIキーが必要な候補を避けるCLAUDE.mdのルールに従った。これにより177スキルのリポジトリはstatistical-analysis(Pingouin、SciPy、statsmodels、PyMC上に構築)とliterature-review(公開PubMed・arXiv APIを使用)に絞られた。セットアップ自体で2つの環境問題が判明した。インストールコマンドはClaude Codeの自動モード分類器により外部コード実行としてブロックされ、人間が許可するまで通らなかった。またWSLのUNCパスからWindows版Node.jsでインストールすると、CLIがC:\WindowsにフォールバックしてEPERM mkdirエラーで失敗し、UNCでないWindowsパスから実行すると成功した。
統計比較にはグループAに外れ値を含む架空のパイロットデータを使った。スキルなしの条件でもClaude Codeは外れ値、分散不等、小標本を理由にMann-Whitney Uを既に挙げたが、検定統計量やp値は示さなかった。スキルありではassumption_checks.pyが実行され、記述統計、Shapiro-Wilk検定(グループA p=0.000127で非正規、グループB p=0.248496で正規)、Levene検定(p=0.241、variance_ratio=224.37)、Welch t検定、Mann-Whitney Uの結果を出力し、55を除外した感度分析も行った。結論は一致したが、報告には数値と、n=6でWelch検定が非有意でも効果なしと解釈すべきでない旨の注意が加わった。
literature-review側ではREADMEからは見えない構造が明らかになった。同梱スクリプトは検索エンジンではなく後処理ツールである。arXivで「Mann-Whitney AND outlier」が0件を返すと、Claude Codeはクエリを4パターンに言い換え、最終的にcat:stat.ME AND abs:"Mann-Whitney" AND abs:robustで8件を得た。スキル自身の報告は、outlierという語を中心に扱う論文は少なく、ヒットはロバスト性や裾の重さといった隣接概念だったと注記した。
業界と使っているAIツールを選ぶと、仕事に関係するニュースが毎朝届きます。
登録無料・Googleアカウントなら30秒・いつでも解除できますAITodayについて →
この記事についてわからないことをAIに質問できます。AIはこの記事・AIToday の過去記事・Wikipedia を読み、出典を付けて答えます。Q&Aはこのページに公開され、他の読者も読めます。
DeepSeekがDeepSeek-V4.1-Flash-1017を公開
NECの野口圭氏は、従業員エンゲージメントが19%まで低下し、10人中8人が退職を希望していたと述べ、立て直しは「言い訳の文化」を終わらせ、分散した社内データを統合することから始まったと語った
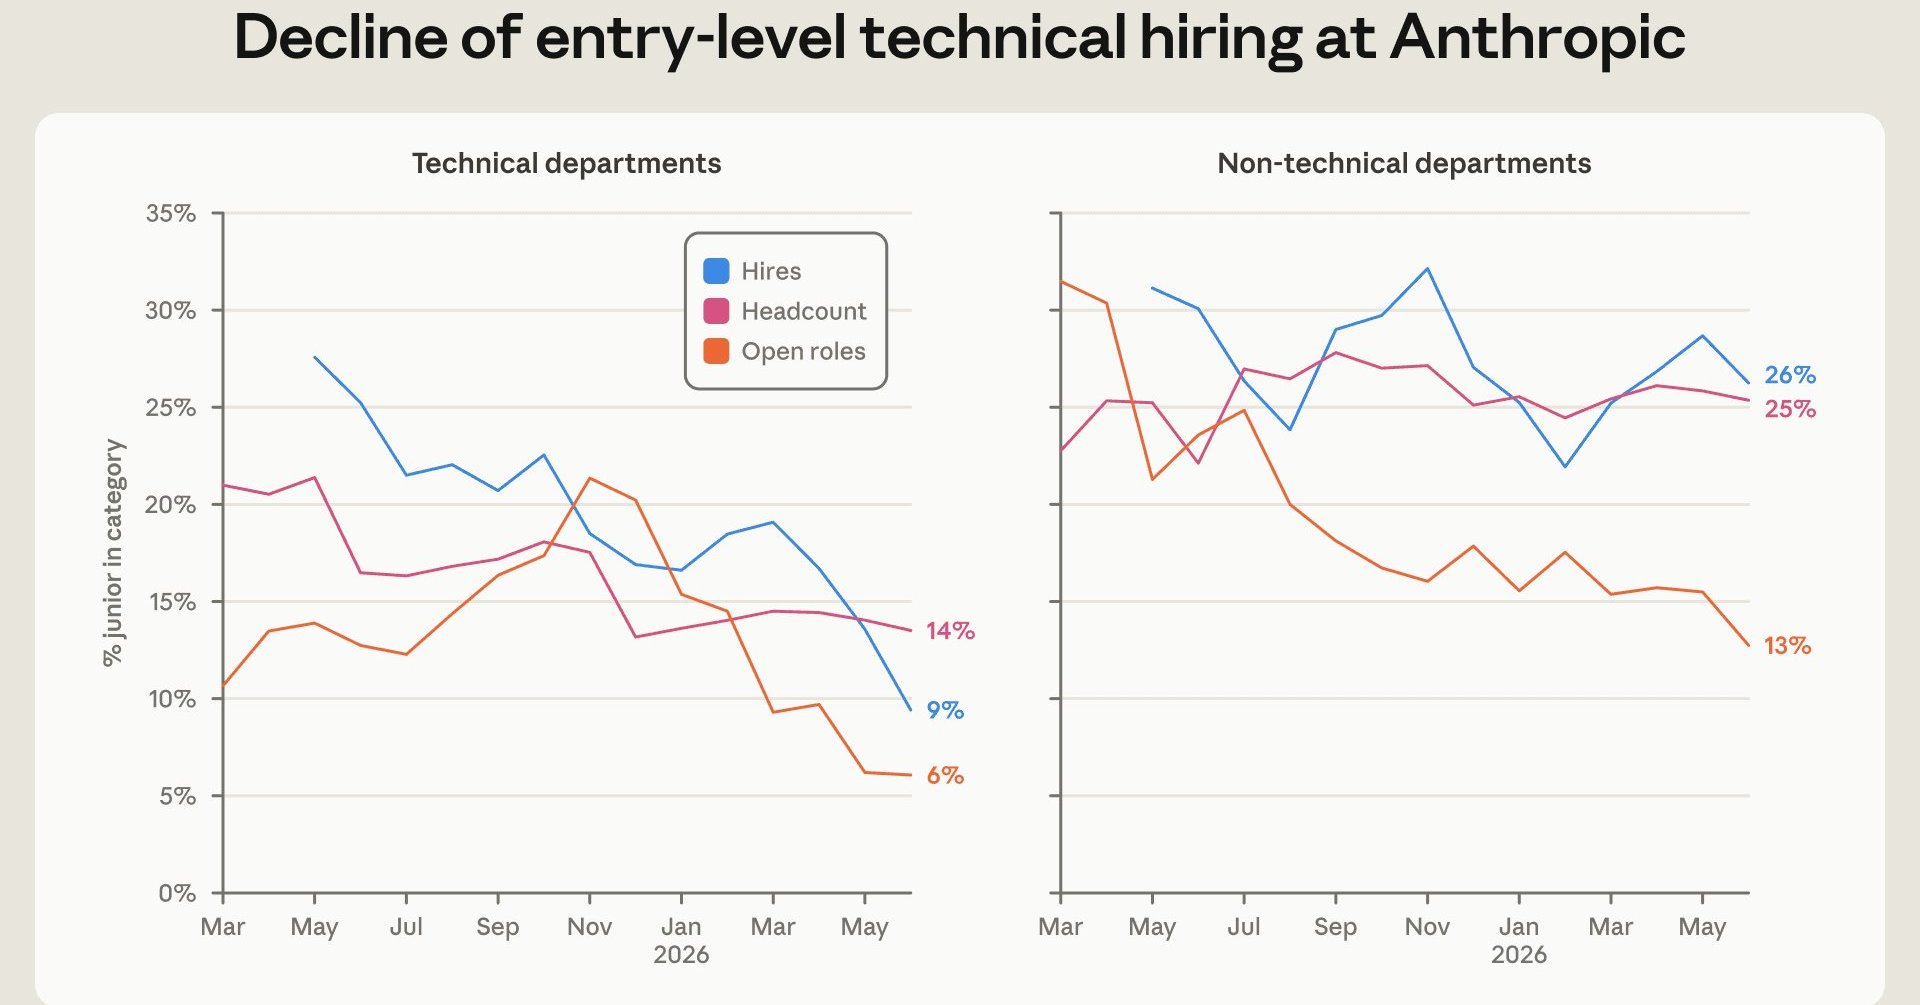
Anthropicの社内報告書によると、技術系職員に占める初級職は21%から14%に、技術系採用に占める初級職採用は27%から9%に減少した
Simon Willison氏がデバッグ用プラグイン「llm-echo 0.5」を公開
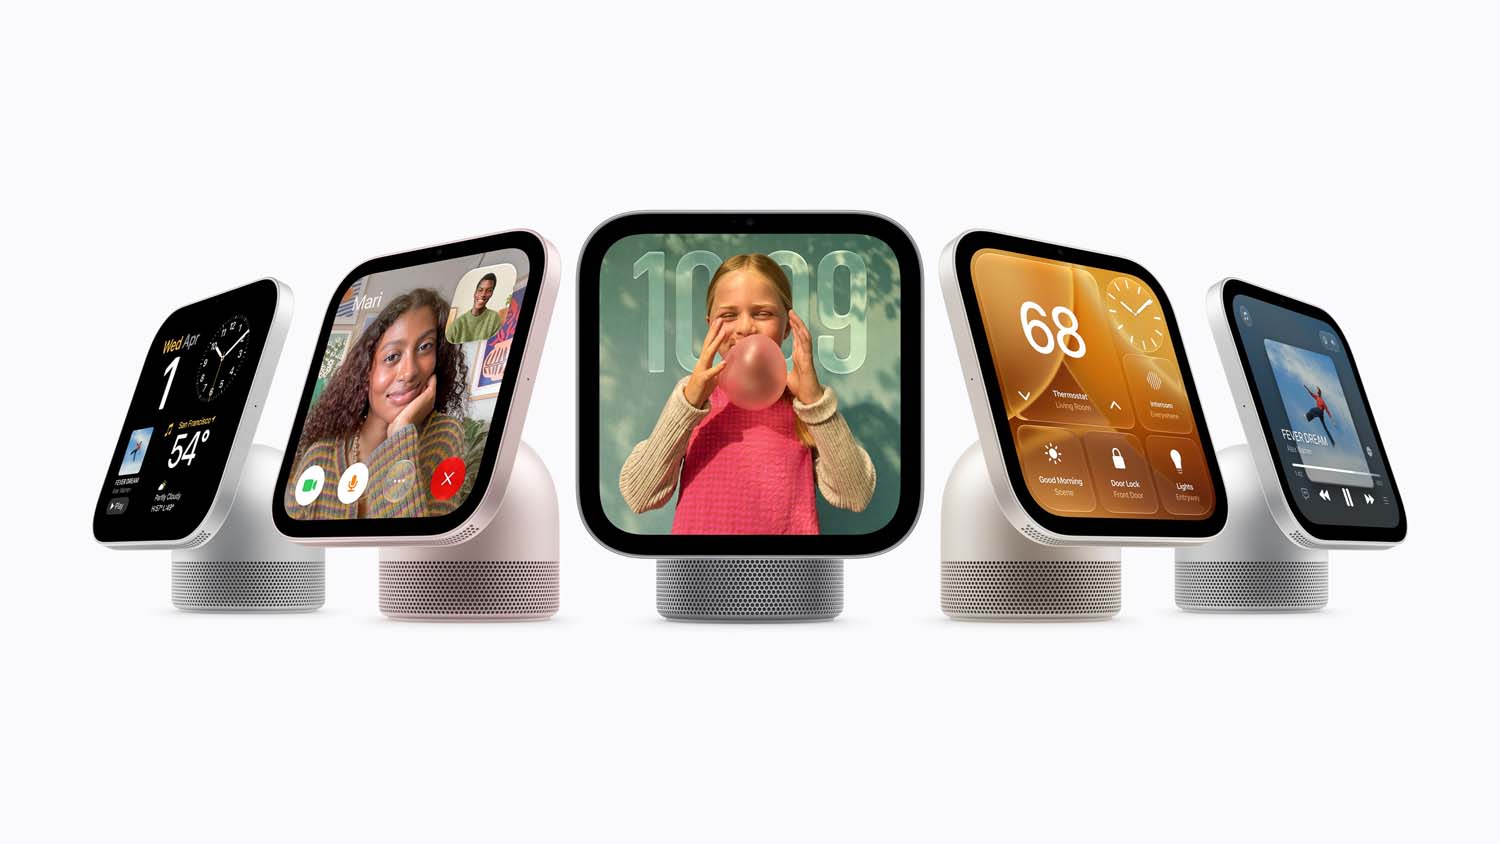
10月13日(米国時間)、アップルはSiri AIとHomeKitで動作しApp Store非対応の299ドルのスマートホームディスプレイ「HomeView」を発表した
理学療法士歴10年以上のPitchiPT氏が2026年6月頃からAI活用のプログラミングに本格着手し、今はスマホからCodexを操作してアプリや自動化システムを開発している

