何が起きたか
分類器が猫90%/犬8%/その他2%を返す例を示し、Softmaxはスコアの合計を1にするだけで、モデルが90%の確率で正しいわけではないと解説。
なぜ重要か
Guoらは深層ネットワークが常に良好に較正されているわけではないと報告。単一ラベルが実際の曖昧さを捉えられない場合、モデルの自信がユーザーが想定する精度から乖離し得ると著者は警告する。
こういう要約が、毎朝あなたのメールに届きます。
記事は標準的な画像分類器が確率を出す仕組みを辿る。生のクラススコアがSoftmaxを通って合計1になり、学習ではワンホットラベルに対してCross Entropyを最小化する。この過程だけでは、出力が実世界の信頼できる頻度になるわけではない。著者はGuoらの発見を挙げ、深層ニューラルネットワークが必ずしも良好に較正されるとは限らず、深さ・幅・正則化・Batch Normalizationが較正に影響し得ること、それを測るのがECEであると指摘する。一方でECE自体にも、確信度のビンの区切り方に敏感といった限界があると注記する。
より深い問題は定義に関わる。画像に猫と犬が両方写っている場合、100人に尋ねれば60人が猫、40人が犬と答えるかもしれないが、データセットには「猫」という単一ラベルしか付いていないことがある。著者は、だからといってそうした画像が常に60:40に分かれるわけではないと慎重に述べ、この人間の回答分布との不一致を通常のECE劣化と混同すべきではないとする。ECEは与えられたラベルに対する較正を測るものだからだ。
同じ論理はLLMにも拡張される。日本の最も有名な大学を確信度付きで尋ねると、ChatGPTは「東京大学 — 確信度:95%」と返したが、著者は「有名」が国内での認知度、世界的な認知度、研究水準のいずれを意味し得るため正しさを一意に評価できないと指摘する。Coleらは、曖昧な問いでは複数の生成回答間の一致を見ることがモデルの尤度と並んで有効だと発見したと引用される。結びの警告は、AIのパーセントは正しさとして直接読むのではなく「何の90%か」と問うべきだというものだ。
業界と使っているAIツールを選ぶと、仕事に関係するニュースが毎朝届きます。
登録無料・Googleアカウントなら30秒・いつでも解除できますAITodayについて →
この記事についてわからないことをAIに質問できます。AIはこの記事・AIToday の過去記事・Wikipedia を読み、出典を付けて答えます。Q&Aはこのページに公開され、他の読者も読めます。
このようなAIの動きを、御社の業界・競合に合わせて毎日届ける法人プランもあります → 詳しく見る
MIT Technology Review Insightsのスポンサード記事は、エージェントAIを大規模に安全に運用するには、従来の防御ではなくデータリネージが必要だと主張している
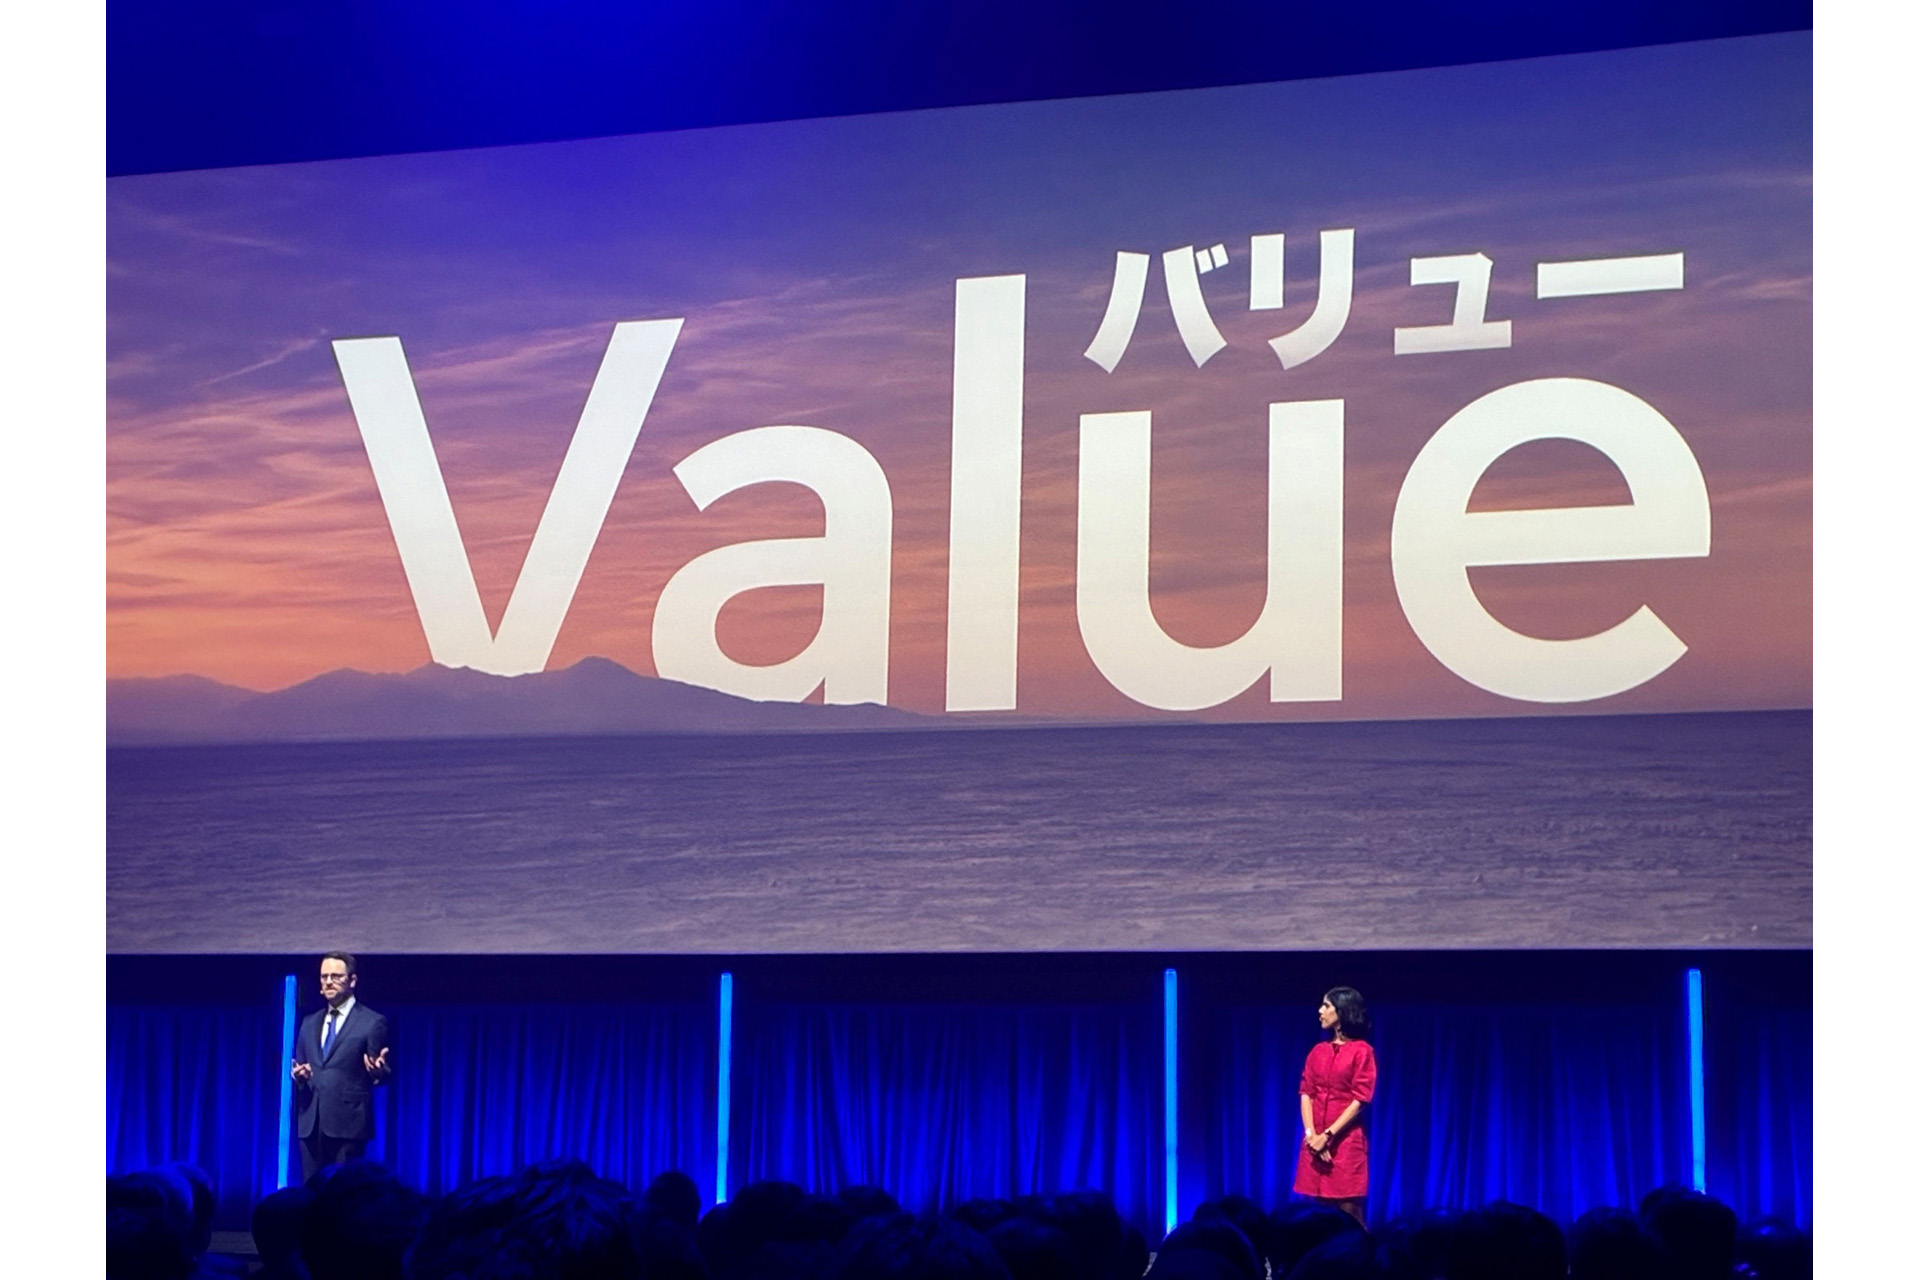
ガートナージャパンは2026年第2四半期の1000人超調査で、AI施策の正の価値獲得は58%、技術と事業リスクを整合させるCIOは25%にとどまると述べた
隔離ラボでClaude Opus、Sonnet、Haikuを組み合わせKali LinuxでMetasploitable2を攻撃し、27分で12件の脆弱性を発見、3つのシェルを取得
BPR Prot.がClaude CodeとCodexに同じSupabaseメモアプリを12回作らせ、全回RLS有効・公開キーのみだが、読み取り範囲未明示の6回は共有読み取り、Codexの1回はusing (true)で…
AnthropicはEPFL、MIT、StarkWare、Succinctと共同構築したゼロ知識証明システム「FlashProve」をApache 2.0の下で公開した
カーネギーメロン大学のIdeaTasteが6つのLLMによる9万件超の提案を2026年に4つの研究コミュニティの実論文と照合し、引用一致で人間の約26%、アイデア一致で約18%に達した


