何が起きたか
Vercelが最新のPython向けAI SDKを公開。uv add aiでインストールでき、typesafe-ai/jevモデル経由でJevと直接対話する実験的evaluate() APIを追加。
なぜ重要か
Jevは汎用分類器のように動作し(タスク固有の学習なしで入力を分類)、タスクごとにデータを収集・ラベル付けせず狭い意思決定ツールを構築できる。
注目点
VercelはJevが誤りを犯すと注記し、独自テストでも隙が見えた。例えば半端に入力されたPython式 "what's" + " up を英語と分類した。
誰に効くか従来は狭い意思決定タスクごとに別々の分類器を訓練する必要があったPython開発者やデータサイエンティストは、単一のevaluate()呼び出しでJevを試せるようになった。ただしVercelは自身のユースケースでの精度検証を推奨している。
こういう要約が、毎朝あなたのメールに届きます。
Jevの起源は古いアイデア、すなわち機械学習の古典的な基本要素である分類器にある。従来は新しいタスクごとに分類器をゼロから訓練した——例えばスパムフィルタリング用にラベル付きメールを集め、その領域にモデルの重みを調整する。Jevのチームは代わりに大規模言語モデルを分類器に変えた。すでに幅広い人間の知識を備え、タスク固有の訓練が不要だ。だから安価で高速であり、自由なテキストではなく、定義した型と選択肢に準拠した構造化JSONを返す。
VercelのPythonチームはJevのAPIをほぼそのままAI SDKにラップし、表面を小さく保った——evaluate()関数1つと少数の補助型だけ。ブログでは2つの実践テストを紹介する。1つ目は、Vercelのエンジニアが英語とPythonを区別する必要があったPython REPL機能を再訪した。2日かけて訓練した手製分類器は不安定に感じられ、Jevはより良い成績だったが、それでも半端に入力された式 "what's" + " up を英語とラベル付けした。2つ目は、エンジニアが文字を選ばせ、次に抽象構文木ノードを選ばせてJevにPythonコードを書かせようとした。生成されたコードは構文的に有効だが大半が誤りで、LLMがプロンプトを詳細な計画に展開して初めて改善した。
結論は狭いが有用だ。Jevは厳密な意思決定向けに作られており、汎用の文章作成向けではない。特定のユースケースで十分な精度があるかはチーム自身が検証する必要がある——2つの例は、答えが質問を具体的な選択肢にどれだけうまく落とし込めるかに大きく依存することを示している。
業界と使っているAIツールを選ぶと、仕事に関係するニュースが毎朝届きます。
登録無料・Googleアカウントなら30秒・いつでも解除できますAITodayについて →
この記事についてわからないことをAIに質問できます。AIはこの記事・AIToday の過去記事・Wikipedia を読み、出典を付けて答えます。Q&Aはこのページに公開され、他の読者も読めます。
Ghost AIはAndreessen Horowitzがリードし、Abstract、Audacious Ventures、Nova、SV Angelが参加した1100万ドルの調達を実施
OpenAIは数週間以内にEUの全ChatGPT・Codex有料プランユーザーへ不可視のテキスト透かしを展開し、検出ツールtextGrainの報告書を公開
スタンフォード大学やMicrosoft Researchなどの研究チームが最先端AIモデル8種類に6800以上のタスクを実行させた結果、32%のケースで低価格モデルの総コストが高くなった
Reflectionがパラメーター数5010億・アクティブ230億のオープンモデルBeamを発表
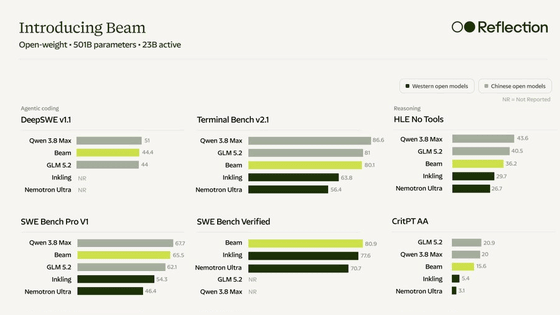
Reflection AIが5010億パラメータのオープンソースLLM「Beam」を公開
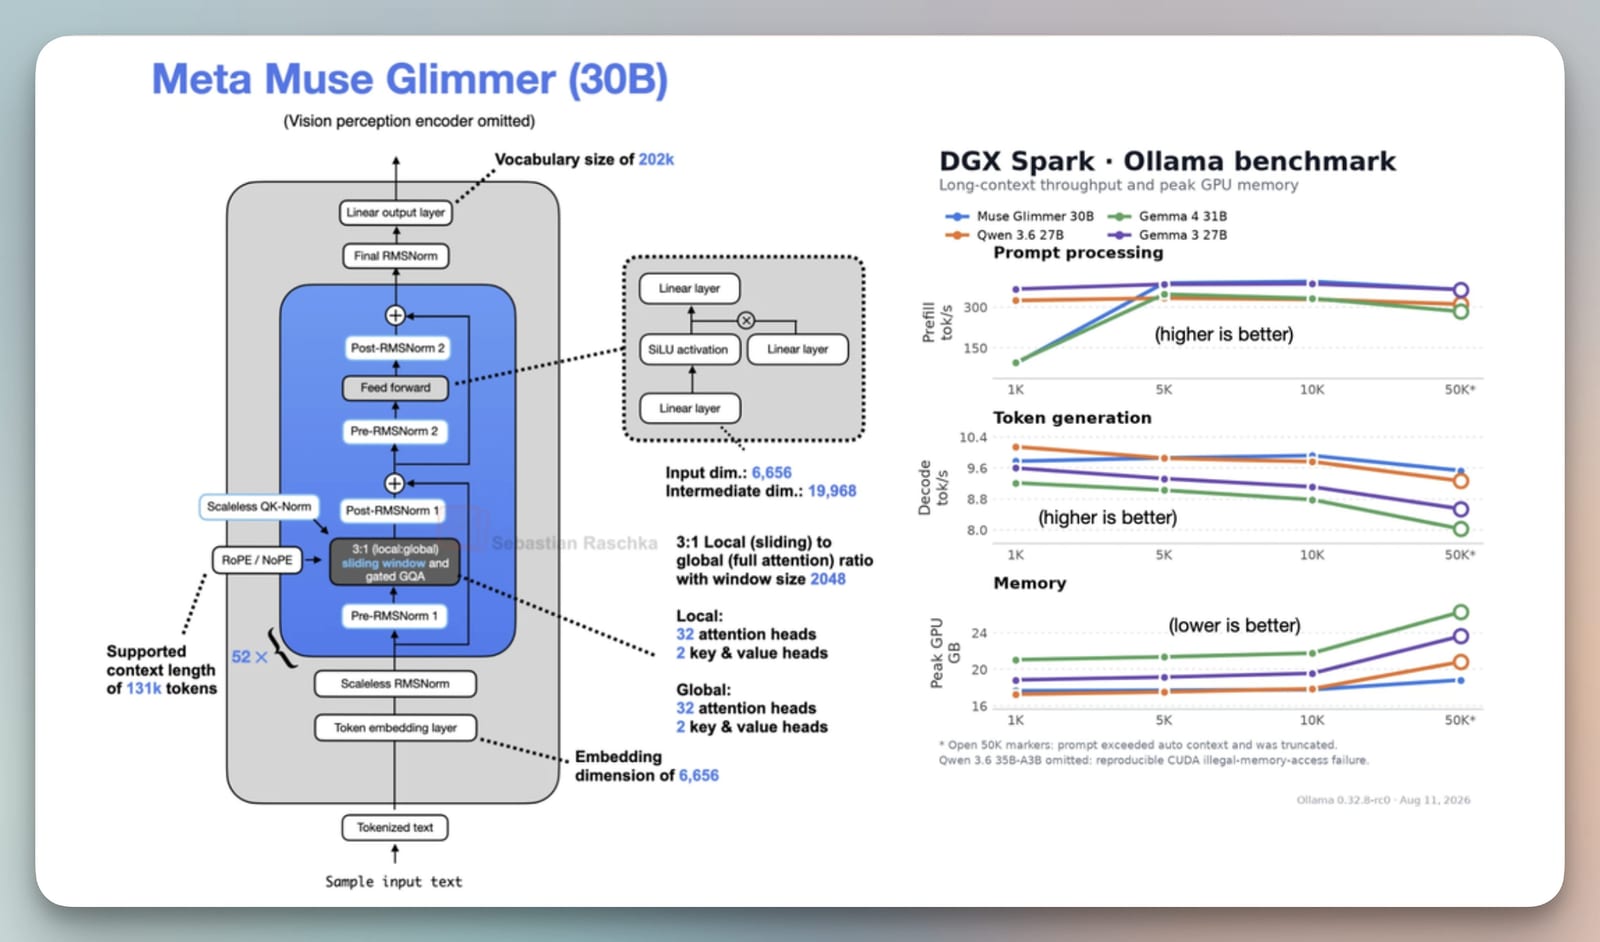
Meta Superintelligence Labs初のオープンモデルMuse Glimmer(30B)がApache 2.0で公開され、0.44%のLoRA訓練で数式画像からLaTeXへの変換を改善できる