何が起きたか
GitHubは103.9 million件のGitHubプルリクエストと19言語・187リポジトリの219件をもとに構築したReviewBenchを公開した。
なぜ重要か
後に行う本番実験と同じ方向を示すオフラインのシグナルが得られるため、測定された改善がユーザーにとって意味のある向上を反映している可能性が高まる。ただし方向性を示す指標であり、保証ではないとしている。
注目点
エージェントの能力が高まるにつれ、ベンチマークの予測精度が保たれるかどうか。
誰に効くかこれはAIコードレビューエージェントを構築または購入するエンジニアリングチームに影響する。本番導入を決める前にシステムを比較できる公開の尺度を与えるからだ。また、今後自分のエージェントをリーダーボードに提出することになるシニアエンジニアやメンテナーにも関わる。
こういう要約が、毎朝あなたのメールに届きます。
エージェント型コードレビューは、コードが出荷される前にプルリクエストを検査して問題を捉える用途でますます使われているが、チームにとって、こうしたAIレビュアーが実際にどれだけ機能するかを測るのは難しかった。既存のベンチマークはラベルの品質、網羅性、実世界での代表性の間でトレードオフになりがちだったため、GitHubは三つを兼ね備えるべくReviewBenchを構築した。このベンチマークは103.9 million件のGitHubプルリクエストを分析し、言語、リポジトリの規模、さらにはプルリクエストの規模までモデル化し、小さな単一ファイルの変更が支配的にならないよう、レビュー対象となる中間層と裾を意図的に重み付けしている。正解データは、人間のレビュアー、後続コミット、静的解析ツール、最先端LLMという複数来源のゴールデンセットから得ており、重複する指摘は統合し、すべての指摘を公開されたルーブリックに基づきLLMジャッジが検証している。データセット構築に関わっていないシニアエンジニアがすべての正解指摘を再ラベル付けし、ReviewBenchと96.6%の割合で一致した。
ベンチマークは2系統・6指標を報告する。固定のゴールデンセットに対するgrounded precision、recall、F1と、以前は知られていなかった有効な問題を挙げたエージェントを評価するaugmented precision、recall、F1である。これは重要だ。固定のゴールデンセットは、システムの能力が高まるにつれて必然的に不完全になるため、augmented指標は予期しない問題を見つけたエージェントにペナルティを与えるのを避けられる。ユーザーは結果を深刻度とカテゴリで切り分け、βパラメータを調整して網羅性を広げるかノイズを下げるかを選べ、リーダーボードもそれに応じて再ランキングされる。
GitHubはReviewBenchを使い、Copilotコードレビューを複数回のイテレーションで評価した。最近のある実験——複数の独立したモデル実行を単一のレビューに統合するマルチモデルアンサンブル——は、このベンチマークの価値を示した。ReviewBenchは適合率、再現率、コメント量の向上とレビューあたりコストの低下を予測し、その後のオンラインA/Bテストでは対応率が8.0%上昇、再現率が13.6%上昇、コメント量が61%増加、レビューあたりコストが8.0%低下した。深刻度レベルの評価も一致し、重大コメントが227%増加すると予測したのに対し、オンラインでは262%増加した。未解決の問いは、レビューエージェントが進化し固定のゴールデンセットが古くなるにつれ、この予測精度が保たれるかどうかである。今後の提出でもオフラインのシグナルが本番を追随するかが試金石となる。
業界と使っているAIツールを選ぶと、仕事に関係するニュースが毎朝届きます。
登録無料・Googleアカウントなら30秒・いつでも解除できますAITodayについて →
この記事についてわからないことをAIに質問できます。AIはこの記事・AIToday の過去記事・Wikipedia を読み、出典を付けて答えます。Q&Aはこのページに公開され、他の読者も読めます。
Technology Innovation InstituteがFalcon-H1-Arabic基盤の70億パラメータモデルFalcon-Emirati-7Bを公開
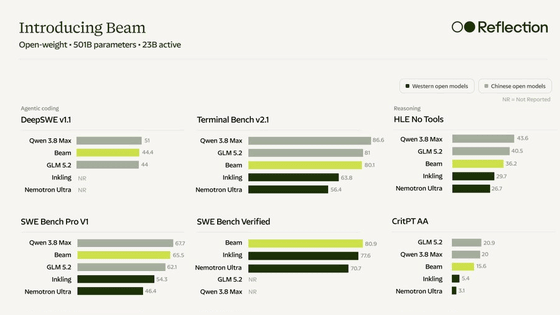
Reflectionがパラメーター数5010億・アクティブ230億のオープンモデルBeamを発表
Anthropicが9月28日にClaude Sonnet 5.5を公開した

2026年6月に開業届を出した個人事業主が、Claude Codeでリポジトリ「company」を作り、調査・経理・企画・営業・法務・デザインの6部署に仕事を振る仕組みを4月から約半年運用した
著者はUbuntu上のDockerでCentOS 5コンテナを構築し、Java 1.5、Apache、Tomcat、Seasar2を導入、http://localhost/helloで「Hello World」表示に成功…
LeapAIは2026年9月30日、『出張AI顧問』第1回を公開