何が起きたか
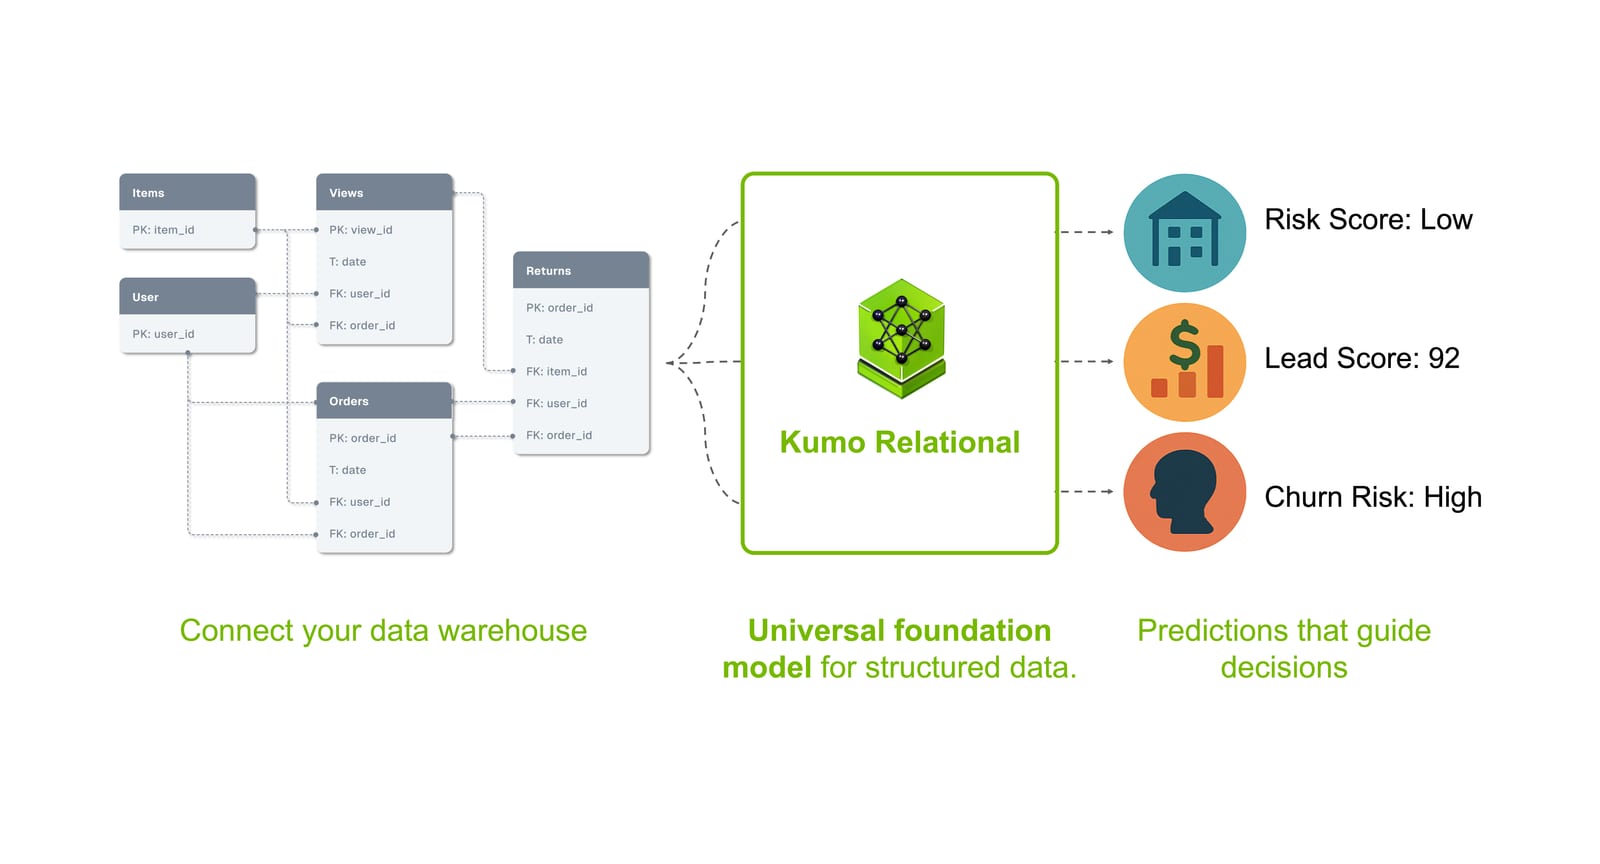
NVIDIAは企業データベース上でチャーンや需要、不正を直接予測する事前学習済みモデルKumo Relationalを公開した。15データベースの41タスクで既存手法を上回った。
なぜ重要か
数週間の特徴量エンジニアリングとタスクごとの学習が1回のクエリに置き換わり、これまで構築に手間がかかりすぎた予測プロジェクトにデータチームが取り組めるようになる。AIエージェントから呼び出せる設計だ。
注目点
Kumo RelationalはNVIDIAのstructured-data-modelsまたはNVIDIA NIMで本日から利用でき、コードはApache 2.0ライセンスで公開されている。
誰に効くかリレーショナルデータベース上で本番運用のXGBoostパイプラインを動かすデータサイエンス・機械学習チームが最も直接的な影響を受ける。特徴量エンジニアリングとタスク特化の学習を省ける代替手段として位置づけられているためだ。
こういう要約が、毎朝あなたのメールに届きます。
今回の公開は、大規模言語モデルがテキストにもたらしたのと同じ転換をリレーショナルデータベースに広げるものだ。1つの事前学習済みモデルがタスクごとの個別パイプラインを置き換える。NVIDIAはこの相似が3つの点で成り立つと主張する。最高のタスク特化モデルを上回る精度、はるかに簡素な本番導入、そして新たな用途を開く柔軟性だ。構造化データにおいて実務上の利点は、新たな予測がプロジェクトではなくクエリになることだと同社は述べる。
モデルは合成リレーショナルデータのみで事前学習されている。このデータは、単一テーブルのデータ生成器をリレーショナルデータベース全体に拡張したPluRel手法に基づくシステムが生成する。KumoのチームメンバーがPluRelの開発に携わり、原論文の共著者でもある。生成は軽量なため、NVIDIAによれば事前学習データは事実上無制限であり、PluRel論文は合成データベースを追加するにつれて事前学習損失がべき乗則に従い、その効果が実データベースにも及ぶことを示している。
RelBench V1上でリレーショナルモデルとシステムを比較するリーダーボードRelArena-αでは、Kumo Relationalはそのままの状態で精度と効率のパレートフロントに位置する。約17秒でElo 1,842に対し、最高スコアのエントリーrt-plurelはElo 1,878で約7,300秒。およそ430倍遅い。論文は厳しい条件下でもモデルが持ちこたえることも報告する。学習データのわずか0.2%をコンテキストとして使っても良好に動作し、外部キーリンクの最大75%を削除しても安定し、ノイズの多い列を多数追加してもほとんど劣化しない。
業界と使っているAIツールを選ぶと、仕事に関係するニュースが毎朝届きます。
登録無料・Googleアカウントなら30秒・いつでも解除できますAITodayについて →
この記事についてわからないことをAIに質問できます。AIはこの記事・AIToday の過去記事・Wikipedia を読み、出典を付けて答えます。Q&Aはこのページに公開され、他の読者も読めます。
AnthropicのIPO目論見書草案で、上半期売上高163億ドル、純損失807億ドル、最大7500億ドルの計算資源契約の可能性が開示された
中国が国有企業「国家データグループ」を設立
OpenAIは、同日修正されたPHPの脆弱性を、セキュリティ企業Califとの「Patch the Planet」プロジェクトでGPT-5.6 Solを使い発見したと発表した
KliqueはNVIDIA Nemotron 3.5 Super VL、OpenShell、Dynamo、NeMo Switchyardのプラットフォーム対応を発表
2026年第3四半期決算で、ASMLは新規リソグラフィ装置を前年同期の66台に対し113台販売
Tom Tunguz氏はGPU価格を整理し、DeepSeekの上限1カード時38.00ドルからSpaceXの実現価格2.44ドルまでを示した