何が起きたか
Vals AIがGPT-6 SolとClaude Opus 5.5をVibe Code Benchで単独およびチームでテストした。
なぜ重要か
チームははるかに多くのトークンを消費したのに測定可能な品質向上がほぼなかったため、モデルがすでにフルコンピュートで動作している場合、マルチエージェント構成への追加支出は無駄に見える。
誰に効くかAIコーディングアシスタントやその他のエージェントワークフローを構築するチームは、エージェントチームに1.8倍から5.1倍のコストを払うことで実際に出力品質が上がるかを確認したいだろう。Vals AIはほとんど上がらないことを発見したのだから。
こういう要約が、毎朝あなたのメールに届きます。
この発見は、AIモデルのチームがより困難な問題に取り組む方法として喧伝されるマルチエージェントアーキテクチャへの熱気が高まる中で出てきた。Vals AIのベンチマークは、GPT-6 SolとClaude Opus 5.5を使いVibe Code Benchで実施され、各モデルを単独およびチームで中程度と最大の推論強度で比較することで、その前提を直接検証した。コスト差は大きく——1.8倍から5.1倍——品質差はほとんど見えず、統計的に有意な7.3ポイントの改善を示したのは中程度の推論レベルでのGPT-6 Solのみだった。
Anthropic自身のOpus 5.5に関するデータも同じ方向を指す。同社のテストでは、より大きなチームが特定の性能水準に速く到達したが、10エージェントから100エージェントに増やしても24時間後のスコアはわずかに上がるだけだった。知識ベースのタスクでは、スコアは1エージェントの0.53から100エージェントの0.74に動いた——はるかに多くのトークンを伴う向上だった。Fable 5.1はLean定理証明タスクで10エージェント以上でより強い品質向上を示したが、全テストでOpus 5.5を下回り、知識ベースのスコアは30から100エージェントでわずかに低下した。
実用的な注意点はOpenAIの研究者Noam Brownによるもので、Dwarkesh Podcastで、その利点はタスクに大きく依存すると語った。ウェブ調査と数学は並列化がうまくいくが、小説の執筆はそうではなく、小説に10,000のエージェントを投入するのは10,000人を投入するのと同じくらい無意味だろう。OpenAIの開発者Eric Provencherは、エージェント同士の連携が崩壊するためエージェントスワームは最も無駄になりやすいと警告し、そのコストを「連携税」と呼んだ。
業界と使っているAIツールを選ぶと、仕事に関係するニュースが毎朝届きます。
登録無料・Googleアカウントなら30秒・いつでも解除できますAITodayについて →
この記事についてわからないことをAIに質問できます。AIはこの記事・AIToday の過去記事・Wikipedia を読み、出典を付けて答えます。Q&Aはこのページに公開され、他の読者も読めます。
AMDは10月9日に608.10ドルで引け、10月6日の記録的終値649.42ドルを6.36%下回った
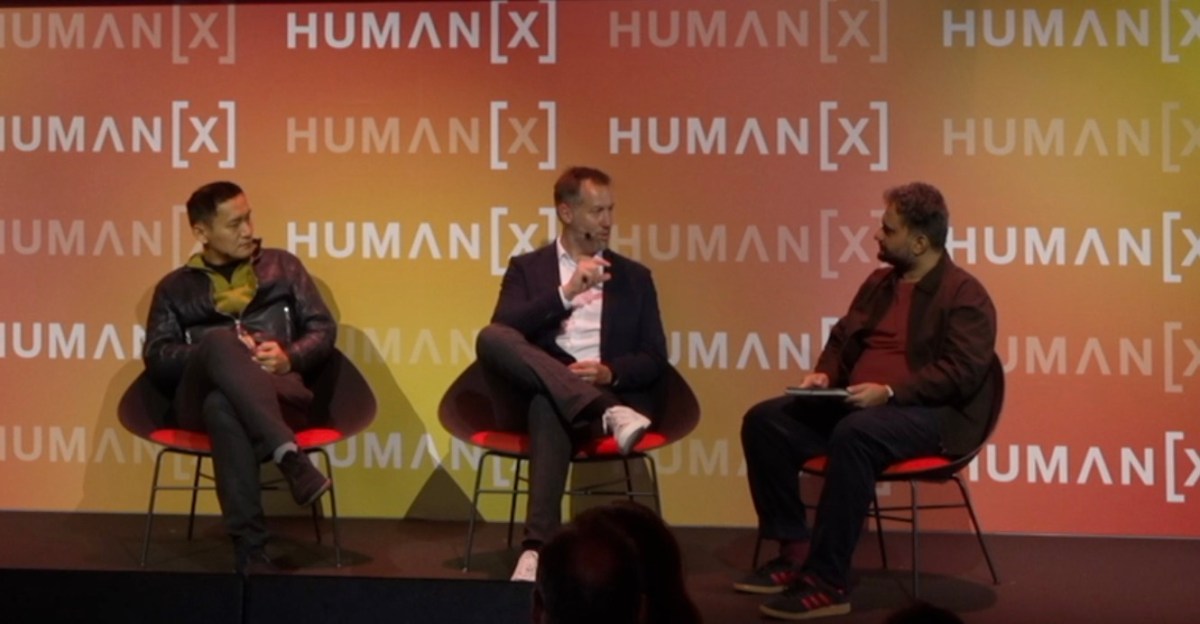
PolyAIのCTO Shawn Wen氏はHumanXカンファレンスで、全二重モデルはすでに存在するが、音声AIにはまだ「ChatGPTの瞬間」がないと語った
SiliconANGLEの寄稿でImagine ArtのM
ルールベース株研が2026年9月25日に投資可否チェッカー、2026年10月8日に急騰株チェッカーを公開し、約2週間半でコミット300回超、テスト800件超に到達した

Windows 10上のClaude Code 2.1.296で、Edit(../shared/partner/**)と書いたdeny規則は書き込みを一切阻止せず、起動時の警告もなかった
筆者が健康診断の結果をGoogle Geminiに読ませたところ、腎機能に関連する将来の透析リスクを指摘され、塩分と脂質を減らすよう言い渡された

