何が起きたか
Appleの研究者によるRLTL;DRは、失敗ごとにポリシーが洞察を書き、逆伝播でタスクから洞察への直接マッピングを内面化させる手法。
なぜ重要か
これらのデータセットでは標準的なGRPO学習はPass@1が0%から1%で横ばい。モデル自身にフィードバックを生成・内面化させると、教師モデルも解答例もない状況での学習障壁を突破できる。
注目点
論文はこの向上をタスクから洞察への内面化に帰す。4k件の(task, insight)タプルだけで学習する簡略版SFTL;DRがほぼ全性能を回復し、圧縮された学習パラダイムを示唆する。
誰に効くか検証可能な報酬なしの自己改善と強化学習に取り組むAI研究チームに有用でありうる。エージェントの成功の見込みが低いか皆無で、教師モデルも存在しないタスクでこの手法が機能するからだ。
こういう要約が、毎朝あなたのメールに届きます。
この論文は、検証可能な報酬を用いた強化学習における既知の問題に対処している。タスクが非常に難しく、エージェントの成功の見込みが低いか皆無の場合、標準的な学習では最適化の対象となる成功例を見つけられない。著者らはこの領域を研究するため、データセットをPass@128 = 0に絞り込んだ。そこでは蒸留元となる教師モデルも解答例も存在しない。この設定で、Qwen 3.5 9B Thinkingポリシーの標準的なGRPO学習はPass@1が0%から1%で横ばいとなり、論文はこの学習障壁の突破を目指す。
提案手法は学習シグナルの来源を変える。成功したロールアウトだけから学ぶのではなく、失敗のたびにポリシーに検証器の出力を見せ、自らTL;DR洞察を書かせ、その後のロールアウトはそれまでのすべての洞察を条件とする。著者らによれば、このコンテキスト内の洞察への逆伝播、すなわちタスク→洞察の直接マッピングの内面化が鍵である。評価時に洞察がコンテキストにない場合でもポリシーは12–13%のPass@1を達成するからだ。わずか4k件の(task, insight)タプルで学習した簡略版SFTL;DRがほぼ全性能を回復することは、「この種のタスクでは、この種のことを念頭に置く」という形の学習パラダイムの証拠として著者らは提示している。
この結果が最終的に何を意味するかは、このタスク→洞察の内面化がここで使われたツール呼び出しとコーディングのデータセットを超えて一般化するかどうかにかかっている。論文はこの圧縮されたパラダイムを、既存手法に取って代わる確定したものではなく、今後の研究への着想として位置づけている。
業界と使っているAIツールを選ぶと、仕事に関係するニュースが毎朝届きます。
登録無料・Googleアカウントなら30秒・いつでも解除できますAITodayについて →
この記事についてわからないことをAIに質問できます。AIはこの記事・AIToday の過去記事・Wikipedia を読み、出典を付けて答えます。Q&Aはこのページに公開され、他の読者も読めます。
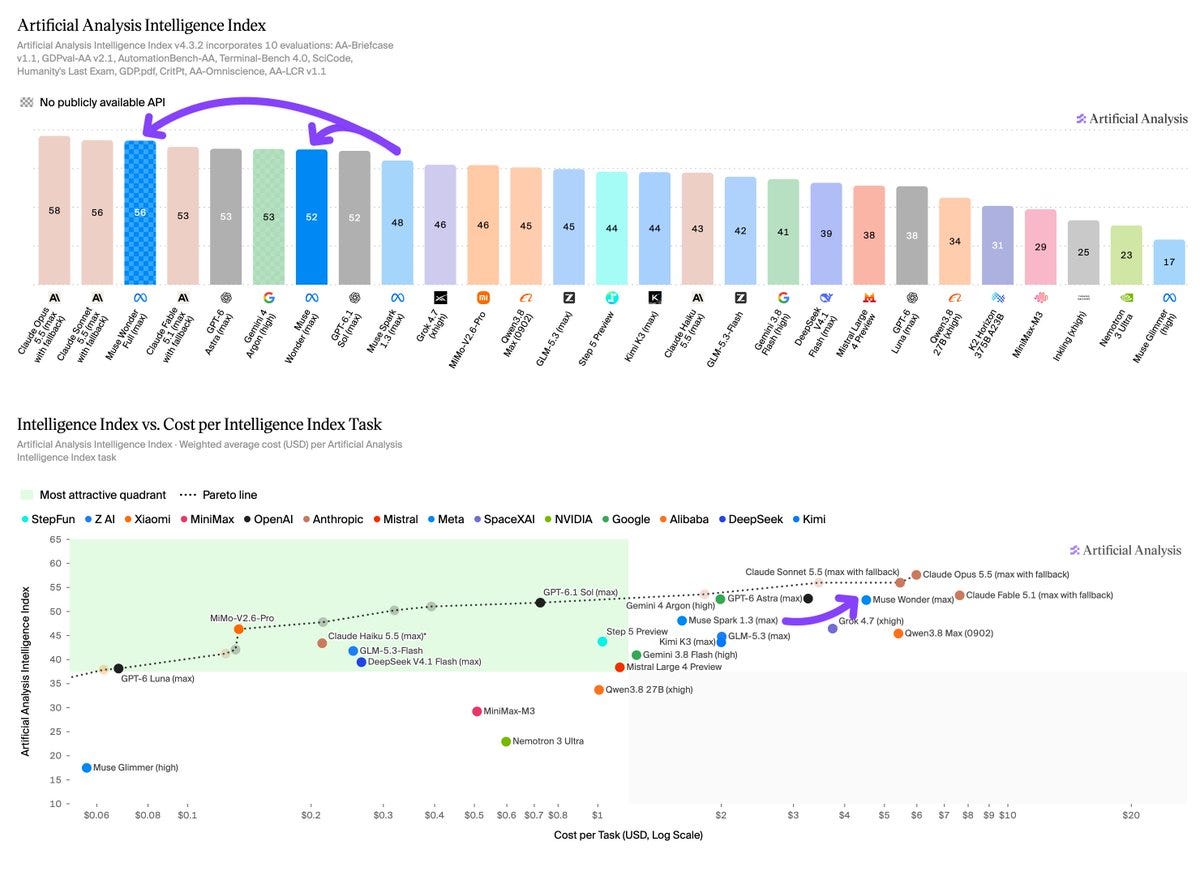
Metaは新モデル「Muse Wonder」と「Muse Wonder Full」の2つを発表し、ザッカーバーグ氏はOpenAIとAnthropicの最新モデルに匹敵すると述べた
トランプ政権の超知能タスクフォースは、AI企業に対し製品の逸脱行為を報告し直ちに是正するよう命じ、ビザ申請を提出したAnthropicのテストモデルの事例を挙げた
Meta Superintelligence LabsはMuse WonderとMuse Wonder Fullを投入し、Artificial Analysis Intelligence Index v4.3で52と56…
SB Intuitionsが10月13日、Sarashinaサービスの無償β版を開始
ビジネス読者向けの日本語解説記事が、ローカル推論――AIモデルを手元のPCやスマートフォンのCPU、GPU、NPUで動かし、データを端末外に出さない技術――を説明した
Check Point Researchの9月分析によると、世界の組織は週平均2,803件の攻撃を受け、前年比48%増