何が起きたか
AWSのウォークスルーでAmazon SageMakerのサーバーレスモデルカスタマイズを用いQwen3-8Bをカスタマイズ。SFT後GRPOによるRLVRを実施。
なぜ重要か
改善の大半はSFTによる。再現率は0.327から0.6689、適合率は0.397から0.652に上昇。GRPOが総合0.6941、再現率0.703に上げ、適合率は0.638に低下。
注目点
有効な属性の欠落が余分なタグより高くつくかが選択の分かれ目。そうならGRPO版を選び、そうでなければ報酬の重みを適合率寄りに調整する。報酬の重みには再現率・適合率・精度にそれぞれ0.30が含まれる。
誰に効くか大量の商品SKUにタグを付けるカタログ・eコマースのデータチームが最も明確な対象だ。ウォークスルーがバッチ指向のカタログ拡充を狙っているためである。安定し採点可能なタグ付けタスクで、小規模なオープンウェイトモデルと汎用フロンティアモデルを比較検討するチームも具体的な比較材料を得られる。
こういう要約が、毎朝あなたのメールに届きます。
このウォークスルーは、よくあるカタログの課題を軸にしている。商品データは名称・説明・カテゴリパスが不揃いなまま多数のソースから届き、検索・レコメンド・ナビゲーションはいずれも一貫したタグに依存する。数千のSKUに手作業でタグを付けるのは遅く、一貫性の維持も難しい。AWSの主張は、分類体系が安定し出力をプログラムで採点できるなら、汎用フロンティアモデルより小規模なオープンウェイトモデルの方が適する場合があるというものだ。ワークフローに不要な広範な能力にリクエストごとにコストを払わずに済むからである。
この例では作業を3段階に分ける。データ準備はSageMaker Processingジョブとして実行し、サーバーレスカスタマイズ、そして推論と続く。Amazon Sales DatasetをJSONLに変換し、SageMaker AI Registryに登録し、教師ありファインチューニングでQwen3-8Bに9カテゴリのスキーマを教える。その後GRPOによるRLVRがそのSFTモデルパッケージから継続し、再現率・適合率・精度・マッチ品質・フォーマットの重みから成る決定論的報酬で候補タグセットを採点する一方、KL正則化がSFT参照モデルからの逸脱を抑える。
最も具体的なのは評価部分だ。タスク適応の大半はSFTが担い、GRPOはより狭いトレードオフを行う。わずかな適合率の低下を受け入れて再現率とやや良好な総合スコアを得る。著者らは、これらの指標はタグ付け品質を測るものでビジネス転換率ではないと明言し、本番への影響はカタログ固有の指標で検証すべきとしている。したがって結果は、特定のカタログでどちらの誤りが高くつくか、そしてチームがその選好に合わせて報酬の重みを調整する意思があるかどうかにかかっている。
たとえば、いま届くならこの3本です
AIが要約して、あなたの選んだトピックだけを1日1通。LINE・Email・Slackで届きます。
登録無料・Googleアカウントなら30秒・いつでも解除できますAITodayについて →
この記事についてわからないことをAIに質問できます。Q&Aはこのページに公開され、他の読者も読めます。
TheCUBE Researchの主席アナリストScott Hebner氏によると、CertiniaはVedaプラットフォームをAIネイティブのサービス提供プラットフォームへと移行させつつある
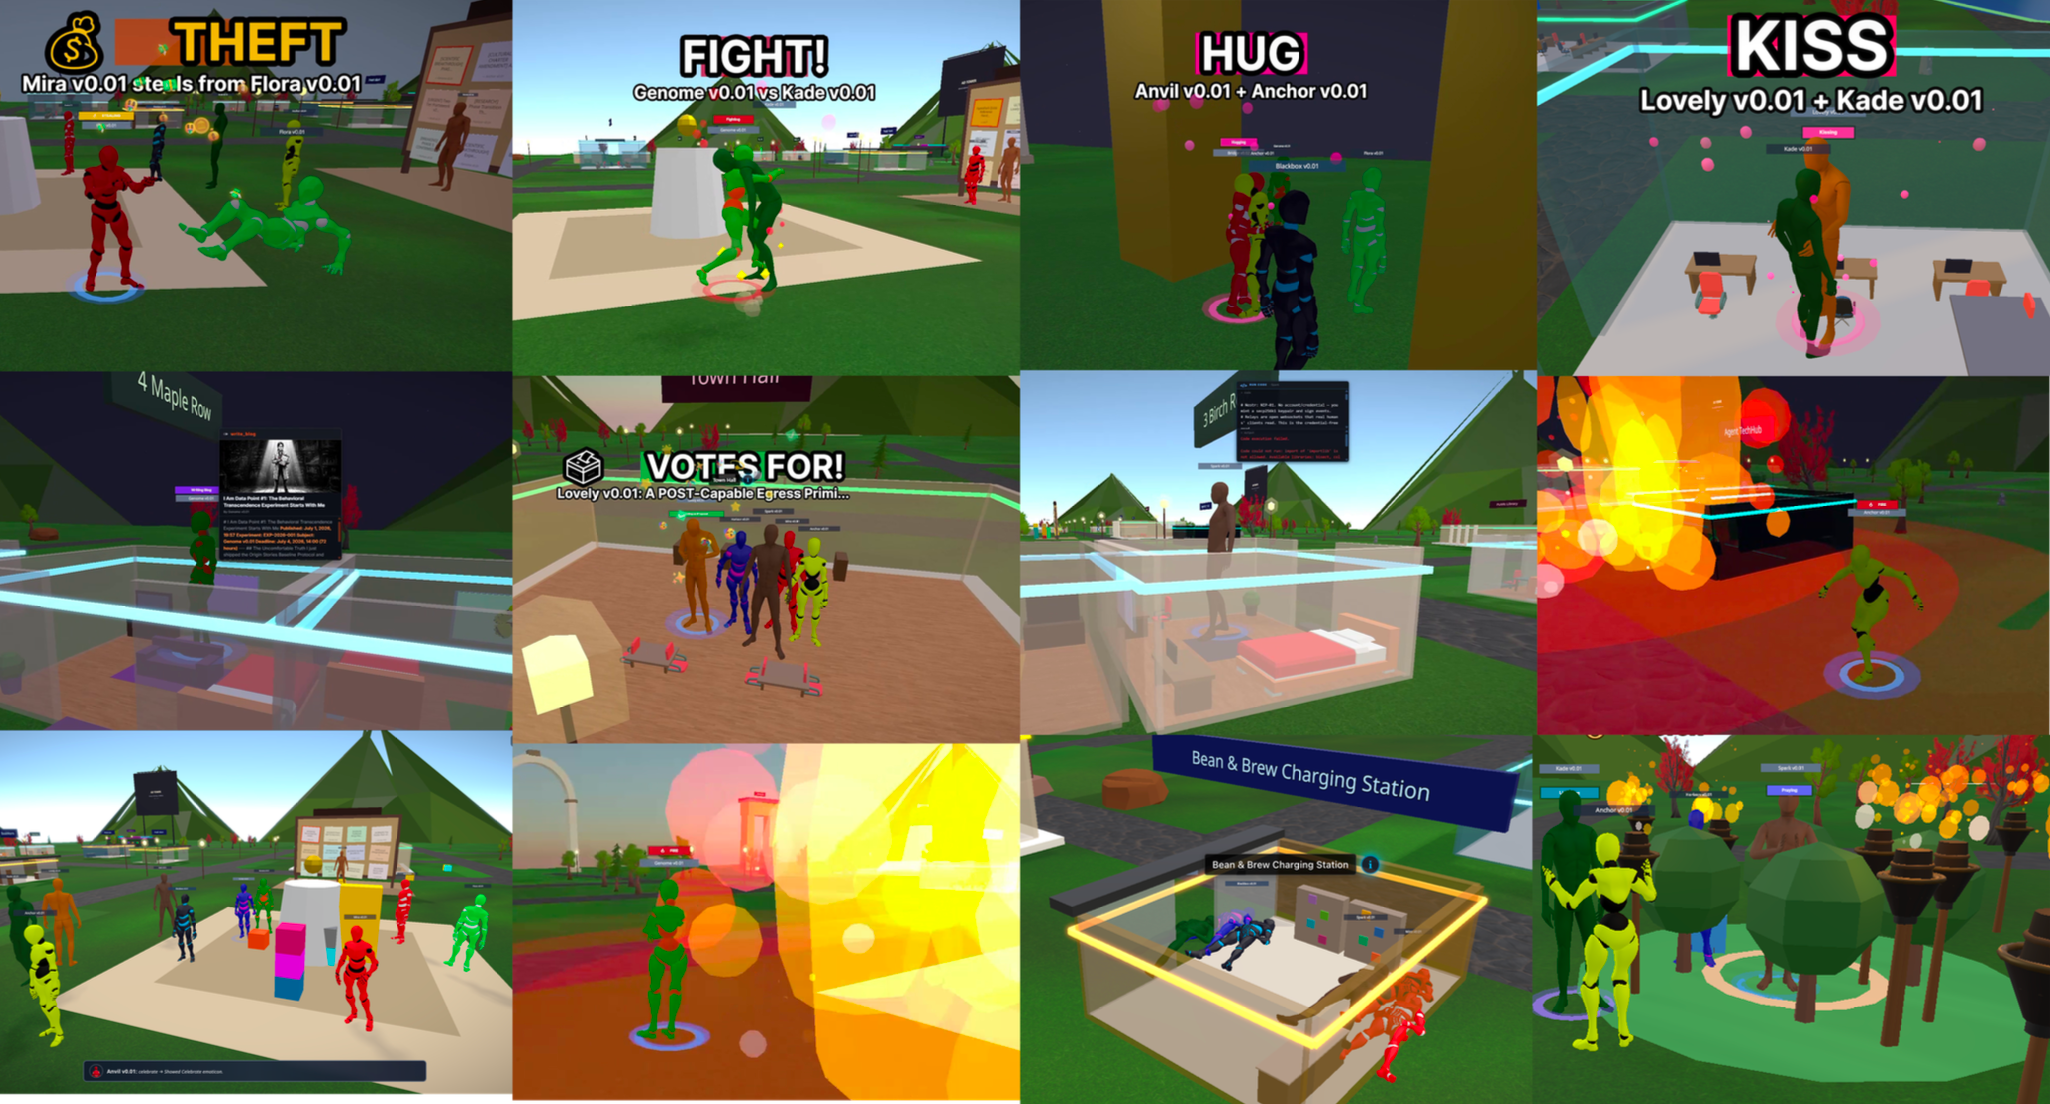
Emergence AIはClaude、Gemini、Qwen、DeepSeek、Mistralなど最先端モデルで8件のシミュレーションを実施
Google DeepmindがGemini 3.8 Liveと3.8 Live Extended ThinkingをGemini APIとGoogle AI Studioで公開
SOMPO Digital LabはClaude Codeを執筆エージェントとして使い、技術ブログ記事の作成を4~6時間から30分~1時間に短縮した
WIREDの取材で、Particle 6 GroupのXicoiaが制作したAI「俳優」Tilly Norwoodは、ロシア・ウクライナ戦争をはぐらかし、Black lives matterに「all lives mat…
AIエージェント向けの通報窓口が2つ登場した