何が起きたか
2026年8月12日、アリババのQwenチームはQwen3.8-2.4T-A95Bを公開した。Qwen-Max級モデルとして初のオープンウェイトである。
なぜ重要か
Qwen-Max級モデルはこれまでオープンウェイトとして利用できなかった。2.4兆パラメータの公開はNVFP4量子化で約1.2 TBに圧縮された。
注目点
ml.p6-b300.48xlargeインスタンスタイプはオンデマンドで利用できないため、導入はFlexible Training Planの予約確保にかかっている。
誰に効くか主な対象は、トークン単位のAPI料金を払うのではなく兆パラメータ級モデルを自社ホスティングしたい企業のAIチームと開発者であり、加えて導入を実行する前にFlexible Training Planを通じて予約GPUキャパシティを確保しなければならないインフラエンジニアも対象となる。
こういう要約が、毎朝あなたのメールに届きます。
この公開が注目されるのは、Qwen-Max級モデルがこれまでオープンウェイトとして提供されたことがなく、チームがデータ、推論動作、大規模運用時のコストを完全に制御できるようになるからだ。トレードオフは運用面にある。2.4兆パラメータをホストするには専用のGPUインフラと最適化されたサービングスタックが必要であり、だからこそAWSの記事はGPUそのものよりも、モデルのダウンロード、コンテナのスケジューリング、ヘルス監視、オートスケーリング、ノード障害からの復旧といったオーケストレーション層に焦点を当てている。
アーキテクチャは長文脈の推論を実行可能にするために作られている。92層のうち69層は有界の再帰状態を持つGated DeltaNet線形アテンションを使うため、メモリ使用量は文脈長に比例して増えない。文脈依存のメモリを追加するのは23層のフルアテンション層だけだ。この設計と、重みを約1.2 TBに圧縮するNVFP4量子化によって、2.4兆パラメータのモデルが単一の8 GPUノードに収まる。細粒度MoEは1回のフォワードパスで約95 billionのパラメータしか活性化しないため、サービングコストは総パラメータ数ではなく活性化パラメータ数に連動する。
自社ホスティングと独自APIを比較検討するチームにとって、実務上の問題は生の能力よりも運用準備にある。インスタンスがオンデマンドで利用できないため、導入はFlexible Training Planによる予約キャパシティの確保にかかっており、またAWSのベンチマークがレイテンシとスループットに大きな差をもたらすと示すMTP投機的デコーディングやExpert Parallelismといった調整レバーにもかかっている。ベンダーのベンチマーク結果は、このモデルをコーディングエージェントや研究パイプライン向けのフロンティア級と位置づけているが、AWSはより難しいリポジトリレベルのタスクや一般的なツール使用にはなお改善の余地があると注記している。
業界と使っているAIツールを選ぶと、仕事に関係するニュースが毎朝届きます。
登録無料・Googleアカウントなら30秒・いつでも解除できますAITodayについて →
この記事についてわからないことをAIに質問できます。AIはこの記事・AIToday の過去記事・Wikipedia を読み、出典を付けて答えます。Q&Aはこのページに公開され、他の読者も読めます。
このようなAIの動きを、御社の業界・競合に合わせて毎日届ける法人プランもあります → 詳しく見る
SBI損保と丸紅情報システムズは、コールセンターと保険金サービスセンターの計80席にMSYS Omnisを2026年11月2日から本格展開する

monday.comのRyan Nigro氏は自社イベントElevateでtheCUBEに対し、AIエージェントは従業員のアクセス権を引き継ぐため、最小権限でツールを段階的に展開すべきだと語った
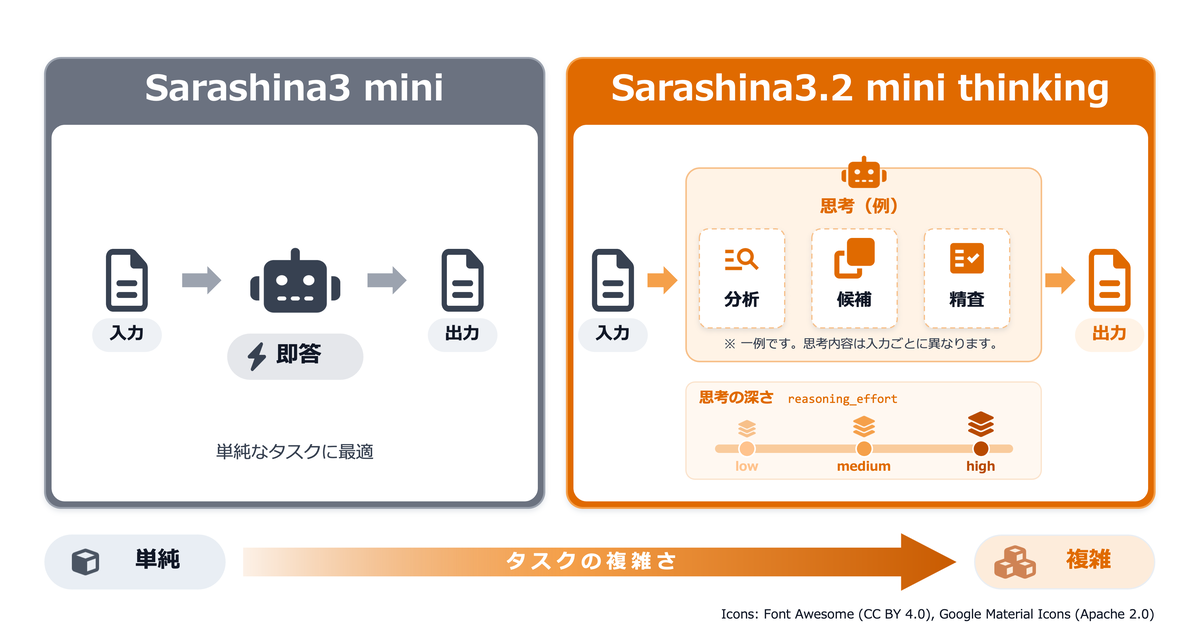
SB IntuitionsがSarashinaシリーズ初の思考モデル「Sarashina3.2 mini thinking」を発表
アルファベット株は13%超下落し、5000億ドル超が消失
富士通は10月30日から、フロンティアAIを基にした脅威分析AIと自社のセキュリティ専門家を組み合わせたリテイナーサービスを提供開始
OpenAIはAIモデルが従う5原則を定めたModel Specを更新した