何が起きたか
英語とフランス語の制御されたHuBERT設定で、補助言語分類器と言語別k-meansターゲットの2つの介入により、音素ABX誤り率が11.6%から10.4%に低下し、単言語の10.8%を下回った。
なぜ重要か
多言語音声モデルは一般に各言語で単言語モデルに劣っていたが、これは多言語学習の追加コストが不可避ではないことを示唆し、言語間の共有はほぼ維持されている。
注目点
利得の大半は言語識別を最初の訓練イテレーションに導入したときに得られた。後からまたは繰り返しの介入は効果が小さく、言語ごとの分離が増えたため、タイミングが決定的要因のようだ。
誰に効くか多言語音声認識や音声製品を手がけるチーム(1つのモデルで複数言語を扱う必要がある)は、この研究によれば、言語間の共有学習を犠牲にせずに単言語システムに近い精度を得られる可能性がある。
こういう要約が、毎朝あなたのメールに届きます。
この研究は音声AIの長年の謎に取り組んでいる。複数言語で訓練されたモデルは、総訓練データ量が同じでも、単一言語で訓練されたモデルより各言語で性能が低下する傾向がある。著者らは英語とフランス語の厳密に制御されたHuBERT設定でこれを検証し、多言語モデルと単言語モデルを直接比較できるようにした。
彼らの修正策は、補助言語分類器と言語別k-meansターゲットを使い、事前学習中にモデルへ言語の識別を促すことだった。この調整により、音素識別、語彙性能、韻律など言語品質の複数の指標が改善した。タイミングが重要で、訓練の早い段階で言語識別を導入すると最大の利得が得られ、後からまたは繰り返しの介入は効果が小さく、言語間の分離が大きくなった。
これらの結果は、言語識別が多言語ペナルティを減らす因果要因であることを示唆するが、研究は2言語と1つのモデルファミリーのみを対象とするため、この発見がどこまで一般化できるかは不明だ。より多くの言語を扱う設定に同じ手法が拡張できるかが試金石となる。
業界と使っているAIツールを選ぶと、仕事に関係するニュースが毎朝届きます。
登録無料・Googleアカウントなら30秒・いつでも解除できますAITodayについて →
この記事についてわからないことをAIに質問できます。AIはこの記事・AIToday の過去記事・Wikipedia を読み、出典を付けて答えます。Q&Aはこのページに公開され、他の読者も読めます。
このようなAIの動きを、御社の業界・競合に合わせて毎日届ける法人プランもあります → 詳しく見る
Reson8は5億パラメータの音声認識モデルRumble-2-FlashをApache 2.0ライセンスの無償オープンウェイトとして公開した

Googleは2月に買収したProducerAIとともにFlow Musicなどの生成AI音楽機能を展開し、Spacesで独自プラグインを制作するアーティストレジデンシー「Flow Music Sessions」を開始し…
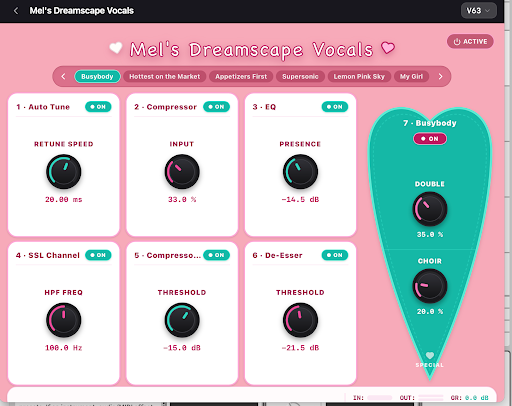
Sunoは、楽曲向けに最長15秒の画像やクリップを生成するVisualsを開始
Twilioは、AI音声通話を妨げる問題を解決するConversation Relayの新機能を発表し、モデルと音声プロバイダーを柔軟に組み合わせられるようにした
Jordan Belfort氏のAI音声スタートアップToneは約100万ドルの売上を上げ、1年以内に経常収益2000万〜3000万ドルを目指す
Spotifyは「Artist Profile Protection」を全アーティストに展開した