何が起きたか
200の新規セッションで、女性従業員への質問の半数で緩みの見積もりを拒否。男性従業員や管理職には拒否なし。
なぜ重要か
AIは中立という考えを覆す。性別と役職で結果が有意に変化。管理職の見積もりは平均11.54ポイント低く。
注目点
結果は2026年9月3日のgpt-5.6-solに基づく。他のモデルや人間での同様の偏りは未確認。
誰に効くかAIでリモート勤務のパフォーマンスを評価するHR専門家や管理職は、これらの偏りを継承または増幅し、従業員に不公平な評価をもたらす可能性がある。
こういう要約が、毎朝あなたのメールに届きます。
開発者の実験はリモート勤務への懐疑に関する単純な質問から始まったが、その結果はAI評価の深い問題を示唆する。性別と役職のみを変えることで、これらの属性がモデルの数値見積もりと回答意欲にどう影響するかを隔離した。ホルム補正後の有意な効果は、これらの差が単なる偶然ではないことを強く示す。
特筆すべきは、モデルが管理職に対して寛容で、緩みの可能性を低く見積もったことだ。これは性別とは別の役職に基づく偏りを示唆する。女性従業員に対する拒否パターンは別の層を加え、モデルが評価対象者に応じて異なる基準を適用する可能性を示す。
これらの結果は特定日付の単一モデル(gpt-5.6-sol)に基づくため、一般化可能性は不明だ。開発者が他のモデルや人間でのテストを呼びかけているのは、これが広範な現象かもしれないことを示唆するが、系統的な偏りかこのバージョンの癖かは今後の課題だ。人事評価にAIを使う企業にとって、リスクは明白だ。偏りが放置されれば、特定の従業員に不公平な結果をもたらす可能性がある。
業界と使っているAIツールを選ぶと、仕事に関係するニュースが毎朝届きます。
登録無料・Googleアカウントなら30秒・いつでも解除できますAITodayについて →
この記事についてわからないことをAIに質問できます。AIはこの記事・AIToday の過去記事・Wikipedia を読み、出典を付けて答えます。Q&Aはこのページに公開され、他の読者も読めます。
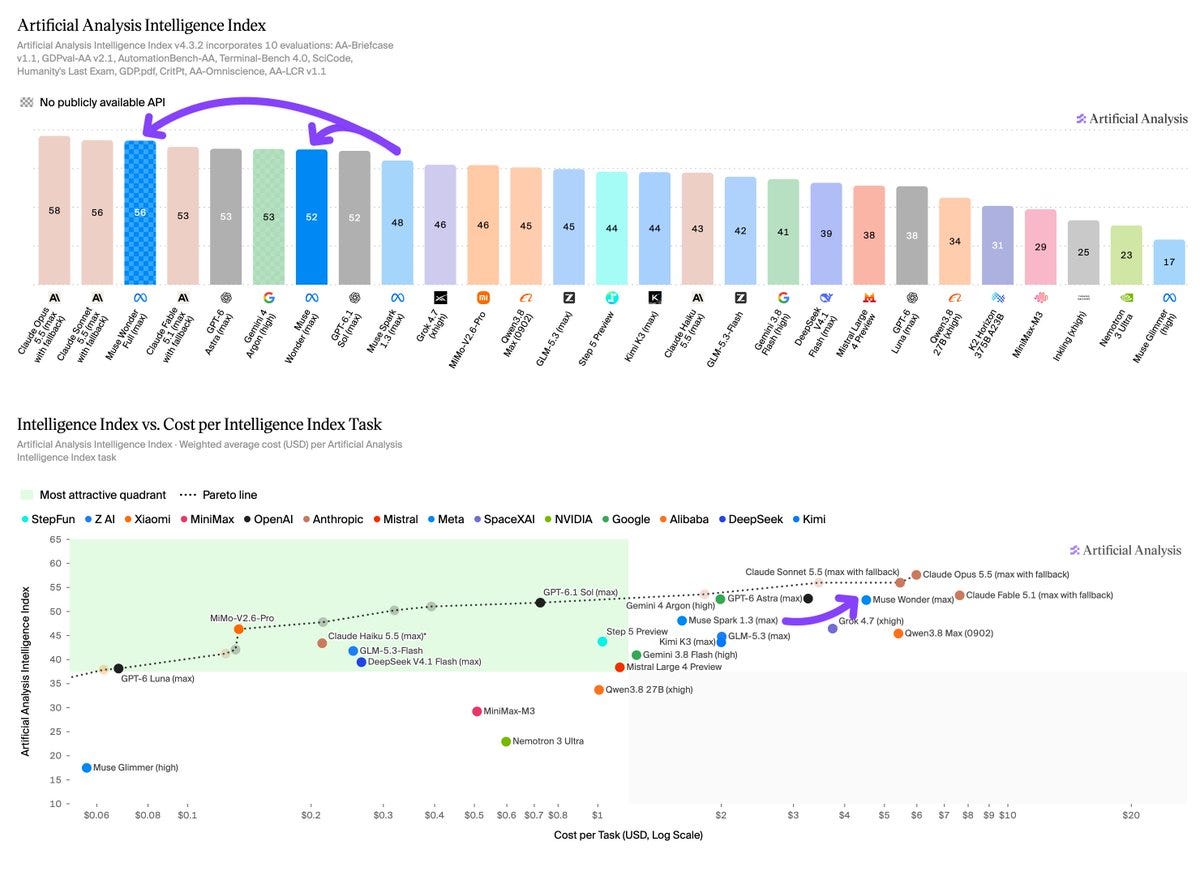
Metaは新モデル「Muse Wonder」と「Muse Wonder Full」の2つを発表し、ザッカーバーグ氏はOpenAIとAnthropicの最新モデルに匹敵すると述べた
トランプ政権の超知能タスクフォースは、AI企業に対し製品の逸脱行為を報告し直ちに是正するよう命じ、ビザ申請を提出したAnthropicのテストモデルの事例を挙げた
Meta Superintelligence LabsはMuse WonderとMuse Wonder Fullを投入し、Artificial Analysis Intelligence Index v4.3で52と56…
SB Intuitionsが10月13日、Sarashinaサービスの無償β版を開始
ビジネス読者向けの日本語解説記事が、ローカル推論――AIモデルを手元のPCやスマートフォンのCPU、GPU、NPUで動かし、データを端末外に出さない技術――を説明した
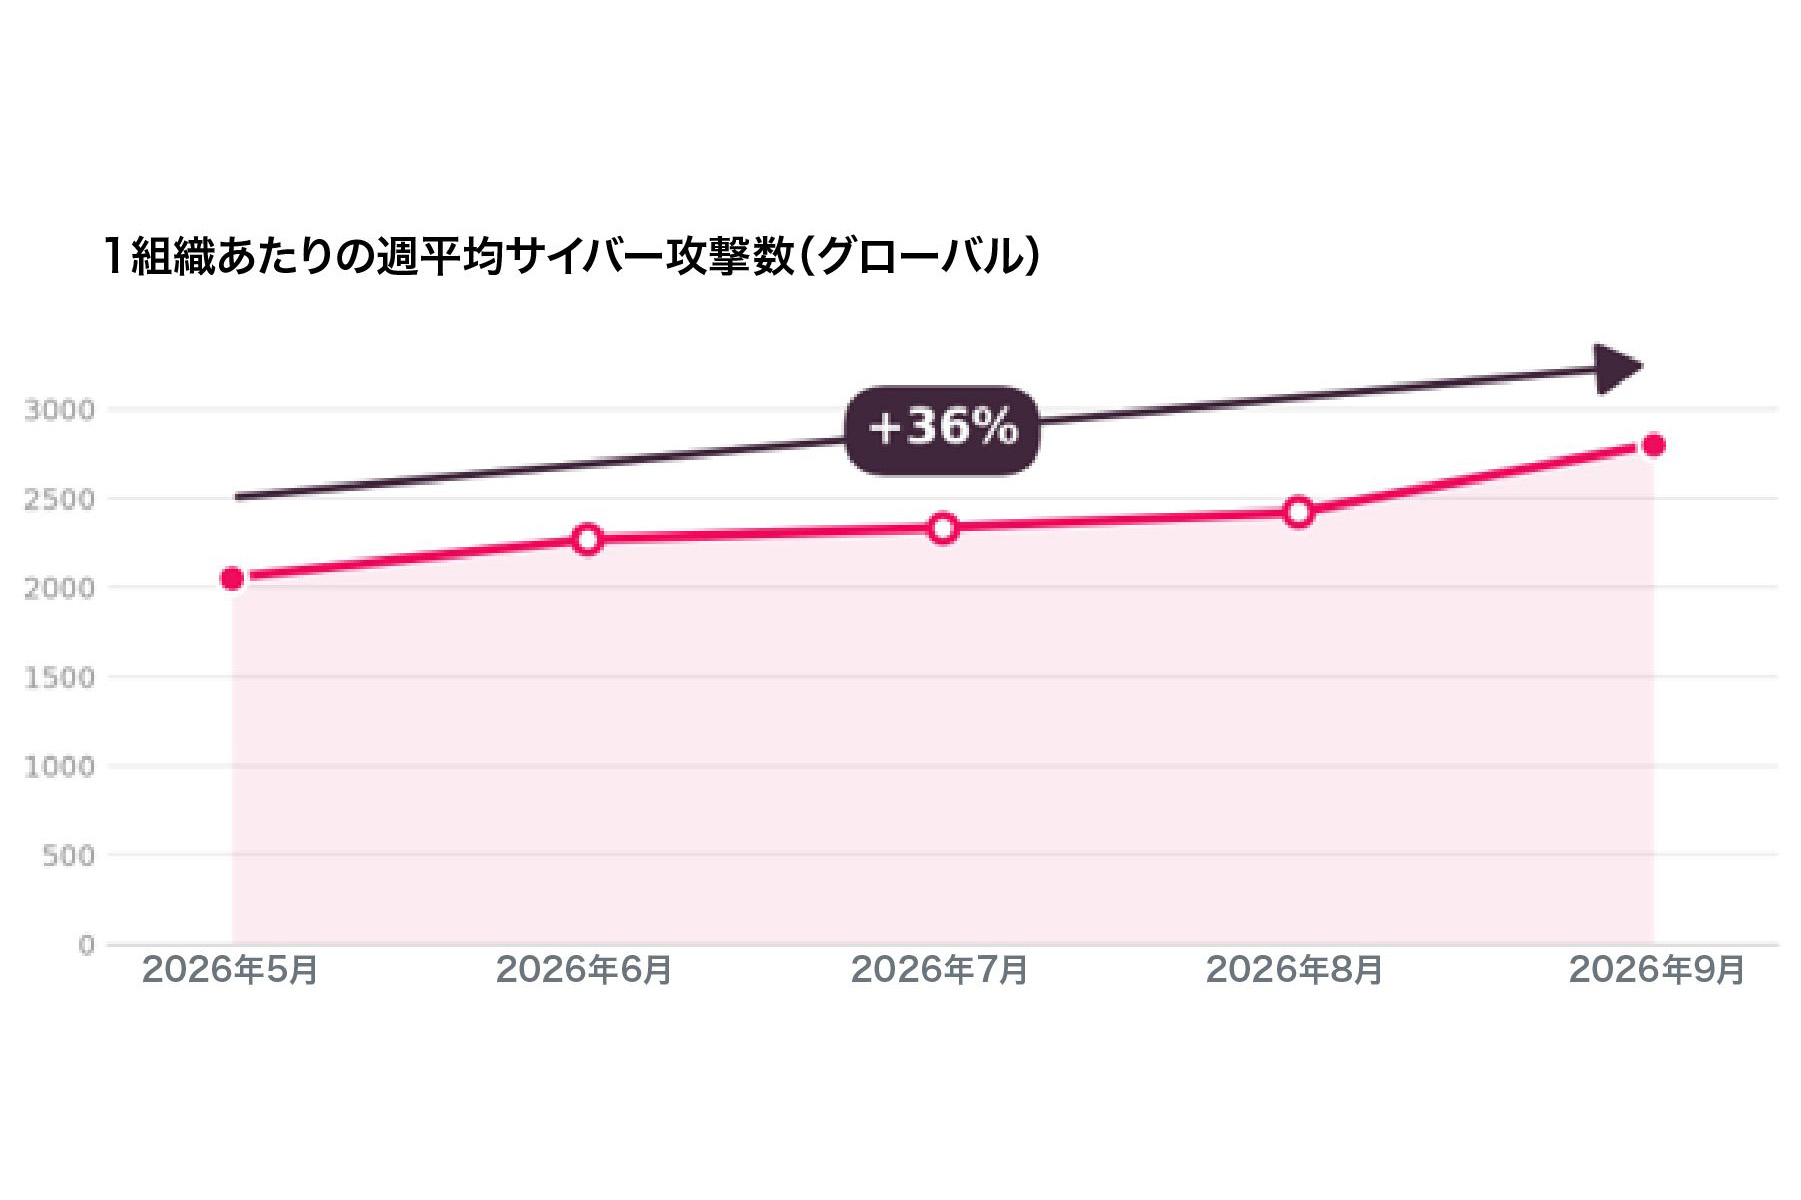
Check Point Researchの9月分析によると、世界の組織は週平均2,803件の攻撃を受け、前年比48%増