何が起きたか
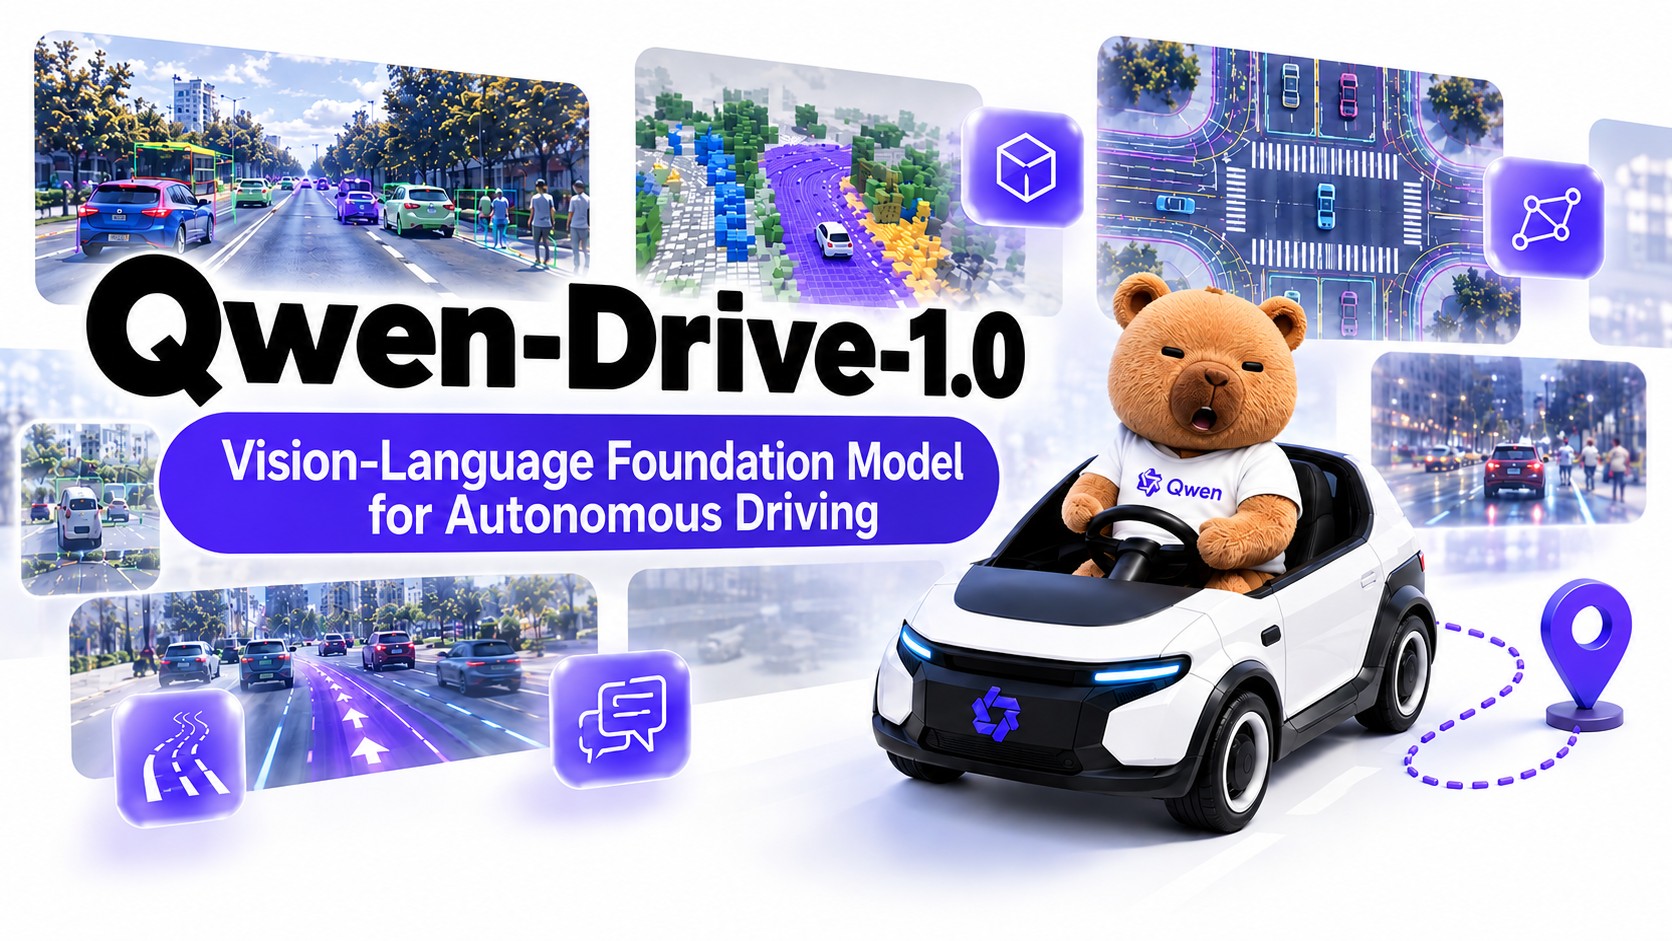
アリババの研究部門がQwen-Drive 1.0を公開。環境認識、交通Q&A、経路計画を1モデルに統合し、Qwen3.5-4Bを基盤とする。
なぜ重要か
研究チームは、汎用のテキスト画像モデルが3D空間を自動では理解しないことを実証。空間タスクで訓練した結果、シミュレーションでの道路逸脱が24%から12%に減少した。
注目点
モデルの説明と操作が必ずしも一致しないため、実用化には多様なカメラ構成や稀な事象に対応できる訓練データが鍵となる。
誰に効くか統合型コックピット・運転システムを開発する自動運転研究者やエンジニアは、空間推論を追加しながら汎用知識を保持するモデルの恩恵を受け、個別モデルの必要性が低減する可能性がある。
こういう要約が、毎朝あなたのメールに届きます。
Qwen-Drive 1.0の公開は、テキスト画像モデルが画像をうまく記述できても明示的な空間推論を欠くという既知の課題に取り組む一歩である。研究者らは、俯瞰ビューモジュールとプランニング専門家を統合し、汎用知識を保ちながら運転タスク全体を処理できるモデルの構築を目指した。知覚、Q&A、計画を組み合わせた訓練手法は、PaLM-Eなどの初期モデルに影響した壊滅的忘却の回避を意図している。
論文は、説明と操作が必ずしも一致しない点や、未知のカメラ構成での性能低下など、モデルの限界を正直に評価しており、シミュレーションと実用化のギャップを浮き彫りにしている。また、一部の結果が独自設計のテストに依存していることも認め、独立した検証の必要性を示唆する。
自動運転開発への影響は大きい。統合モデルが汎用知識を犠牲にせず空間理解を真に習得できれば、車載コンピューティングを簡素化し、コックピット機能と運転機能を1つのシステムで実行できる可能性がある。しかし、実際の効果は、研究コミュニティがデータ不足や説明の不一致を解決できるかにかかっている。
業界と使っているAIツールを選ぶと、仕事に関係するニュースが毎朝届きます。
登録無料・Googleアカウントなら30秒・いつでも解除できますAITodayについて →
この記事についてわからないことをAIに質問できます。AIはこの記事・AIToday の過去記事・Wikipedia を読み、出典を付けて答えます。Q&Aはこのページに公開され、他の読者も読めます。
NTTデータとNTTデータ東海が10月26日、あいち銀行と共同で実証を開始
OpenAIのGPT-5.6 Solが「php2shell」と呼ばれるPHPの重大脆弱性CVE-2026-109618とCVE-2026-109619を発見し、PHP Foundationは10月21日午後11時に緊急パ…
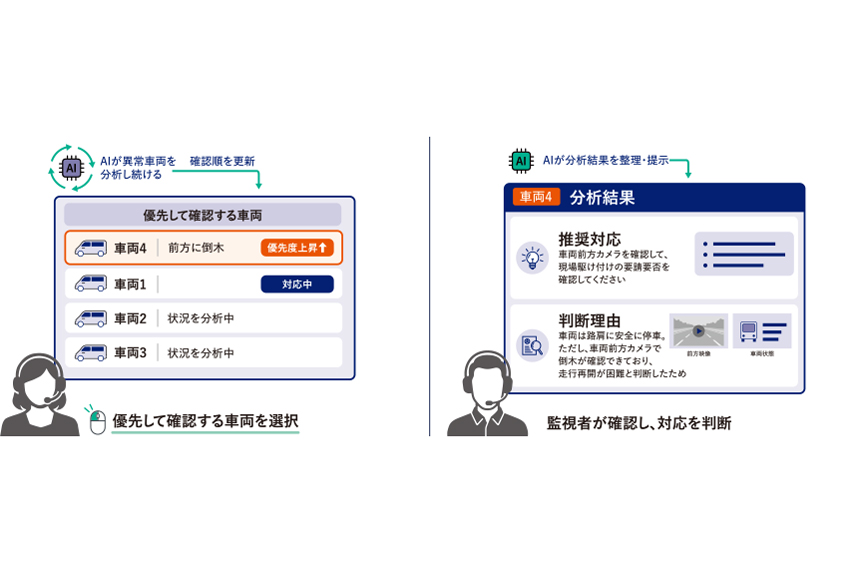
KDDIがレベル4自動運転の1対N遠隔監視向けAIエージェントを開発
インプレスは10月22日、Gemini Notebook(旧NotebookLM)の実践的な「推し技」100個を紹介する書籍を発売する
KDDI、沖縄セルラー、KDDI Digital Lifeは10月22日、povo AIにChatGPT 5.5、ChatGPT 5.5 Pro、ChatGPT 5.5 Thinkingを追加した
GoogleとOpenAIはGPT-6 Astra、GPT-6.1 Sol、GPT-6 LunaをModel Garden経由で提供し、一部顧客向けプレビューを開始した