何が起きたか
Princeton UniversityとUC San Diegoなど複数の機関の研究者が、8,135件の統制実験を実施し、スキル(特定のタスク向けの簡潔な指示セット)を持つAIエージェントと持たないものを比較した。スキルは主に信頼できるプロセスを提供することで成功を助け、不足している事実を補うのではないことがわかった。手続的な基盤が性能向上の65.7パーセントを占めた一方、知識を直接提供したのはわずか4.5パーセント。
なぜ重要か
スキルはAIエージェントを再学習せずに能力を高める実用的な方法であり、この研究はその仕組みを解明している。だが同時に重大な制限も浮き彫りになった。エージェントがスキルを機械的に、または不適切にタスクに適用するケースが10パーセント発生する。さらにスキルライブラリが5から100に増えると、正しいスキルを取得する能力は急落し、29.6パーセントの精度から3.3パーセントに低下する。AIエージェントの性能向上を目指す国内企業において、スキルライブラリの拡大に伴い正しいスキル選択が困難になる可能性がある。
注目点
研究者らは、AIエージェントを改善する際には単に経験を蓄積するのではなく、スキルをより確実に作成・取得・適用する方法に注力すべきだと主張している。これはスキル選択の問題を解決することが次の課題であり、特にライブラリが拡大する中での重要性を示唆している。
こういう要約が、毎朝あなたのメールに届きます。
この研究は、スキルがAIエージェントの性能を向上させる理由についての既存の理解の空白を埋めるもの。これまで研究者は、スキルを持つエージェントが成功する頻度をはかっただけで、その仕組みは不明なままだった。8,135件の実行にわたる統制実験を実施することで、チームはスキルが実際に寄与するもの、つまり新しい事実や知識ではなく信頼できる手続的枠組みを分離した。この区別は重要である。なぜならスキルの効果的な設計と導入方法を再構成するから。
この研究はまた、スキルベースのシステムがシームレスにスケールしない理由を明らかにする。ライブラリが拡大するにつれ、問題は能力から取得へシフトする。エージェントは多くのオプション中から適用するスキルを識別するのに苦労する。精度の急落(ライブラリが10倍に拡大する際に29.6パーセントから3.3パーセント)は、単純なスキル取得ではスケール時の性能向上を維持しないことを示唆している。さらに、エージェントがスキルを機械的に、または不適切に適用する10パーセントのエラー率は、スキルをタスクにマッチさせることそのものが非自明な問題であること、特にタスクが保存されたプレイブックと根本的に異なるアプローチを必要とする場合に、そうであることを示している。
業界と使っているAIツールを選ぶと、仕事に関係するニュースが毎朝届きます。
登録無料・Googleアカウントなら30秒・いつでも解除できますAITodayについて →
この記事についてわからないことをAIに質問できます。AIはこの記事・AIToday の過去記事・Wikipedia を読み、出典を付けて答えます。Q&Aはこのページに公開され、他の読者も読めます。
NVIDIAは2026年9月21日、「AIセキュリティは工学の問題――エージェントスタックの全層で解決する方法」と題したブログ記事を公開し、判断を誤ったエージェントでも行動を止められる理由を説明した

検証では、Haiku 5.5はmedium設定で定型文書ならSonnet 5.5に近いスコアを約1/17のコストで出したが、英語メール課題では6.3点まで落ちた

Metaは8160億パラメーターのオープンウェイトモデルMuse Spark Openを公開
PrismMLは2026年10月15日、Ternary Bonsai 2の2B・4B・9Bを公開した
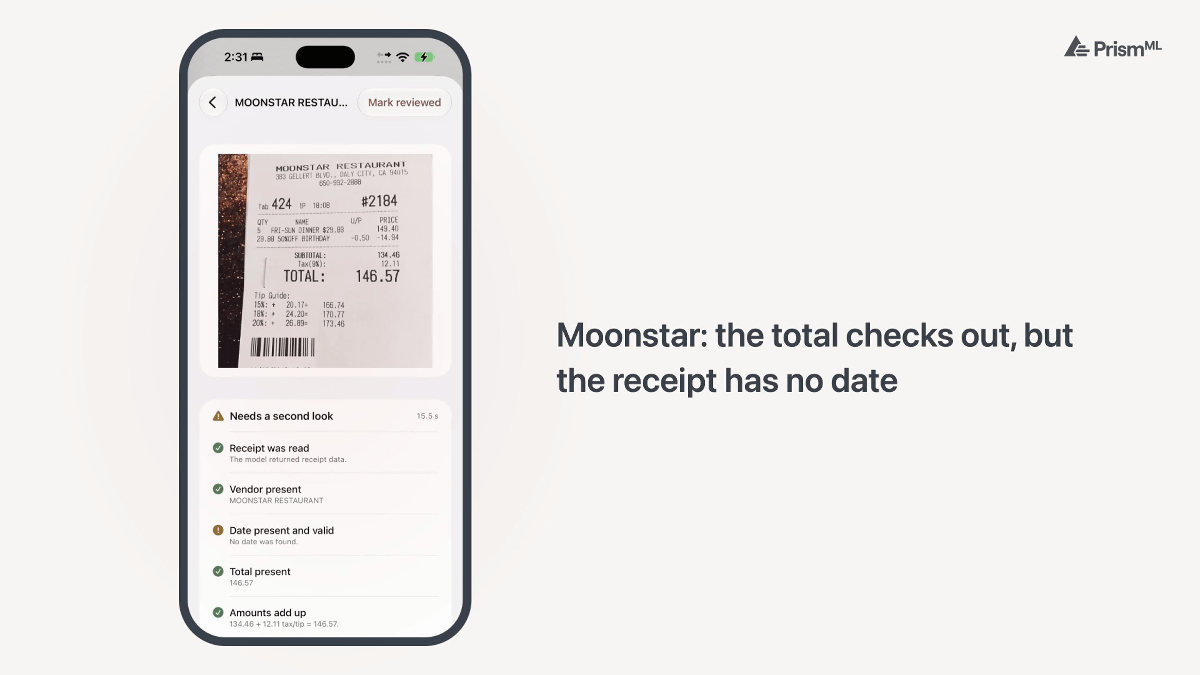
EC自動化工房がZenn記事で商品マスタ生成前クレンジング手順を示した

Claude Codeへの一言の依頼3回と完了条件付きの依頼3回では機能的に同一のMyntPackコードが生成されたが、後者では各回テストが3〜5本追加され、3回とも最後にlintを1回実行した

