何が起きたか
AWSがvLLMにKVキャッシュの双方向転送を貢献し、デコードノードがキャッシュ済みコンテキストをプリフィルノードへ返せるようにした。
なぜ重要か
会話履歴を再送し続けるマルチターンのエージェントは、過去トークンの再計算を避けられる。プロンプトが長くなっても遅延の増加が抑えられ、繰り返しのプリフィル処理に割くアクセラレータ容量も減る。
誰に効くか恩恵を最も受けるのは、分離型プリフィル・デコードクラスタ上で会話アシスタントやエージェント用途のセルフホストvLLMを運用するチームだ。対話履歴が伸びても応答遅延を低く抑えられる。
こういう要約が、毎朝あなたのメールに届きます。
この機能は、プリフィルとデコードを分離したサービングにおける構造的な非効率を解消する。従来の一方向フローでは、デコードノードがプロンプトと新規生成トークンの両方のKVキャッシュエントリを保持するが、プリフィルノードは次のターンにそれらを取得できない。そのためプリフィルノードは過去の応答トークンについてKV射影を再計算せざるを得ず、プリフィルノード上のアクティブセッションでキャッシュが追い出される可能性も高まる。完全なキャッシュミスが起きると、プリフィルノードはシステム指示、過去のユーザー要求、ツール結果、モデル生成応答を含む会話履歴全体を再計算しなければならない。AWSはもともとEFAで接続したTrainiumインスタンスクラスタ上で双方向KV転送を構築・検証し、アクセラレータ非依存の機能としてvLLMに貢献した。EFA接続のAmazon EC2 P5en GPUクラスタでのベンチマーク結果は、その利点がGPUにも引き継がれることを示していると投稿は述べている。
再利用が実際に効くかどうかは2つの制御が決める。decoder_kv_blocks_ttl設定は会話のKVブロックを一定期間利用可能に保ち、kv_recompute_threshold設定(デフォルト64トークン)はプリフィルがリモートKVを取得するかローカルで再計算するかを決める。投稿は、再利用可能なプレフィックスが短い場合、 interconnectと調整のオーバーヘッドがトークン再計算に必要な時間を上回り得ると指摘する。また、ハートビートで更新されるリースをデコード側にも拡張することを自然な次の改善として挙げており、それにより固定タイマーの終了時ではなく会話がアイドルになった時点でブロックを回収できるようになる。
ベンチマークでは、キャッシュ追い出しや、会話のKVブロックを持たない別のプリフィルノードをルーターが選ぶ状況を模すため、プリフィルノードのプレフィックスキャッシュを意図的に無効化した。その条件下で機能をオフにすると、コンテキストの増加とともにTTFTが急上昇した。Qwen3-32Bは2kで158 msから24kで778 msへ、GLM-5-FP8は2kで500 msから20kで2,334 msへ上昇した。機能をオンにすると、Qwen3-32Bは122 msから460 msへ、GLM-5-FP8は358 msから702 msへしか上昇しなかった。GLM-5-FP8で差が大きいのはトークンあたりの再計算時間が長いためで、モデルとコンテキストが大規模化するほどKV再利用の効果が大きくなると投稿は説明している。
業界と使っているAIツールを選ぶと、仕事に関係するニュースが毎朝届きます。
登録無料・Googleアカウントなら30秒・いつでも解除できますAITodayについて →
この記事についてわからないことをAIに質問できます。AIはこの記事・AIToday の過去記事・Wikipedia を読み、出典を付けて答えます。Q&Aはこのページに公開され、他の読者も読めます。
MiniMaxはM3.1 Flashを公開した
Anthropicが自社の従業員を対象に調査したところ、Claudeのセッション経過時間の80%はエージェントが人間の入力待ちで、8月時点でエージェント稼働時間は人間の6倍だった
GitHubが「Open in VS Code」でCopilotアプリのセッションをVS Codeで開く手順を公開
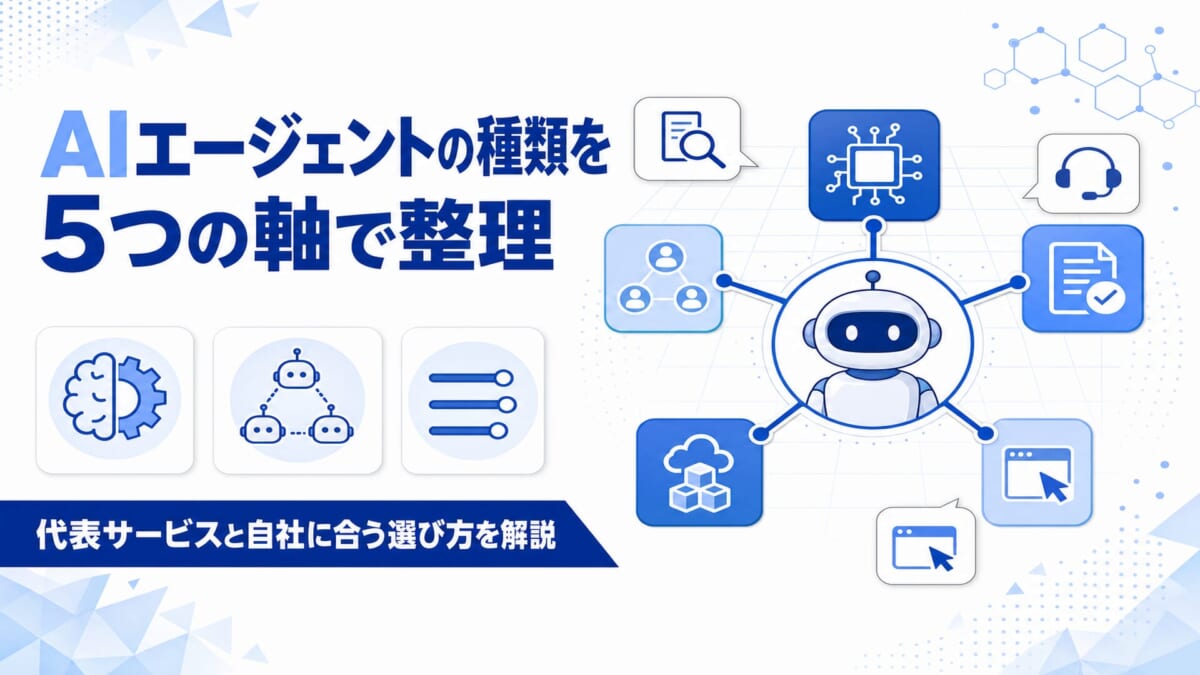
IBMの5分類(単純反射型、モデルベース反射型、目標ベース型、効用ベース型、学習型)を仕組み別に示し、AgentforceやCopilot Studio、Difyなどの実サービスを各分類に対応付けた
AINOWが2026年10月時点のAIエージェント17選の比較を公開し、料金、無料トライアルの有無、学習データ利用と認証の状況を各項目で取り上げた
OpenAIのDotsやMetaのMuseといったパーソナルAIエージェントが大規模にウェブサイトを訪問している