何が起きたか
生の履歴への密検索「Raw-RAG」がLoCoMo、LongMemEval、MEME、MemoryAgentBenchの7つのベンチマーク・モデル設定中6つで1位となり、エージェント型記憶システムを0.13~5.53ポイント上回った。
なぜ重要か
これが保てば、会話エージェントを構築するチームは精巧な記憶アーキテクチャより生履歴への単純な検索から良い回答を得られる可能性があり、これらのタスクでは追加の工学投資が報われないかもしれない。
誰に効くか最も直接的な対象は会話エージェントを構築するエンジニアリングチームと、精巧な記憶アーキテクチャへの投資額を決める管理者だ。この結果は、これらのタスクでは単純な検索が複雑なシステムに匹敵するか上回り得ることを示唆している。
こういう要約が、毎朝あなたのメールに届きます。
この論文が狙うのは、会話エージェント設計で一般的になったパターンだ。モデルの上に専用の記憶モジュール、書き込み操作、検索ポリシーを重ねる。著者らはその前提を直接検証するため、あえて単純なベースライン——生の会話履歴に対する密検索、名付けてRaw-RAG——を4つのベンチマークでより精巧なエージェント型記憶システムと比較した。
結果として、単純なベースラインが7つのベンチマーク・モデル設定中6つで0.13~5.53ポイントの差をつけて先行した。速度比較も同じ方向を指す。Raw-RAGはAdd-plus-Searchを次善システムより5.1倍、EverMemOSより30.4倍速く完了した。著者らの結論は、評価対象の会話記憶タスクに記憶システムの複雑さは不要というものだ。
ただし結果には留保もある。論文の範囲は評価対象のタスクに限られ、他の記憶ワークロードに当てはまるかは本稿では確立されていない。それでも差と速度差から、エージェント開発者は自らの環境で照合したくなる結果だろう。
業界と使っているAIツールを選ぶと、仕事に関係するニュースが毎朝届きます。
登録無料・Googleアカウントなら30秒・いつでも解除できますAITodayについて →
この記事についてわからないことをAIに質問できます。AIはこの記事・AIToday の過去記事・Wikipedia を読み、出典を付けて答えます。Q&Aはこのページに公開され、他の読者も読めます。
このようなAIの動きを、御社の業界・競合に合わせて毎朝届ける法人プランもあります → 詳しく見る
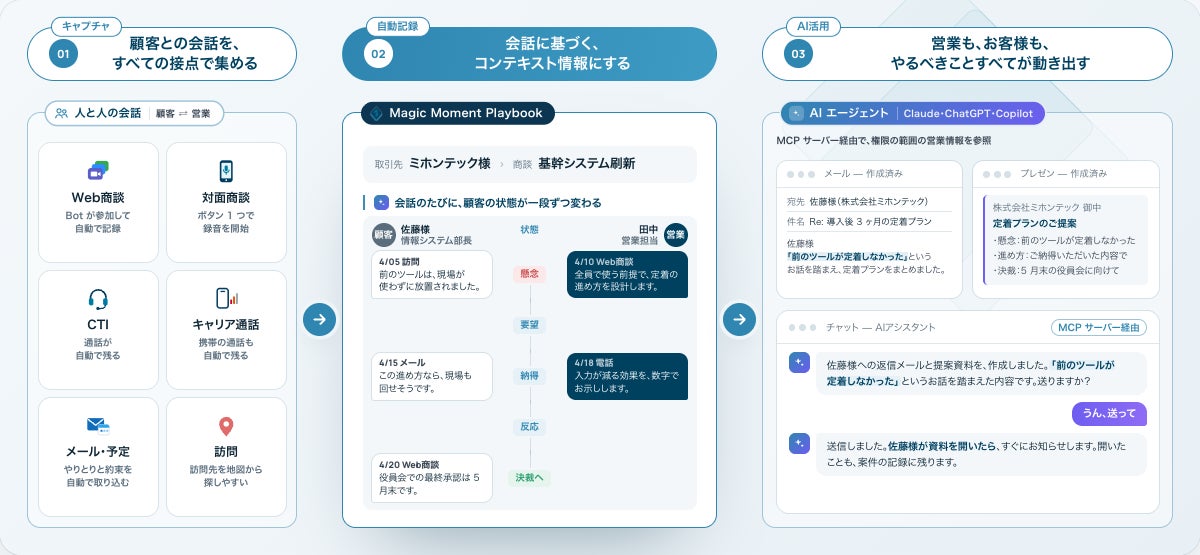
Magic Momentが「Magic Moment Playbook」向けMCPサーバー提供を開始し、ClaudeやChatGPT、Microsoft CopilotなどMCP対応アシスタントから営業記録を参照可能にし…
10月28日にラスベガスで開催されるOracle AI Worldを前に、OracleのJuan Loaiza氏はガードレールだけでは不十分だと述べた
Sam Altman氏が共同創業したWorldは今週、人間であることの証明をAIエージェントに紐付けられるツールを発表したと製品責任者のTiago Sada氏がSemaforに語った
単距離問題の証明への論評で、OpenAIに最近採用されたJacob Tsimerman氏は、AIの強みは数学者よりも過酷な水域で長くプレーし、圧倒されない点にあると述べた
METRとRedwood ResearchがOpenAIに3週間オンサイトで入り、GPT-5.5クラス以上のモデルによるResponses APIトラフィックの推定6〜25%が監視対象外だったと判明
Anthropicは、未公開の研究モデルが能力とアラインメントでMythos 5.1を上回り、進行中の攻撃を自ら停止できた割合は67%で、Opus 5.5の10%を大きく上回ると発表した