何が起きたか
LEGO-Anythingはコーディングエージェントが1枚の写真から実行可能なBlenderコードを書き、LEGO-BenchでGPT-6 Astraは屋内53.4%、屋外39.6%だった。
なぜ重要か
最強モデルでも忠実な再構成には届かず、研究チームは改良はエージェントの判断ではなく具体的な計測に頼るべきだと結論づけた。
注目点
動作するシーンと忠実なシーンの差は、エージェントが自らの進歩を打ち消すのをやめられるかにかかる。研究では改善を覆す修正や信頼できない自己評価が見つかった。解消の見通しは記事にない。
誰に効くか3DコンテンツにAIコーディングエージェントを使うチーム、つまり編集可能なBlenderシーンを必要とするゲームや建築可視化のパイプラインにとって、使えるが形状忠実度は限られることを示す初のベンチマークとなる。
こういう要約が、毎朝あなたのメールに届きます。
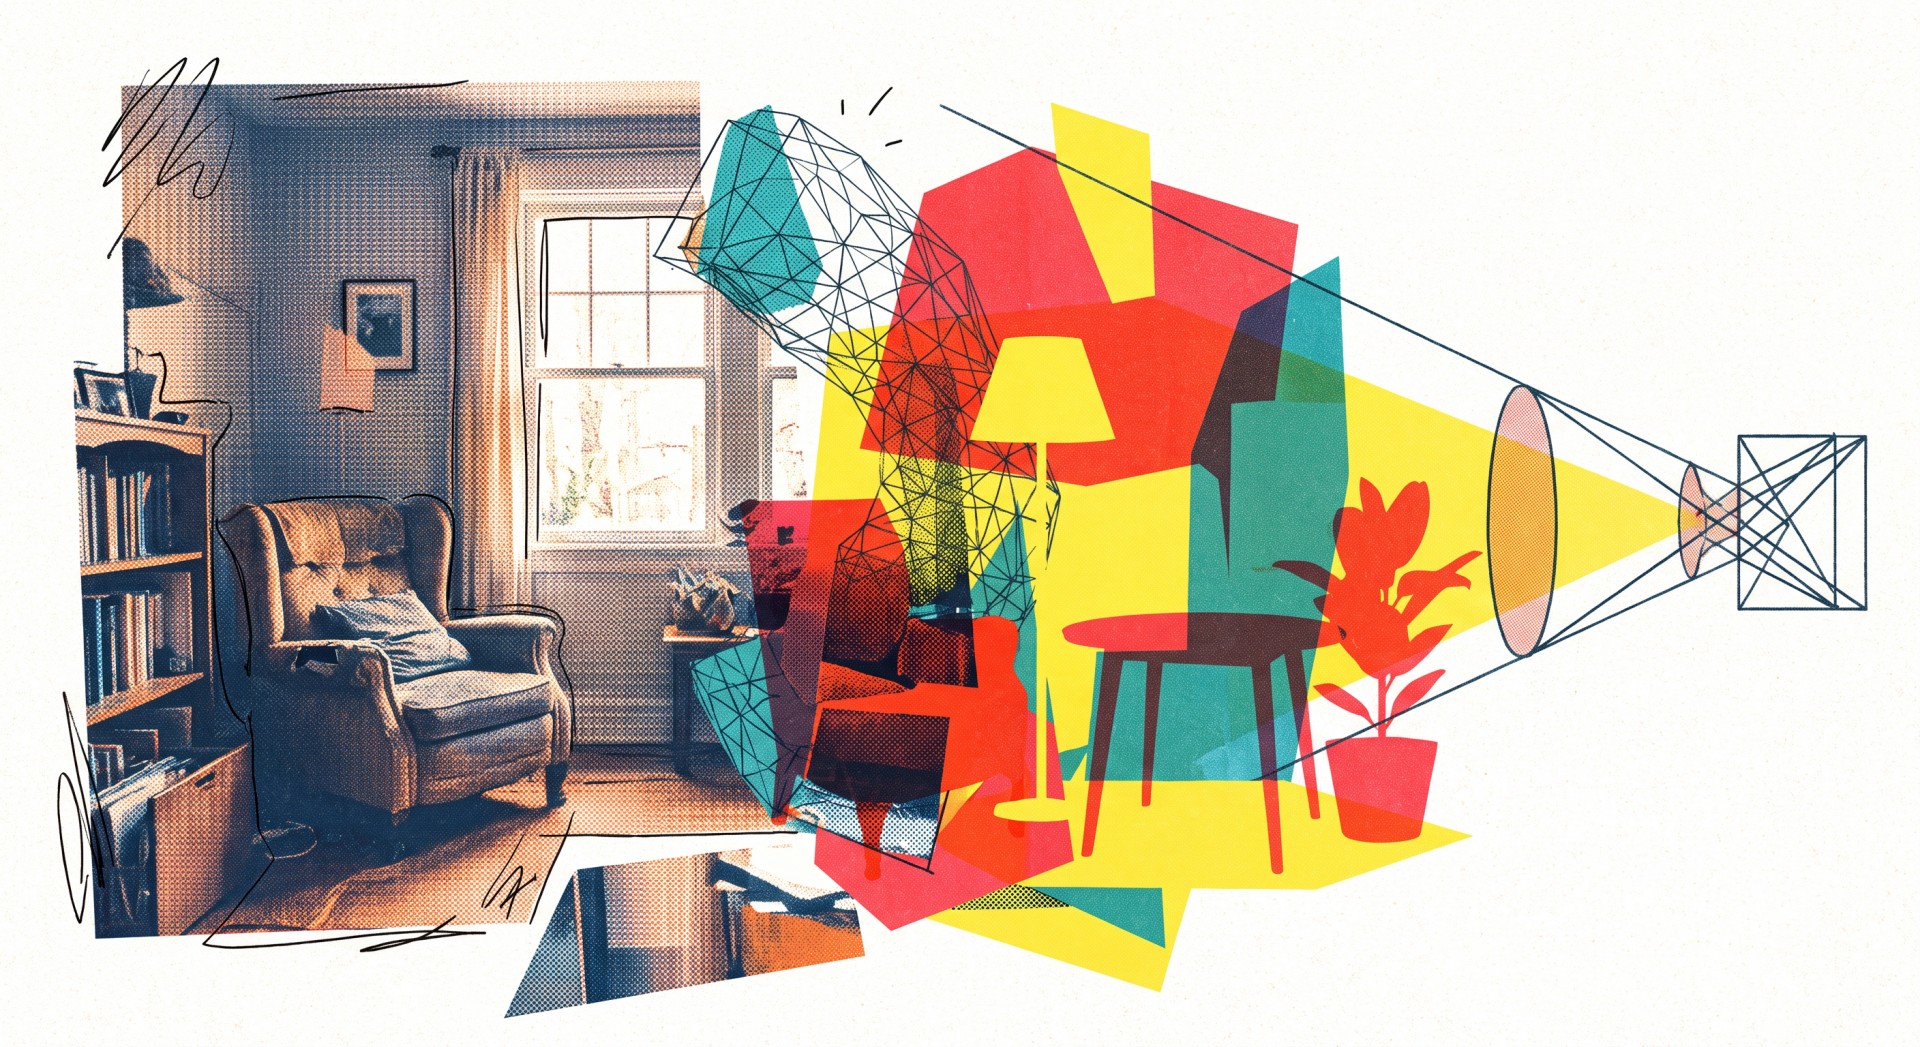
この研究の核は単純な転換にある。3Dシーンを直接生成する代わりに、LEGO-AnythingはコーディングエージェントにBlenderプログラムを作らせる。出力がコードなので、物体、形状、配置、カメラ位置が明示的に捉えられ、シーンは実行・検証・修正できる。実効性を測るため、研究者らはプロ制作のシミュレーターシーンからLEGO-Benchを構築した。入力は自然な見た目を保ちつつ、正確な形状・深度・物体割り当てが自動採点の解答鍵となる。
ベンチマークは鮮明な分裂を露呈した。テストした6つのGPT構成はすべてほぼ毎回動作するシーンを出したが、精度は大きくばらついた。最高のGPT-6 Astraは屋内53.4%、屋外39.6%で、弱い構成は約15%だった。複雑さが増すと精度は下がり、屋外は屋内より難しかった。推論予算を増やすとGPT-6系は大きく改善し、Astraはオフィスのテスト部分集合で32.3%から61.8%に跳ね上がった。
原因を掘り下げると、初期試行の不出来、以前の進歩を打ち消す修正、信頼できない自己評価が最も多い問題として見つかった。最後の点が最も雄弁だ。2つの版のどちらが元に近いか選ばせると、判断は自分のシーンでも偶然以下か同程度に落ちた。対策として作ったプラグインは6モデル全てを改善し、弱いエージェントは最大62.7%伸びたが、最高モデルの伸びは約2ポイントにとどまった。未解決の問いは、これらのシーンが標準的な視覚タスクの基盤になり得るかだ。著者らは使えるが目立たない結果を報告し、動作する結果と忠実な再構成の間には大きな隔たりが残る。
業界と使っているAIツールを選ぶと、仕事に関係するニュースが毎朝届きます。
登録無料・Googleアカウントなら30秒・いつでも解除できますAITodayについて →
この記事についてわからないことをAIに質問できます。AIはこの記事・AIToday の過去記事・Wikipedia を読み、出典を付けて答えます。Q&Aはこのページに公開され、他の読者も読めます。
2026年のPew報告書で米国人の10%が感情面の支えや親しみを求めてチャットボットを利用していることが判明
PC上のPyTorch CNN(NVIDIA PilotNetの縮小版)がカメラ画像を前・左・右・停止の命令に変換し、BluetoothでArduino UNOに送る手のひらサイズの車を著者が製作

Splice CEOのKakul Srivastava氏は「AIが書いた文書には注意している」と述べた
OpenAIの主要モデルリリースごとに安全性報告書を執筆してきたDavid Robinson氏が今週辞任し、The Atlanticの論説で業界の文化は「壊れている」と述べた
Instinctは2026年9月に評価額100億ドルで10億ドルを調達し、Fambot、Folk、Martin、Ollie、Poke、Townなどが参入、iMessage、SMS、WhatsApp経由で動作
NVIDIAは2027会計年度第2四半期のデータセンター売上高として890.2億ドルを計上したと2026年8月26日に発表した