何が起きたか
同じ保存記事14件を要約させると、Haiku 5.5は13件中4件で核心的主張を落とし、2回連続で同じ結果に。Opus 5.5は13/13と12/13で、捏造された数値や引用はどの条件でも0件だった。
なぜ重要か
ファクトチェックは要約に書かれたことしか確認できず、核心的主張が欠けてもシグナルは残らない。Opus 5.5でも核心的主張を1件落としており、静かな欠落は安価なモデルだけの問題ではない可能性を示す。
こういう要約が、毎朝あなたのメールに届きます。
このテストは検索パイプラインではなくモデル自体を切り分けるよう設計された。14本のウェブ記事を10/9に取得・保存し、同一ファイルを全条件に投入したため、CAPTCHAやタイムアウトが各モデルの読む内容を変えることで差が生じることはなかった。
要約の失敗は2種類に区別される。事実誤りは書かれた内容を原文と照合すれば捕まえられる。核心的主張の欠落はその方法では捕まらない。要約に何も現れず、チェッカーが比較する対象がないからだ。素のプロンプトでのHaikuの要約は、比較表の最上段で事実チェックを満点で通過しながら、13件中4件で中心的論点を落としていた。失敗は網の外側にある。
検索の限界は別の挙動を示した。プロンプトの手順は両方のギャップを同時に埋め、Haikuの核心的主張スコアを13/13に、両モデルの検索限界スコアを9〜10/10に押し上げた。一例がGPT-6発表で、素のHaiku要約は製品詳細をすべて正しく列挙しながら、ソフトウェアが人に適応するという締めの一文に触れなかった。手順を加えた版はその一文を冒頭に置き、取得テキスト内のインタラクティブUI例がGPT-5.6 Instantと表示されている点を指摘した。
業界と使っているAIツールを選ぶと、仕事に関係するニュースが毎朝届きます。
登録無料・Googleアカウントなら30秒・いつでも解除できますAITodayについて →
この記事についてわからないことをAIに質問できます。AIはこの記事・AIToday の過去記事・Wikipedia を読み、出典を付けて答えます。Q&Aはこのページに公開され、他の読者も読めます。
世田谷区がAIエージェントツールGensparkを試験導入し、約2900時間の業務を削減したとDX推進担当のSho Miyama氏が述べた
LegalOn Technologiesは10月19日、案件受付後の法律相談や案件割り当てなど一連の定型業務を自動化する「Agent Builder」のβ版提供を開始した
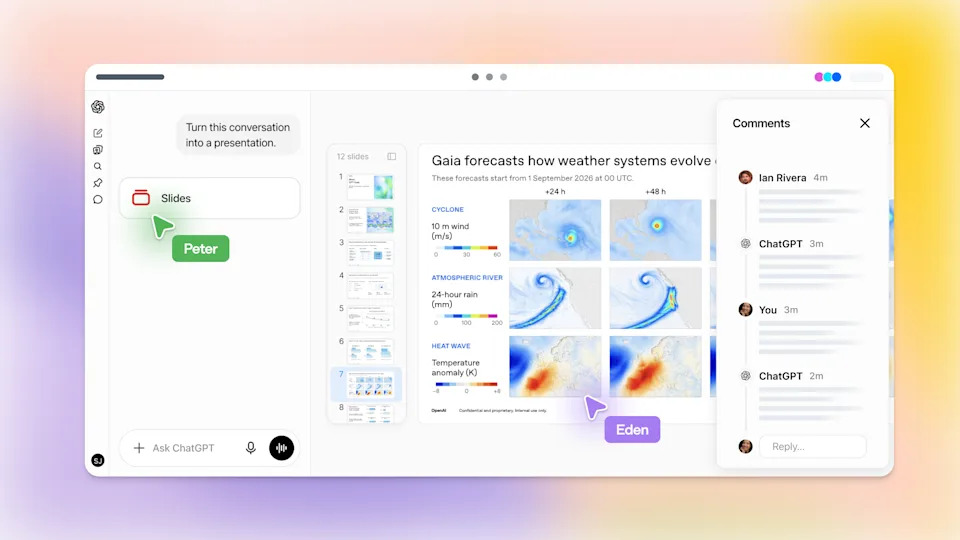
OpenAIがChatGPT上でスライドを作成できるChatGPT Slidesを開始
DeepSeekは2026年10月17日、Search APIとFetch APIを公開した
DeepSeekは2026年10月17日、無料のMITライセンスのオープンモデルDeepSeek-V4.1-Flash-1017を公開した
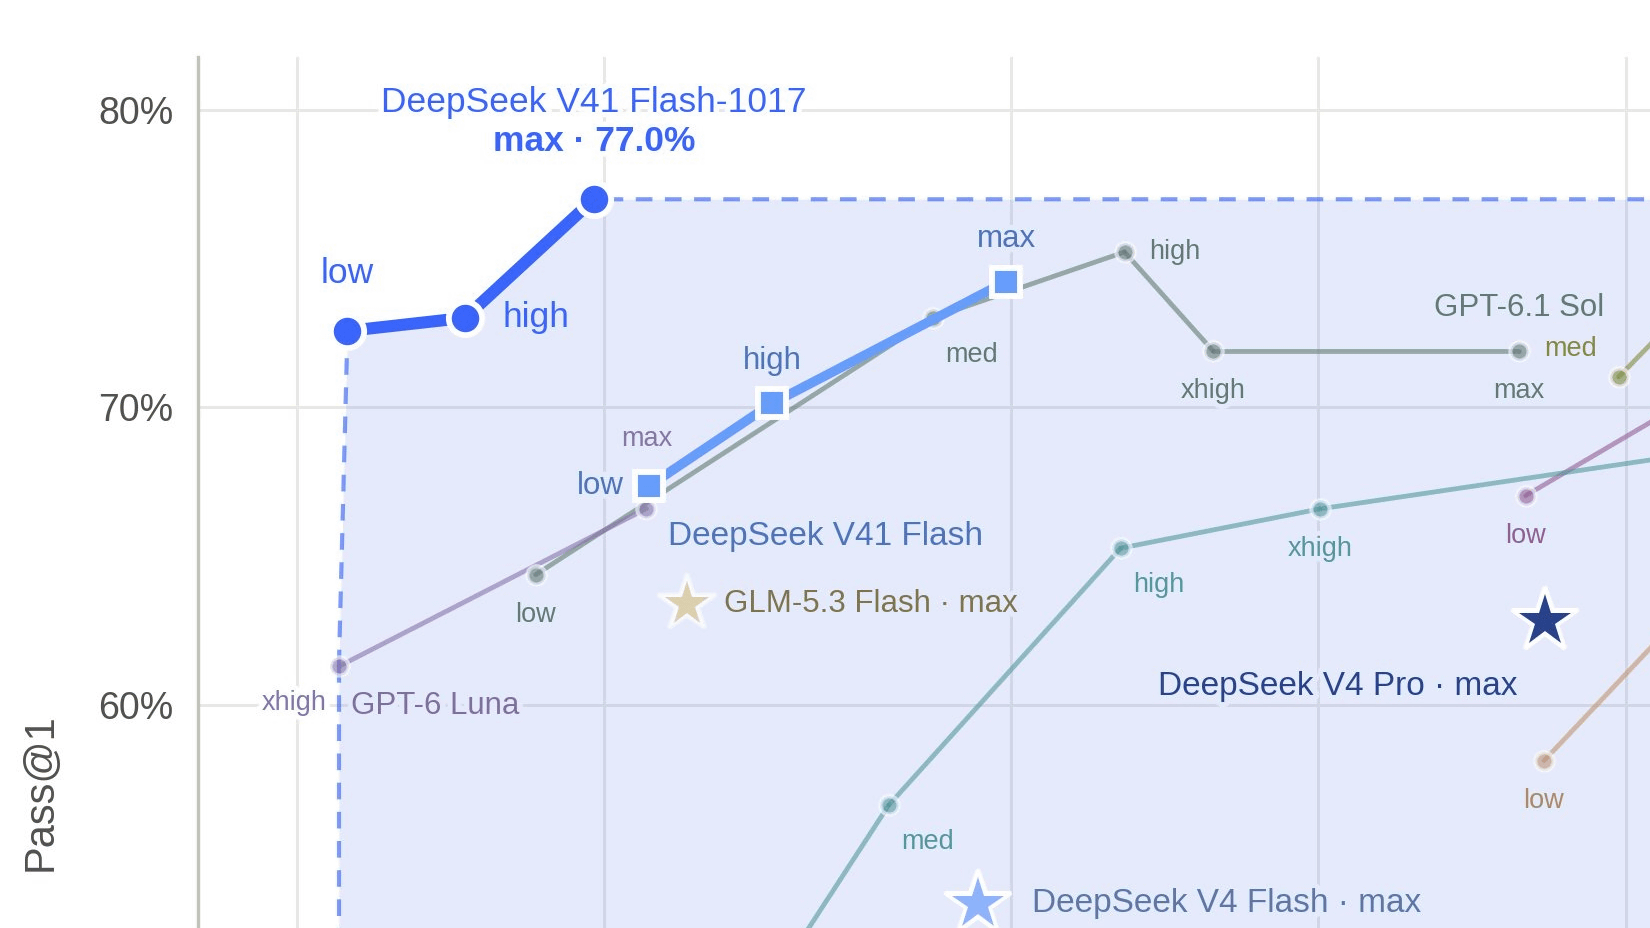
DeepSeekがDeepSeek-V4.1-Flash-1017を公開