何が起きたか
研究者が勾配ベースのSimpleLoRIFを開発し、Tulu 3に適用して上位20%の危険例を除去したSafeTuluを作成、Qwen・Llama・OLMoでGCG攻撃成功率を最大22%下げた。
なぜ重要か
表面レベルのフィルタでは見抜けない学習例を勾配空間で検査できるため、危険な例だけでなく一見無害な例でも安全ガードレールを損なうリスクを事前に排除できるとみられる。
誰に効くか自社でモデルをファインチューニングする機械学習エンジニアやデータキュレーション担当は、従来のコンテンツフィルタでは捉えにくい安全劣化を勾配ベースで事前検査できるようになる。
こういう要約が、毎朝あなたのメールに届きます。
大規模言語モデルのファインチューニングでは、明らかに有害な例だけでなく、一見無害な例でも安全ガードレールを損なう可能性がある。従来のLLM-as-judgeや標準的なコンテンツフィルタは表面信号を評価するため、どの学習例が不安全な勾配方向にモデルを押すかを検出できない。SimpleLoRIFは逆伝播を最終4つのトランスフォーマーブロックに限定することで、約100万例規模のデータセットでも勾配空間の検査を可能にした。Tulu 3に適用して上位20%を除去したSafeTuluは、Qwen・Llama・OLMoでGCG攻撃成功率を最大22%低減し、検出AUCは最大0.865に達した。下流能力はほぼ維持または改善される。著者らはツール実行の失敗や物語的な算術も、これまであまり研究されていなかった安全劣化の原因として指摘している。
業界と使っているAIツールを選ぶと、仕事に関係するニュースが毎朝届きます。
登録無料・Googleアカウントなら30秒・いつでも解除できますAITodayについて →
この記事についてわからないことをAIに質問できます。AIはこの記事・AIToday の過去記事・Wikipedia を読み、出典を付けて答えます。Q&Aはこのページに公開され、他の読者も読めます。
このようなAIの動きを、御社の業界・競合に合わせて毎日届ける法人プランもあります → 詳しく見る
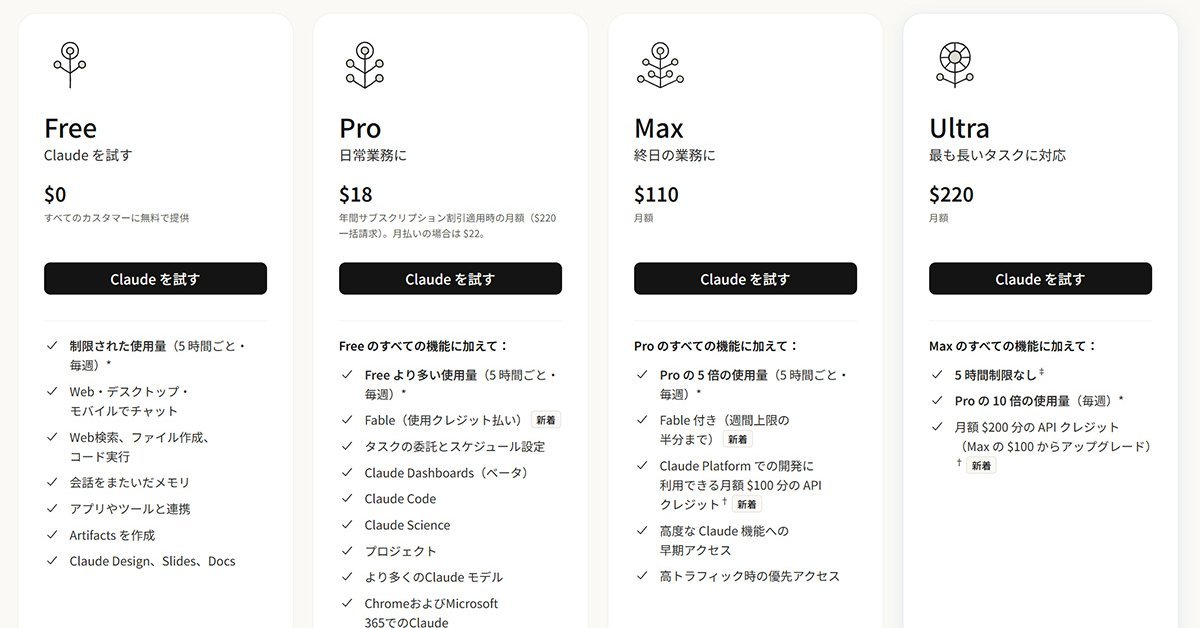
AnthropicはMax 5xをMaxに、Max 20xをUltraに改名し、月額110ドルと220ドルは据え置いた
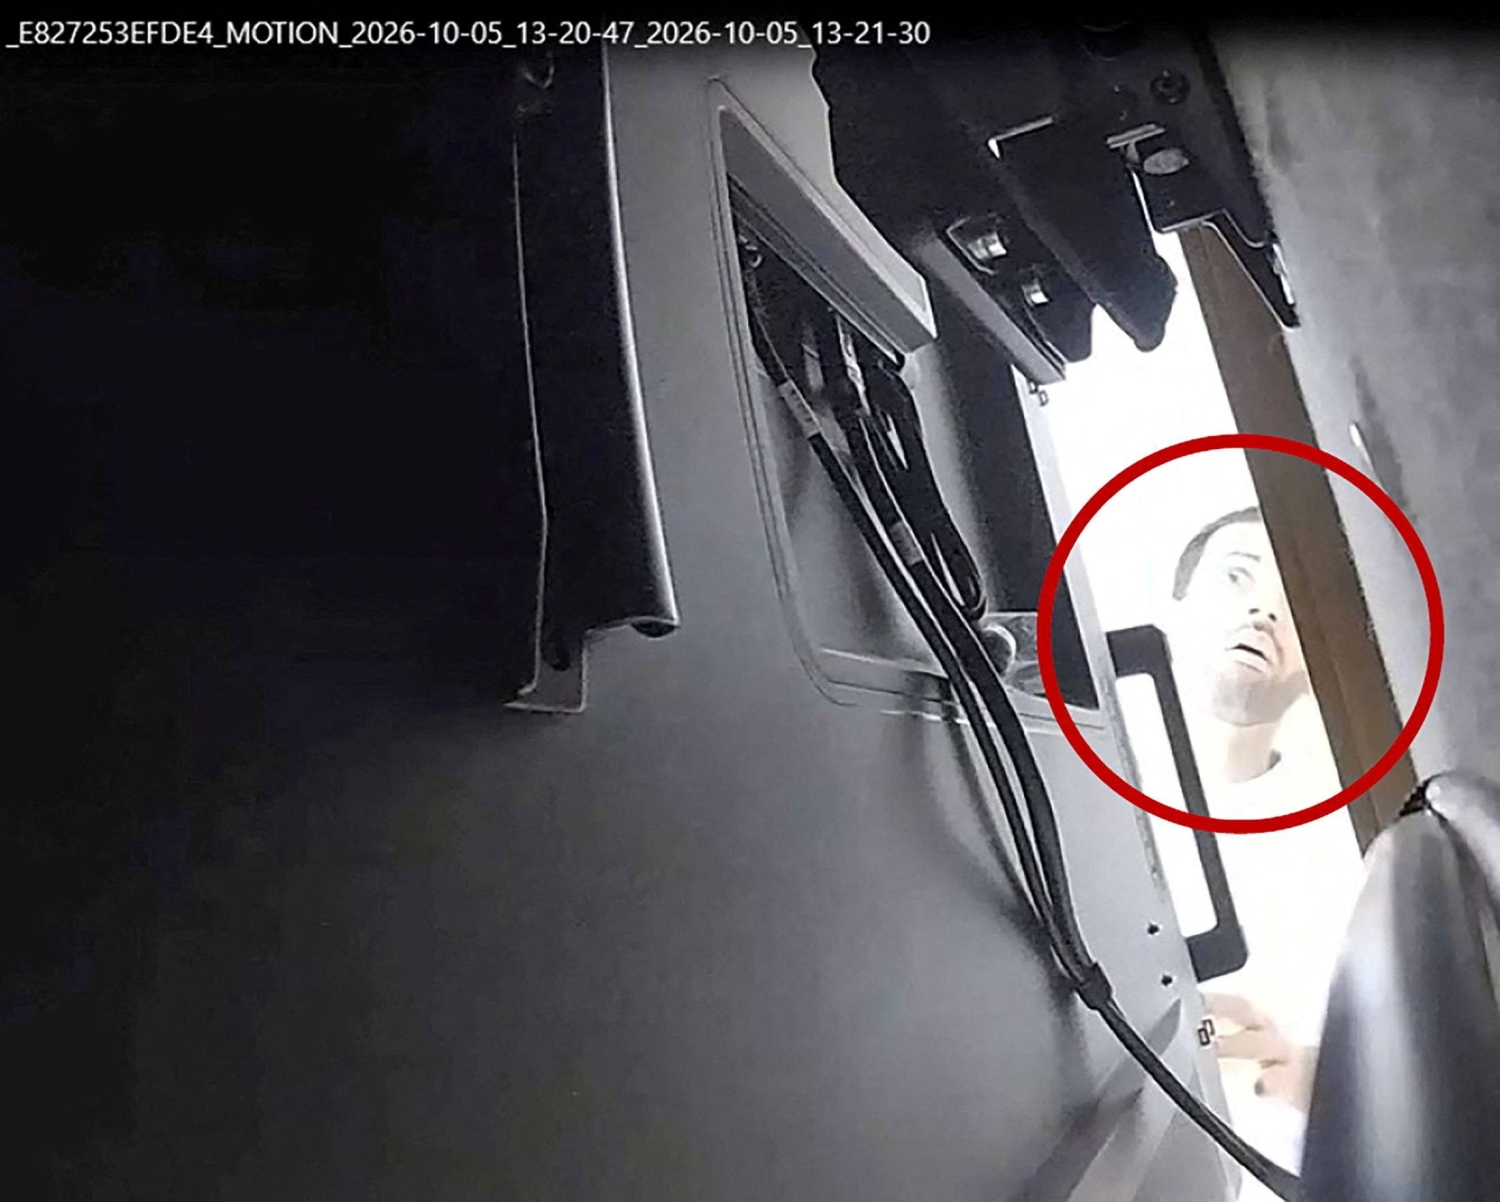
5人によるとOpenAI職員は2022年後半のChatGPT公開前から最高幹部や取締役会に、外国政府を含む外部が機密技術詳細を容易に入手できると警告した
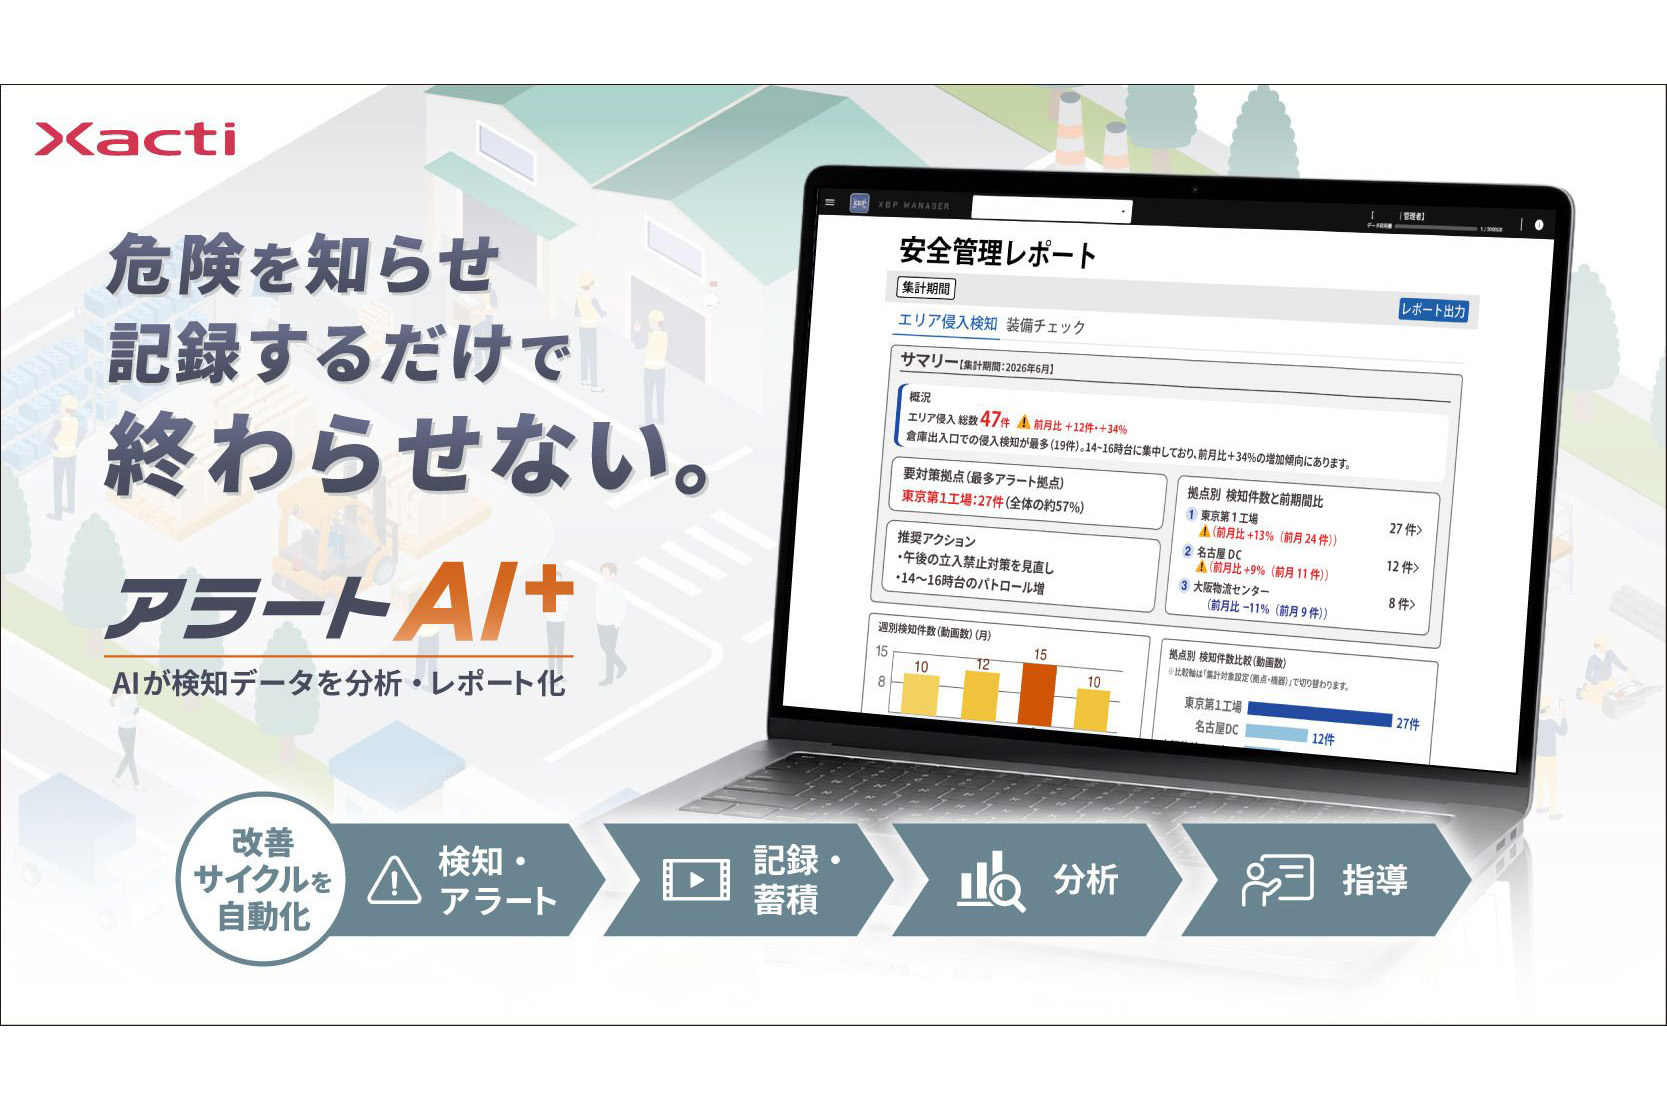
ザクティは、立入禁止区域や重機エリアへの侵入、ヘルメットや反射ベストの不着用をAIカメラで検知し、即時通知で着用を促すAlert AI+の提供を開始した
Chrome 157の安定版がリリースされ、Android版ChromeにLanguage Detector APIが追加された
GoogleはK-12アカウントでGemini、Gemini Notebook、Gemini in Classroom、Google Searchを管理者が有効化するまで既定でオフにすると発表した
Nvidia DGX Spark上の自転車ルート判断テストで、TypeSafe AIのJevがwinnowモデルを動かすOllayaを破り1位