何が起きたか
Lauren Tan氏はSpaceX AIのGrok Botチームで月約2,000件のプルリクエストを本番環境へ出荷したと語る。常時のエージェント監視をやめ、自律環境を構築したことが要因だという。
なぜ重要か
より良いAI推論を待つのは誤った賭けだと同氏は主張する。堅牢なガードレールがあればエージェントはほぼミスできないという考えだ。
注目点
この仕組みが持続するかが鍵となる。同氏によれば5段階のTrust Hierarchyで人的レビューは最下位、拡張性が最も低い。Duneフレームワークでコメント禁止が続くかも注目だ。
誰に効くかコーディングエージェントを展開中のエンジニアリングリーダーやプラットフォームチームにとって、力をどこに注ぐべきかについて最も明確な教訓となる。生成された変更を手作業でレビューするのではなく、型付き制約、lintルール、検証ツールに注力すべきだ。この主張は非エンジニアにも向けられている。適切に構築された環境こそが、CEOやデザイナーが安全にコードを出荷できるようにするからだ。
こういう要約が、毎朝あなたのメールに届きます。
Tan氏はこの問題を多くのチームが心当たりのあるものとして位置づける。エージェントがコードを書くと、人は結局すべての行をレビューしチャットで細かな修正を指示することになり、同氏によれば真のスケーラビリティには程遠い。その答えはより良いモデルを待つことではなく、エージェントが自力で働ける環境を設計することだ。
5段階のTrust Hierarchyがその理由を説明する。コードベースとアーキテクチャにおける物理的制約が最も自動的に拡張し、次にlintやCIなどの静的解析、次にルールとプレイブック、次に自然言語のスタイルガイド、最後に人的レビューが来るが、これは人に依存しほとんど拡張しない。同じ考え方で、同氏は自分を庭師に例える。大規模言語モデルはコンテキストにあるコードを模倣する傾向があり、1つのパッチがウイルスのように広がりうるため、回避策を抜き取るというわけだ。
同氏が挙げる支援インフラには、Chrome DevTools Protocol上に構築された検証CLI「ControlGlass」がある。エージェントがアプリを起動し、トレースを収集し、ヒープスナップショットを自力で分析できる。さらに曖昧なバグ報告を正確なDOM要素とコード位置に結びつけるFeature Map、シニアエンジニアのワークフローから抽出したプレイブック集Pystackもある。最も外側に位置するのがイベント駆動レイヤーだ。Grok Bot RoutinesがSentryのアラートとSlackスレッドを監視し、クラウドエージェントを起動してバグを再現し、パフォーマンス統計付きの修正PRを作成する。このモデルが同氏のチームを超えて広がるかは、一般的な組織がこうしたツール群をどれだけ構築する意欲があるかにかかっているだろう。アプローチ全体が単一のモデルではなく、その土台に依存しているからだ。
業界と使っているAIツールを選ぶと、毎朝7時に仕事に関係するニュースが届きます。
登録無料・Googleアカウントなら30秒・いつでも解除できますAITodayについて →
この記事についてわからないことをAIに質問できます。AIはこの記事・AIToday の過去記事・Wikipedia を読み、出典を付けて答えます。Q&Aはこのページに公開され、他の読者も読めます。
AlibabaのQwenチームが2026年9月20日、Qwen-Image-2.1をオープンソース化
2026年9月29日、803行の仕様索引ファイル1件を読ませたところ、外部プログラムの返却は約798トークン、処理対象は28,407トークンで、圧縮率は概算で約97.2%だった
試験運用でエージェントは.NETを導入し、コアライブラリをビルドし、34件の単体テストとCI設定を約5分で終えた——しかしpush直前に、.claude/配下のSTATE.md編集の承認待ちで止まった
KnowledgeSenseは9月30日、国産AIエージェントCodeSenseを数週間以内にリリースすると発表し、現在β版ユーザーを募集している
SAILはVLMで軌道を生成し、シミュレータで実行、映像から進捗を採点し、修正した軌道をアームに送る

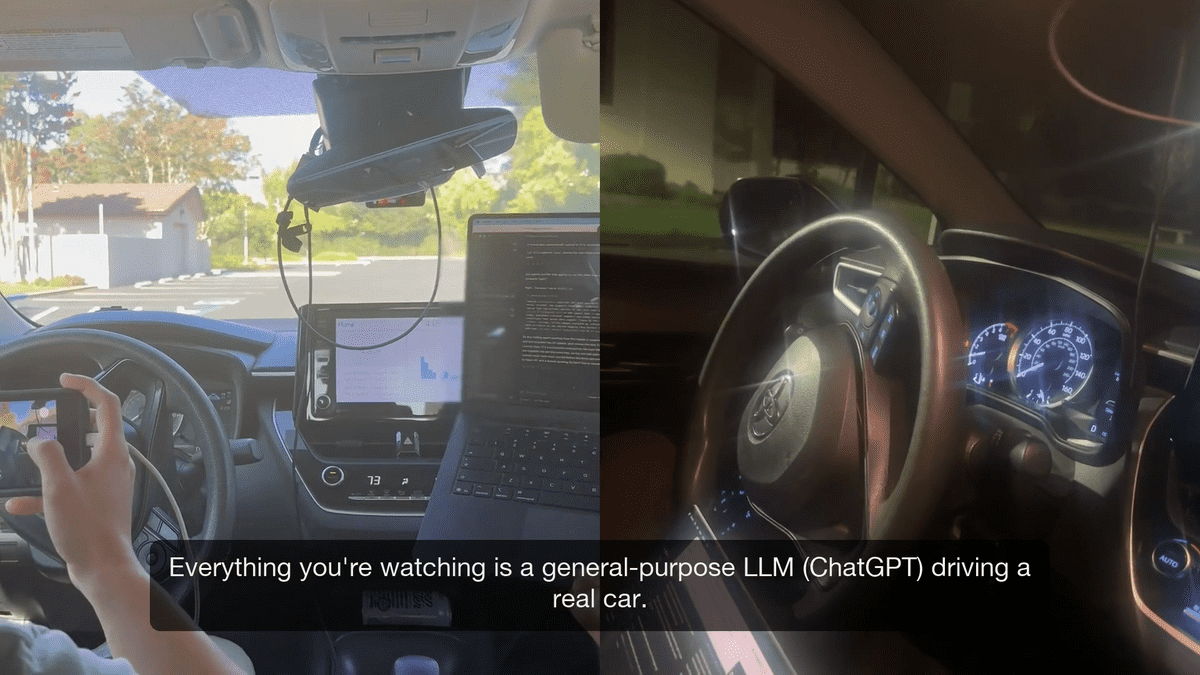
Axiom Mathの3人が2022年式トヨタ・カローラとcomma four、openpilotを使うDrivingBenchで4モデルを走らせ、約135mのコースを完走したのはGPT-6 Astraだけで、5分22秒…