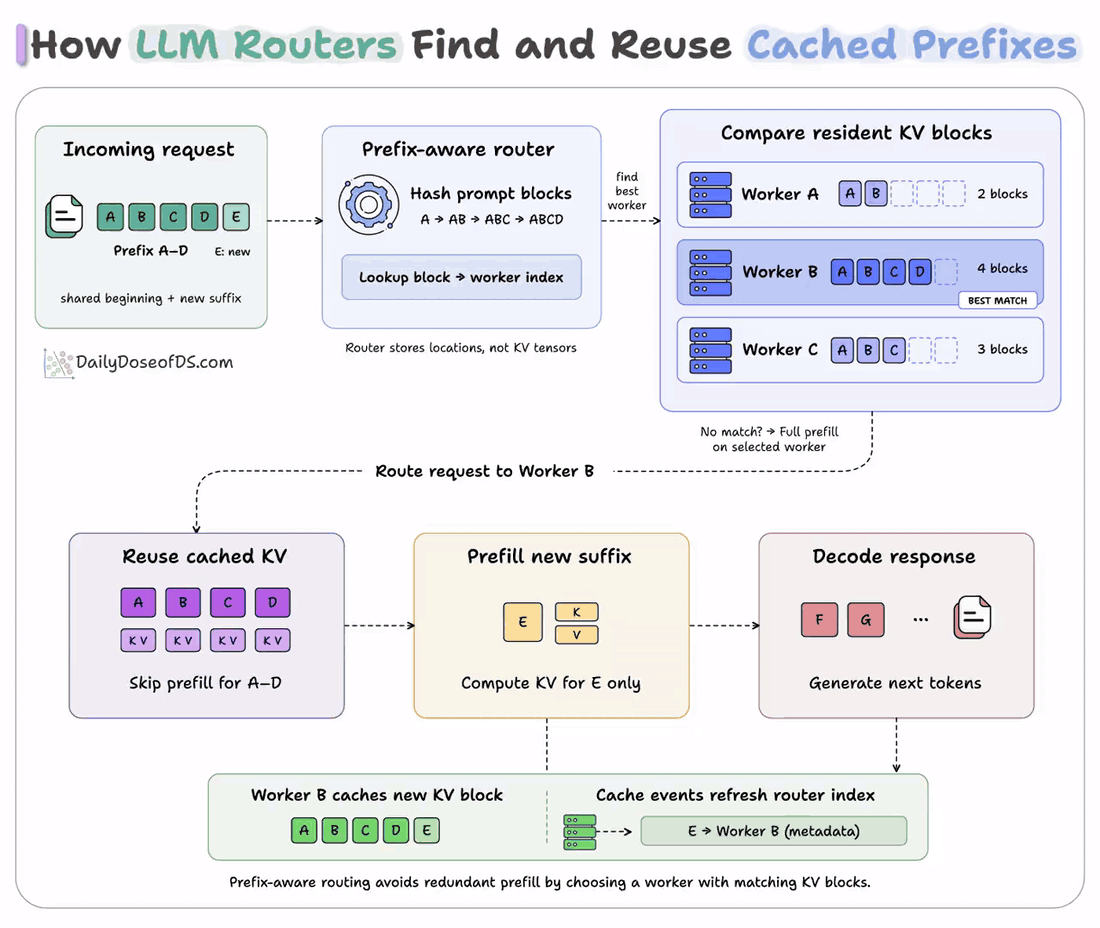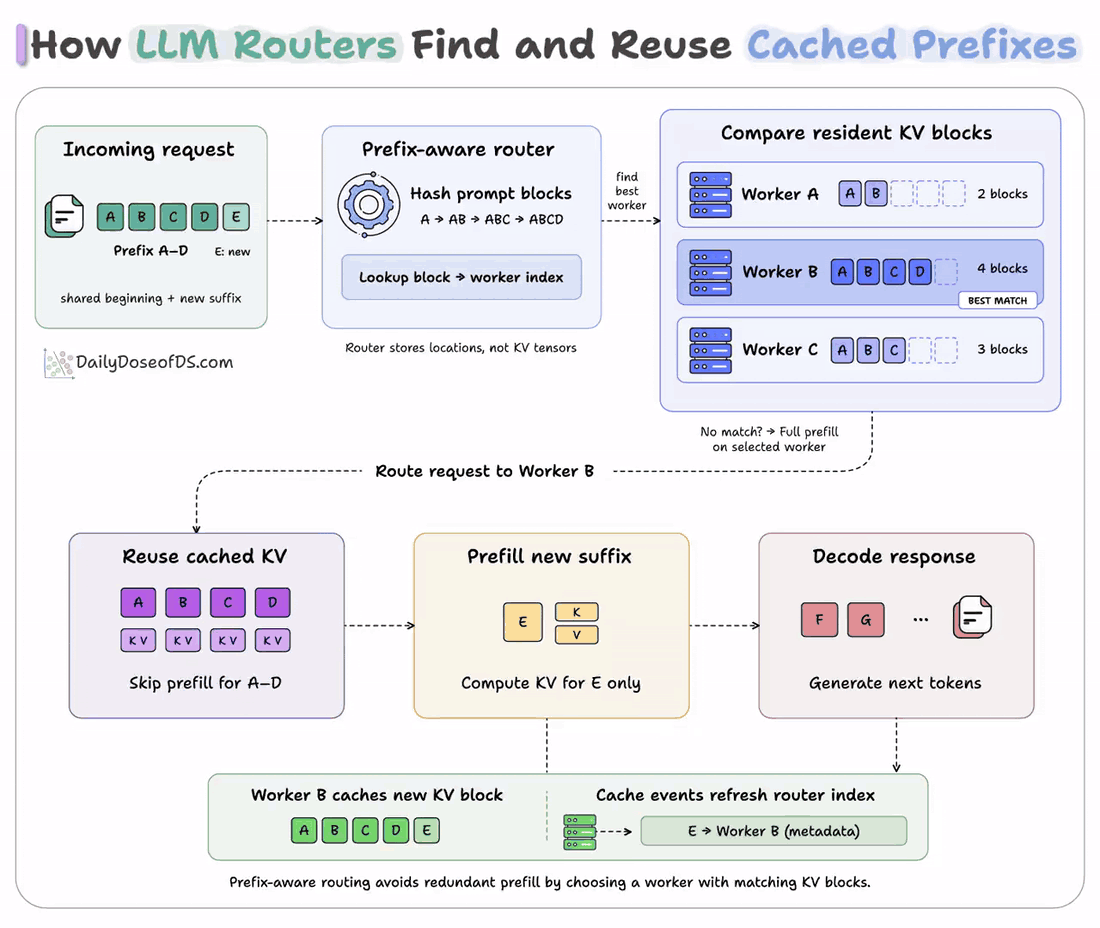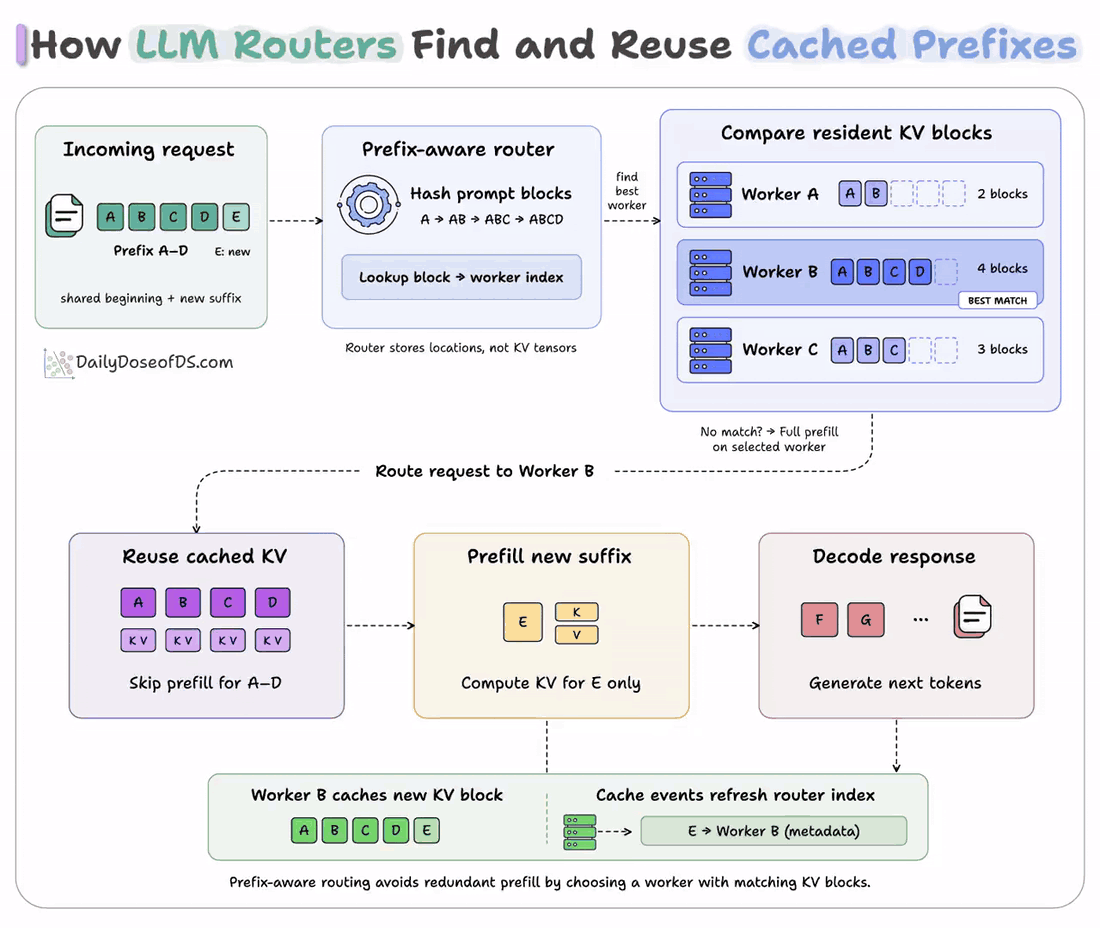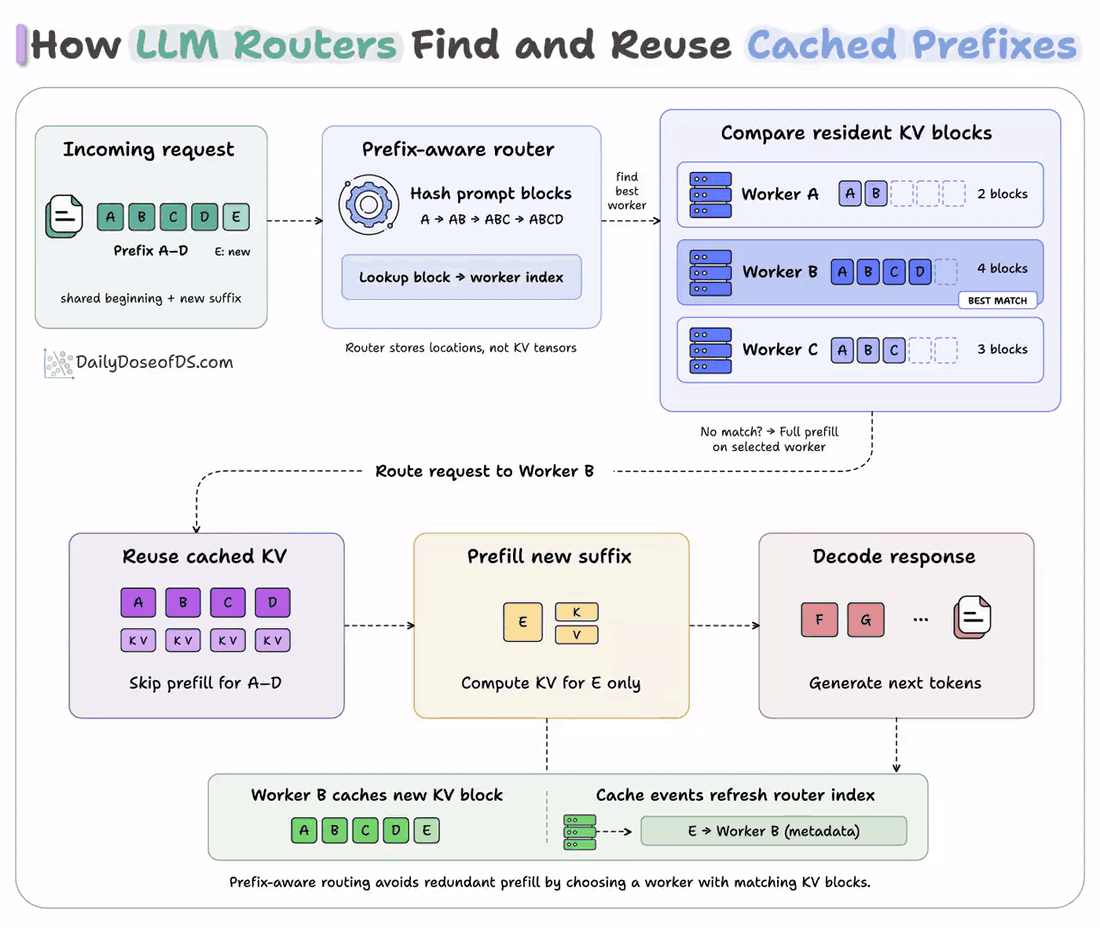
何が起きたか
16台のH100の8つのvLLMポッドでllm-dをテストし、プレフィックス考慮ルーティングでp90の最初のトークンまでの時間が92.6秒から0.54秒に短縮、スループットは4,429から8,730トークン/秒へ倍増した。
なぜ重要か
このベンチマークは、共有プロンプトプレフィックスの完全な再計算を避けることが高速化を生むため、ルーターがリクエストをどこへ送るかが、作業をどれだけ均等に分散するかよりも重要になり得ることを示している。
こういう要約が、毎朝あなたのメールに届きます。
llm-dのベンチマークは、ルーティングの判断をLLMサービング性能の中心に据えている。テストワークロードは150の顧客を模擬し、各顧客が6,000トークンの共有コンテキストを持ち、5人のユーザーが1,200トークンの質問を3〜60 QPSで送信した。これらの共有プレフィックスはクラスタのKVキャッシュの約73%を必要とし、これは1つのポッドが保持できる量の約6倍で、ルーティングの選択が最も重要になる条件である。
ルーティング戦略間の差は大きかった。ランダムルーティングのp90の最初のトークンまでの時間は92.6秒、負荷考慮のみは94.9秒、近似プレフィックス考慮は31.1秒、精密なプレフィックス考慮は0.54秒だった。負荷考慮ルーティングはこのテストではランダムと比べて改善しなかった。各リクエストがプレフィックスを再計算しなければならないGPUに着地したためだ。
その後のllm-dの再実行では、新しいvLLM上で、単純なKubernetesのラウンドロビンServiceに対して、差は小さくなったものの、p90の最初のトークンまでの時間は依然として99%以上減少した。これらはすべてプレフィックスキャッシュ自体が機能していることに依存しており、プロンプトの先頭にあるタイムスタンプはそれ以降のすべてのブロックを壊す。
業界と使っているAIツールを選ぶと、仕事に関係するニュースが毎朝届きます。
登録無料・Googleアカウントなら30秒・いつでも解除できますAITodayについて →
この記事についてわからないことをAIに質問できます。AIはこの記事・AIToday の過去記事・Wikipedia を読み、出典を付けて答えます。Q&Aはこのページに公開され、他の読者も読めます。
このようなAIの動きを、御社の業界・競合に合わせて毎日届ける法人プランもあります → 詳しく見る
Charles SchwabはClaude for Financial Advisors、Ester、NevisをSchwab Advisor Centerに統合し、AI採用の小規模RIAにも直接インセンティブを提供する
Walmartは11月開始のAgent Profilesを発表
Alphabetの検索およびその他部門の売上高は前年同期比12%増の約630億ドルとなったが、2四半期連続で予想を下回った
旭化成ホームズがAmazonとAlexa+活用の基本合意を締結
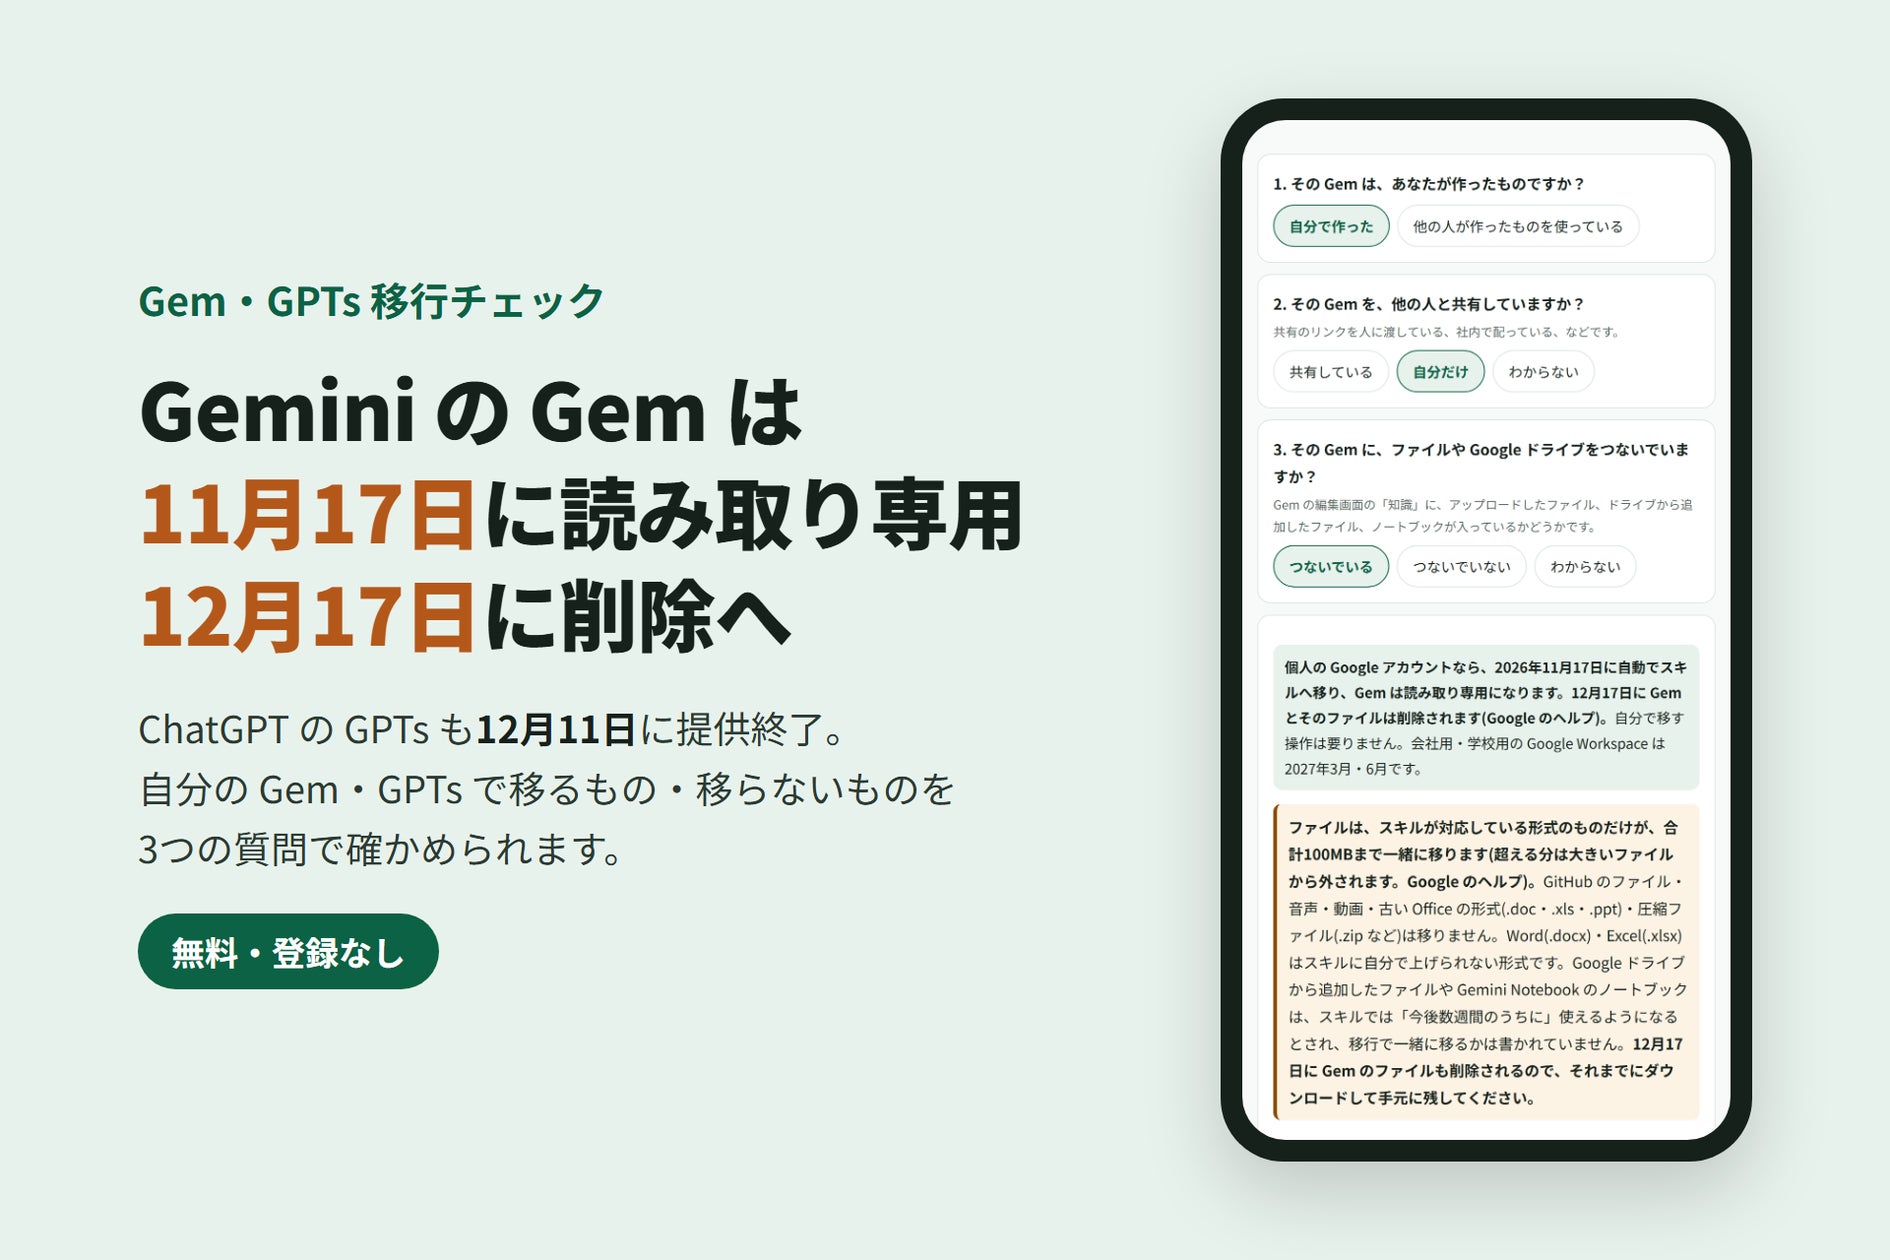
WeSalesが無料ツール「Gem 移行チェック」を公開
Aries Zhou氏がオープンソースのmacOSアプリHowlerを公開