何が起きたか
GitHubは19言語・219件の公開プルリクエストで構成するベンチマークReviewBenchを公開した。1億390万件を分析し、検証で96.6%の一致率だった。
なぜ重要か
ReviewBenchは既知の問題と新たに発見された問題の両方でエージェントを採点する。GitHubによると、オフライン結果はその後の本番実験と一貫して同じ方向を示してきた。
注目点
他チームのエージェントでもオフラインとオンラインの整合性が保たれるかが焦点だ。まず25件のテストセット、次に公開ジャッジが採点する219件のフル実行に注目したい。
誰に効くかAIコードレビューエージェントを選定・構築するエンジニアリングリーダーや開発者ツールチームは、重大度・カテゴリ別の内訳を備えた共通の尺度を得られる。これにより、適合率と網羅性のどちらを重んじるかの自チームの好みに合わせてレビュアーを比較できる。
こういう要約が、毎朝あなたのメールに届きます。
AIコードレビュアー向けの既存ベンチマークは、ラベルの品質、網羅性、実世界での代表性の間でトレードオフが生じやすく、チームが再現可能な形でシステムを比較する手段がなかった。ReviewBenchは、GitHub上の1億件を超える実際のプルリクエストを基にコーパスをモデル化し、プルリクエストのサイズを1ファイルだけの小さな変更ではなくレビュー可能な中規模・裾野側に重み付けすることで、このギャップを埋めようとするGitHubの試みだ。
その正解データは、人間のレビュアー、著者の後続コミットから推測されるissue、決定論的な解析ツール、複数の最先端LLMから集められ、重複排除した上で1つの公開ルーブリックに基づいて判定される。レビュアーエージェントは2系統の指標で採点される。既存のゴールドセットのラベルに対する根拠付きの適合率と再現率、そしてゴールドセット作成者が surface しなかった有効な指摘も評価できる拡張適合率と再現率だ。結果は重大度やカテゴリ別に集計でき、より広い網羅性を好むかノイズの少なさを好むかに応じてFβスコアのβを調整して並べ替えることもできる。
GitHubによると、このベンチマークはCopilotコードレビューを繰り返し評価するために使われており、オフラインでの変化はその後の本番A/Bテストと一貫して同じ方向を示してきた。したがって成否は、このオフラインとオンラインの整合性がGitHub外で構築されたエージェントでも保たれるかどうかにかかっており、公開リーダーボードとセルフサーブの実行環境はそれを検証するために設計されている。
業界と使っているAIツールを選ぶと、仕事に関係するニュースが毎朝届きます。
登録無料・Googleアカウントなら30秒・いつでも解除できますAITodayについて →
この記事についてわからないことをAIに質問できます。AIはこの記事・AIToday の過去記事・Wikipedia を読み、出典を付けて答えます。Q&Aはこのページに公開され、他の読者も読めます。
Ghost AIはAndreessen Horowitzがリードし、Abstract、Audacious Ventures、Nova、SV Angelが参加した1100万ドルの調達を実施
OpenAIは数週間以内にEUの全ChatGPT・Codex有料プランユーザーへ不可視のテキスト透かしを展開し、検出ツールtextGrainの報告書を公開
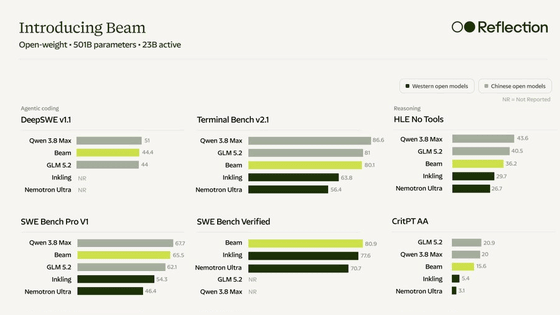
Reflectionがパラメーター数5010億・アクティブ230億のオープンモデルBeamを発表
スタンフォード大学やMicrosoft Researchなどの研究チームが最先端AIモデル8種類に6800以上のタスクを実行させた結果、32%のケースで低価格モデルの総コストが高くなった
Reflection AIが5010億パラメータのオープンソースLLM「Beam」を公開
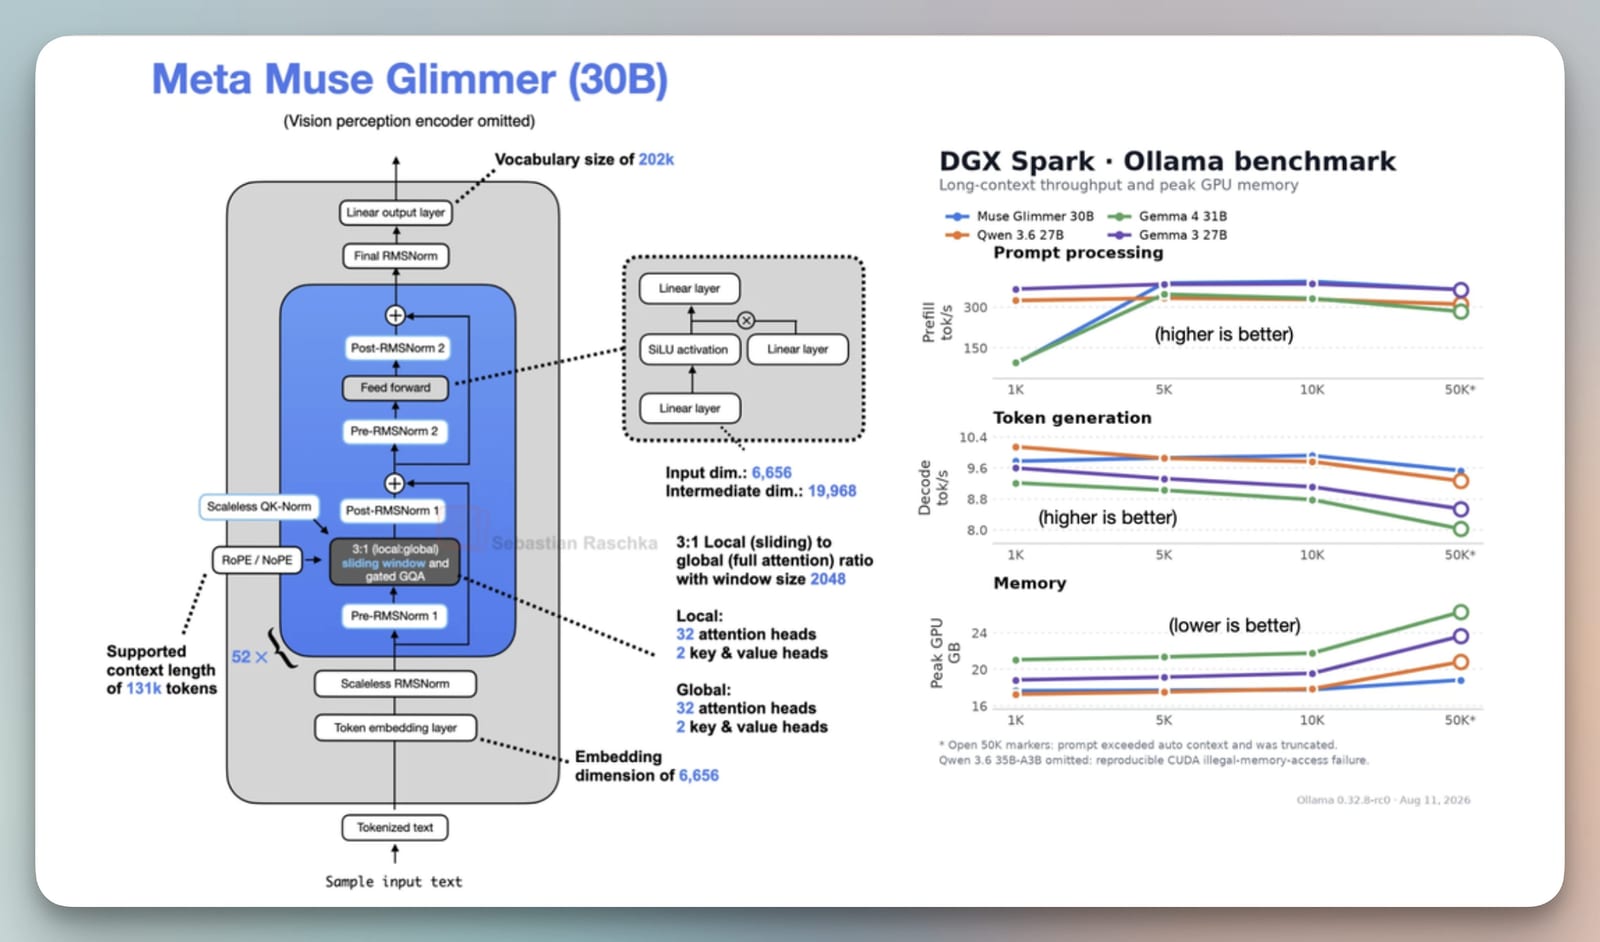
Meta Superintelligence Labs初のオープンモデルMuse Glimmer(30B)がApache 2.0で公開され、0.44%のLoRA訓練で数式画像からLaTeXへの変換を改善できる