何が起きたか
約8,400文字の記事を3〜5個の箇条書きで要約させると、gemma4:e4bは93秒で一発応答、qwen3.5:9bは178秒でcontent 0文字となった。
なぜ重要か
両モデルとも絵文字見出しや表を備えた長大な多節レポートを出力し、簡潔な箇条書きの指示を無視した。
こういう要約が、毎朝あなたのメールに届きます。
連載の第6回で、それまでコーディング関連タスクのみを扱ってきた視点を資料作成と要約に移している。手法は意図的にシンプルで、著者が自身の約8,400文字の技術記事をバックグラウンド負荷のない状態でOllamaのAPIに投入し、3〜5個の箇条書きによる日本語要約を求めた。
最も目を引く結果は速度ではなく、qwen3.5:9bの空応答だ。done_reasonが「length」だったことは、モデルが生成上限をすべて思考に消費したことを示しており、著者によればstudy4とstudy5のOrnith系モデルでも再現したという。think: falseを設定すると解消したことから、思考対応モデルをAPI経由で直接使う場合はこのフラグを明示しないと空出力のリスクがあると指摘している。
品質面では、両モデルとも内容は正確だったが形式指示を無視し、絵文字見出しや比較表、コードブロックまで含む長大な戦略レポートを生成した。著者の実践的な教訓は「簡潔に」だけでは通用せず、プロンプトに文字数と出力形式の厳格な制限が必要だということだ。また、今回のテストは1タスクの1回のみであり、文書の種類やプロンプトで指示追従の結果は変わり得るとも注記している。
業界と使っているAIツールを選ぶと、仕事に関係するニュースが毎朝届きます。
登録無料・Googleアカウントなら30秒・いつでも解除できますAITodayについて →
この記事についてわからないことをAIに質問できます。AIはこの記事・AIToday の過去記事・Wikipedia を読み、出典を付けて答えます。Q&Aはこのページに公開され、他の読者も読めます。
このようなAIの動きを、御社の業界・競合に合わせて毎日届ける法人プランもあります → 詳しく見る
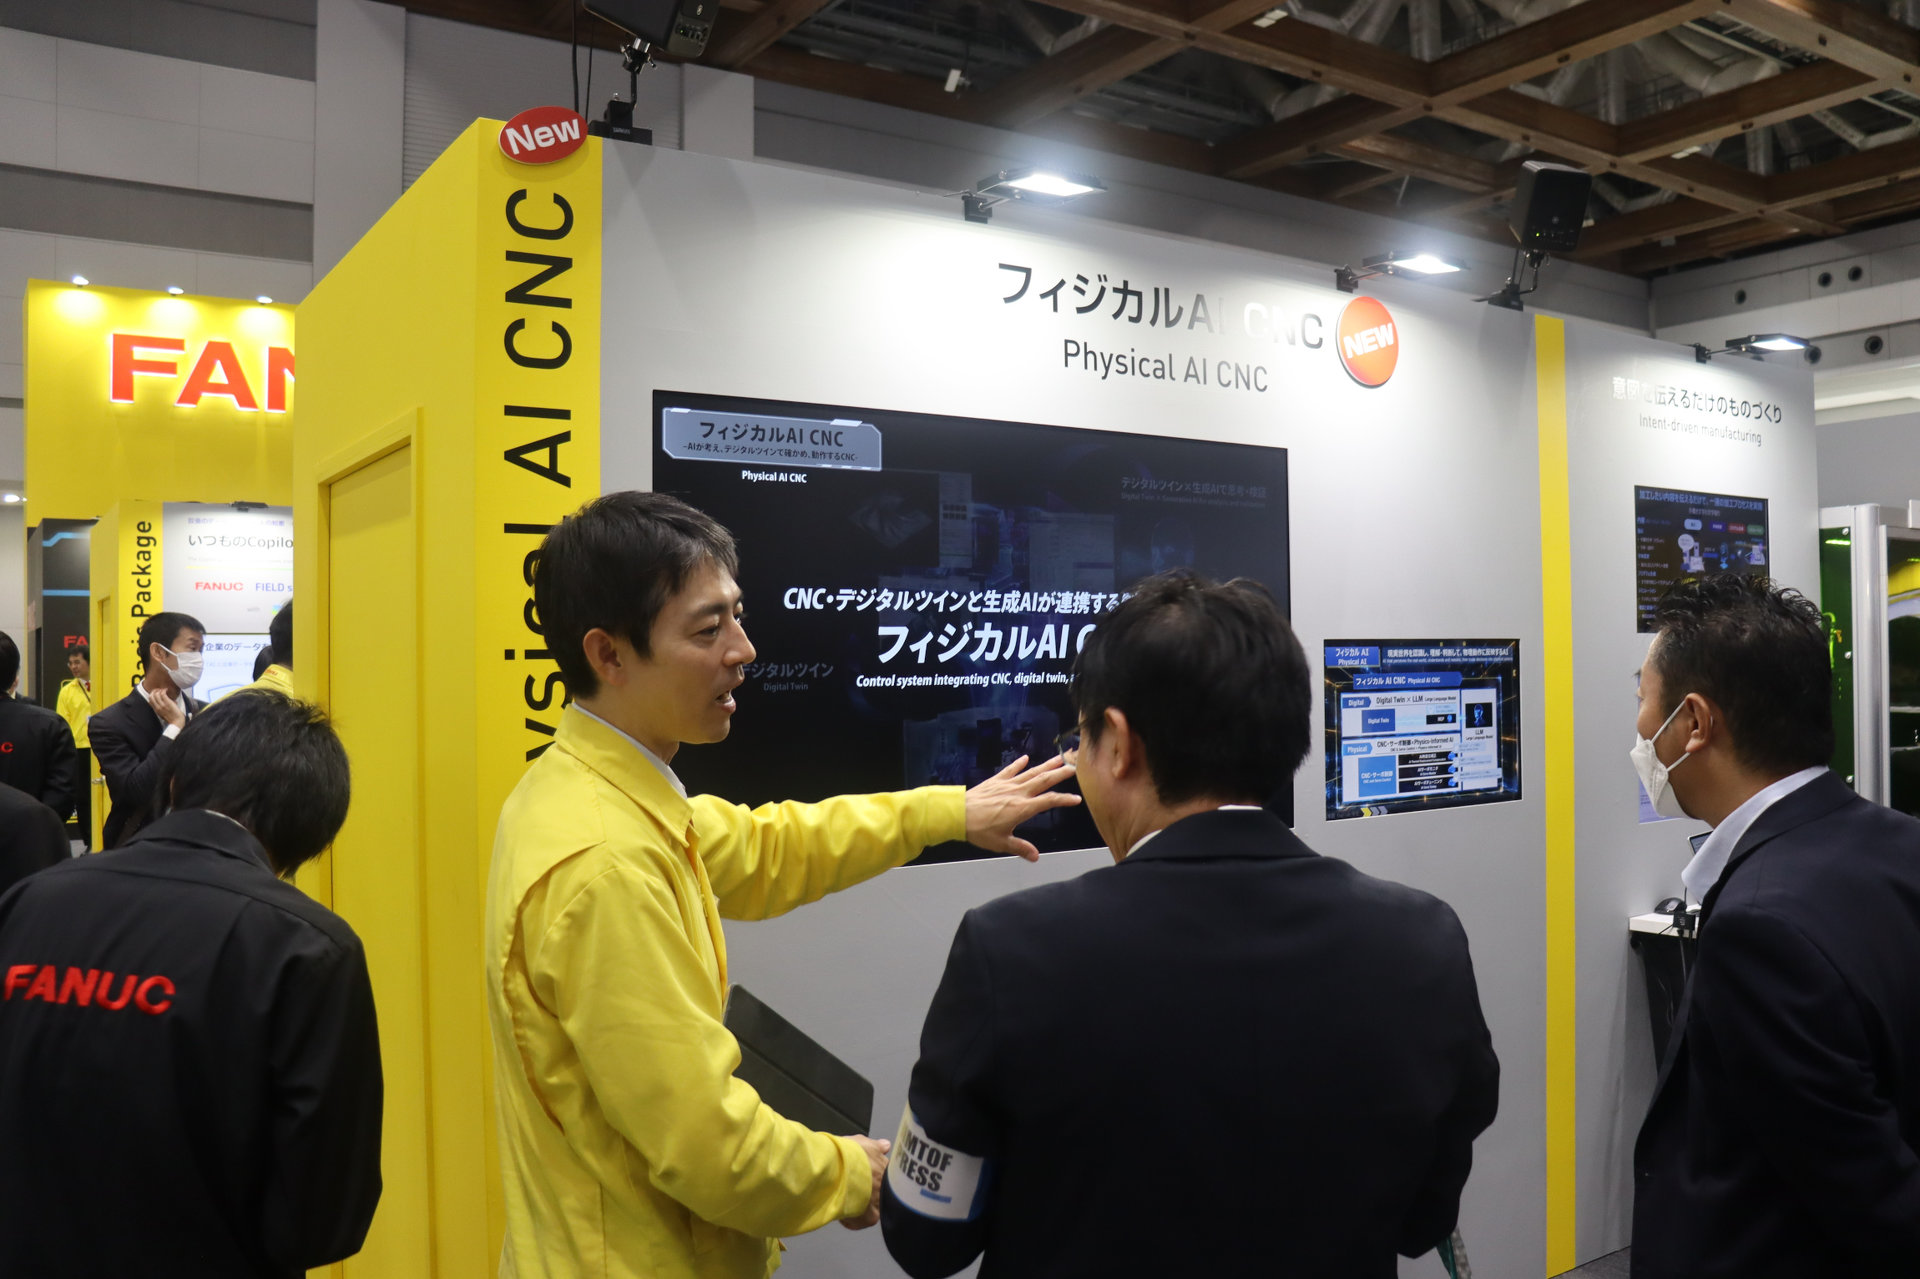
JIMTOF2026でファナックは、LLMがMCPサーバーを通じCNCデータにアクセスし設定を変更するフィジカルAI CNCのコンセプトを披露
AnthropicはAPI顧客にClaude Mythos 5、Claude Opus 4.7、Claude Opus 4.6、Claude Sonnet 4.6へ透かしを入れると通知した
OSSの記憶システムHindsight(vectorize-io、MITライセンス)をDocker経由で素のClaude APIエージェントに接続し、過去の文脈をシステムプロンプトに呼び出してやり取りを保持した
Claude Code実行キットを解説
OpenAIはTrusted Accessメンバーに11月29日からDaybreak Blueのセッションデータを学習に使うと通知
General Catalyst主導で$48.5 Millionを調達したArcaが、独自のエージェント基盤と顧客ごとのメモリーシステムを構築