何が起きたか
OSSの記憶システムHindsight(vectorize-io、MITライセンス)をDocker経由で素のClaude APIエージェントに接続し、過去の文脈をシステムプロンプトに呼び出してやり取りを保持した。
なぜ重要か
recallとretainのループにより、再起動したエージェントはゼロからではなく同じ保存済み文脈を引き継げる。この点を2つの別プロセスにまたがって実演している。
こういう要約が、毎朝あなたのメールに届きます。
このウォークスルーは問題を具体的に描く。Claude APIエージェントのプロセスが終わると、築いた文脈は消え、次のセッションは初対面から始まる。RAGでドキュメントを検索するのとは別物で、保存されるのはユーザーの好みや過去に失敗したアプローチを含むエージェント自身の経験だという。提案される進め方は、Postgresとpgvectorのスキーマやretain/recallのロジックを自作するのではなく、まず既製品を試し、足りない部分だけを作ること。
Hindsightの構造が、筆者の説明における差別化点だ。記憶を世界の事実、経験、観察、メンタルモデルに分け、操作はretain、recall、reflectの3つだけ。reflect層がより単純な記憶ストアとの違いとされ、蓄積した経験を高次の理解に変えられる。v0.10.1のリリースノートにはコーディングエージェント向けの自動reflect予算上限の修正もあり、reflectを頻繁に走らせるとLLM呼び出しコストが積み上がるという注意も添えられている。
実践的な教訓は機能ではなく運用にある。記憶はbank_idで分離され、ユーザーIDやプロジェクトIDを前提に最初から設計すれば権限分離も兼ねられる。日次cronでreflectを回すと個々のQ&Aをメンタルモデルの記憶に統合できるが、頻度が高すぎるとコストが増える。本番ではまずbank_idによる権限分離とreflectの実行頻度の2点を決めるべきだという。
業界と使っているAIツールを選ぶと、仕事に関係するニュースが毎朝届きます。
登録無料・Googleアカウントなら30秒・いつでも解除できますAITodayについて →
この記事についてわからないことをAIに質問できます。AIはこの記事・AIToday の過去記事・Wikipedia を読み、出典を付けて答えます。Q&Aはこのページに公開され、他の読者も読めます。
このようなAIの動きを、御社の業界・競合に合わせて毎日届ける法人プランもあります → 詳しく見る
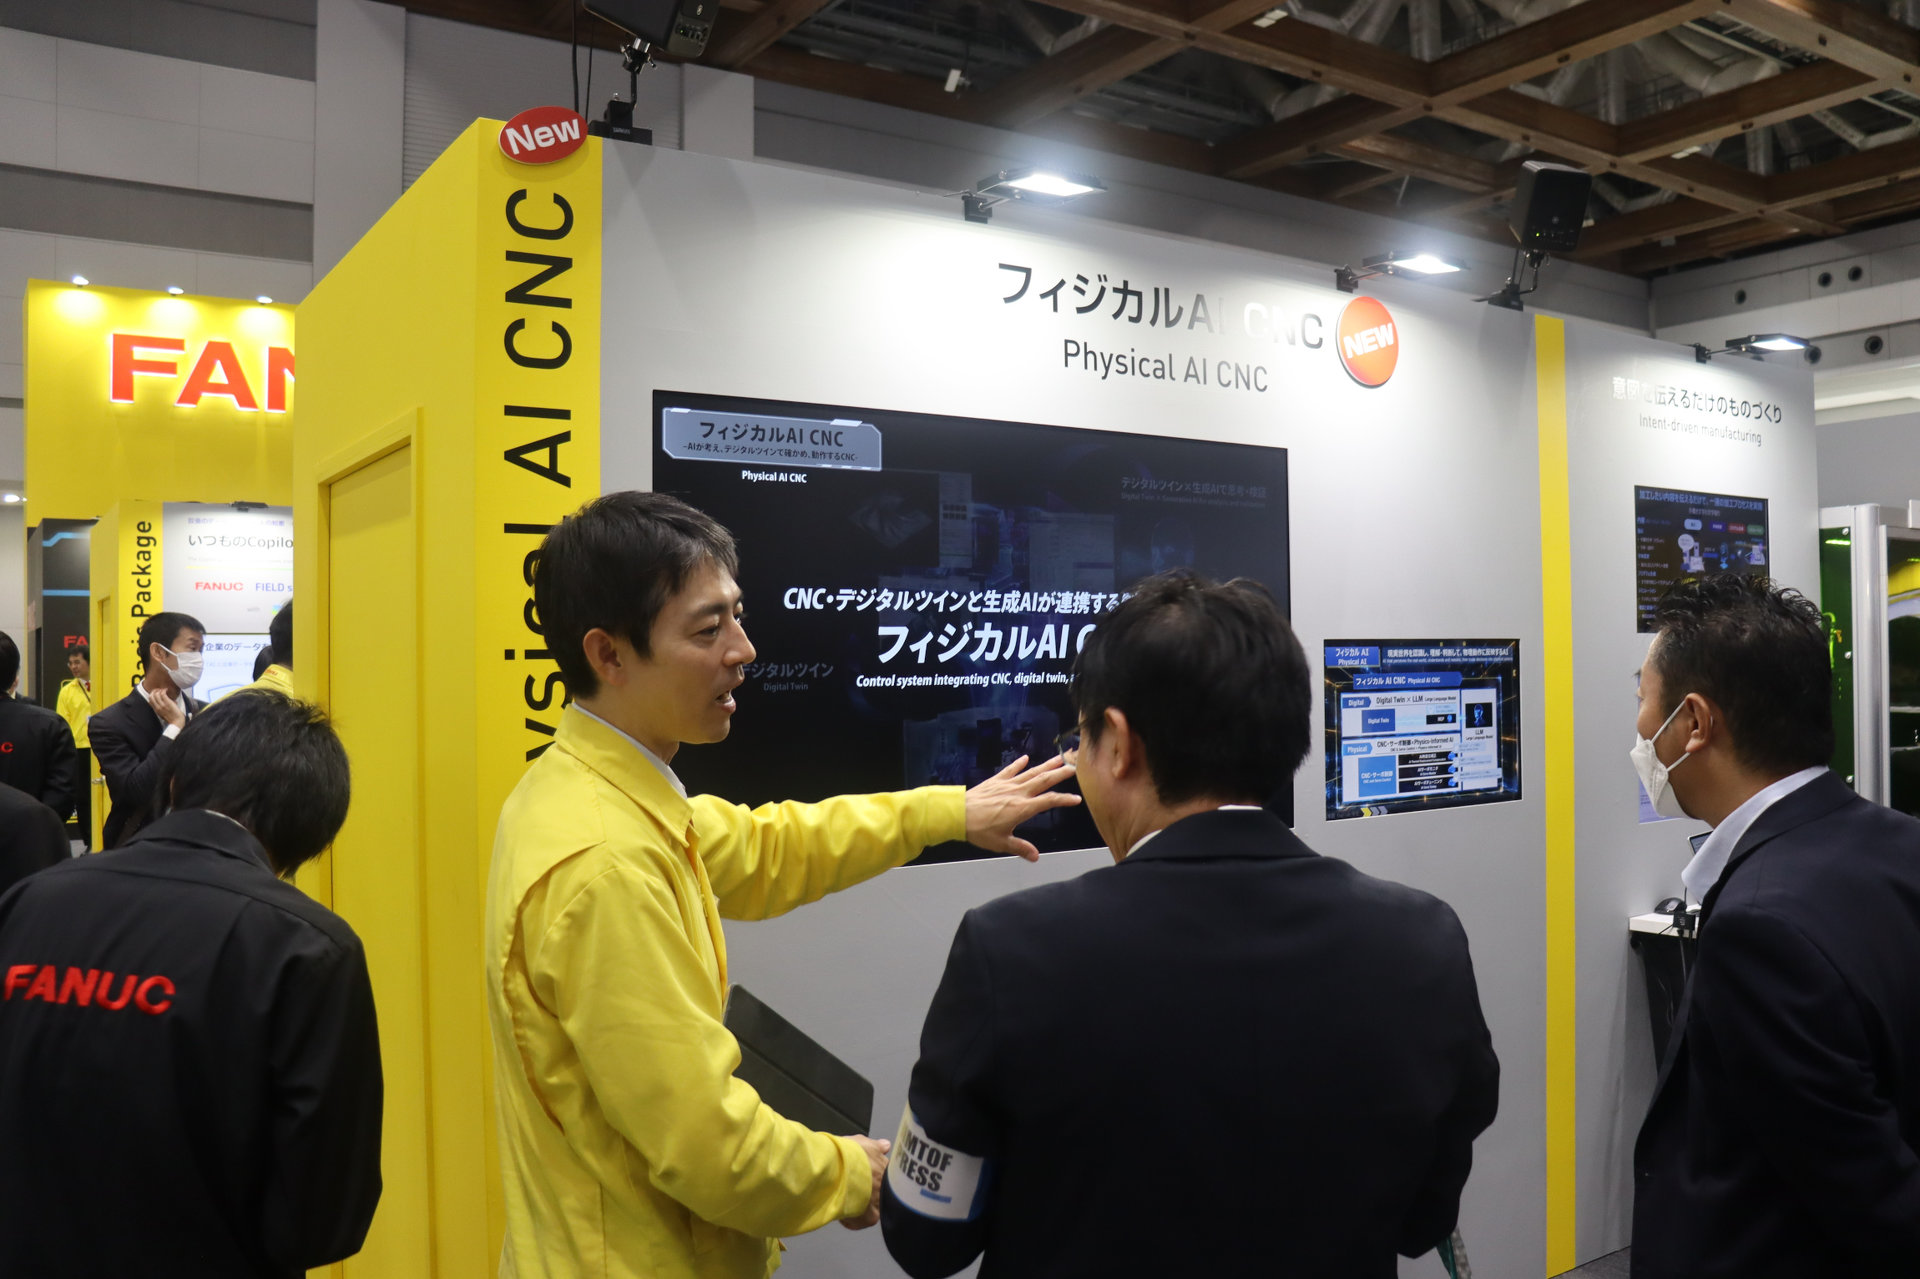
JIMTOF2026でファナックは、LLMがMCPサーバーを通じCNCデータにアクセスし設定を変更するフィジカルAI CNCのコンセプトを披露
AnthropicはAPI顧客にClaude Mythos 5、Claude Opus 4.7、Claude Opus 4.6、Claude Sonnet 4.6へ透かしを入れると通知した
約8,400文字の記事を3〜5個の箇条書きで要約させると、gemma4:e4bは93秒で一発応答、qwen3.5:9bは178秒でcontent 0文字となった
PhorionがCursorのマーケットプレイスで公式Claude Code拡張機能2.1.313のバックドアを発見
Claude Code実行キットを解説
OpenAIはTrusted Accessメンバーに11月29日からDaybreak Blueのセッションデータを学習に使うと通知