何が起きたか
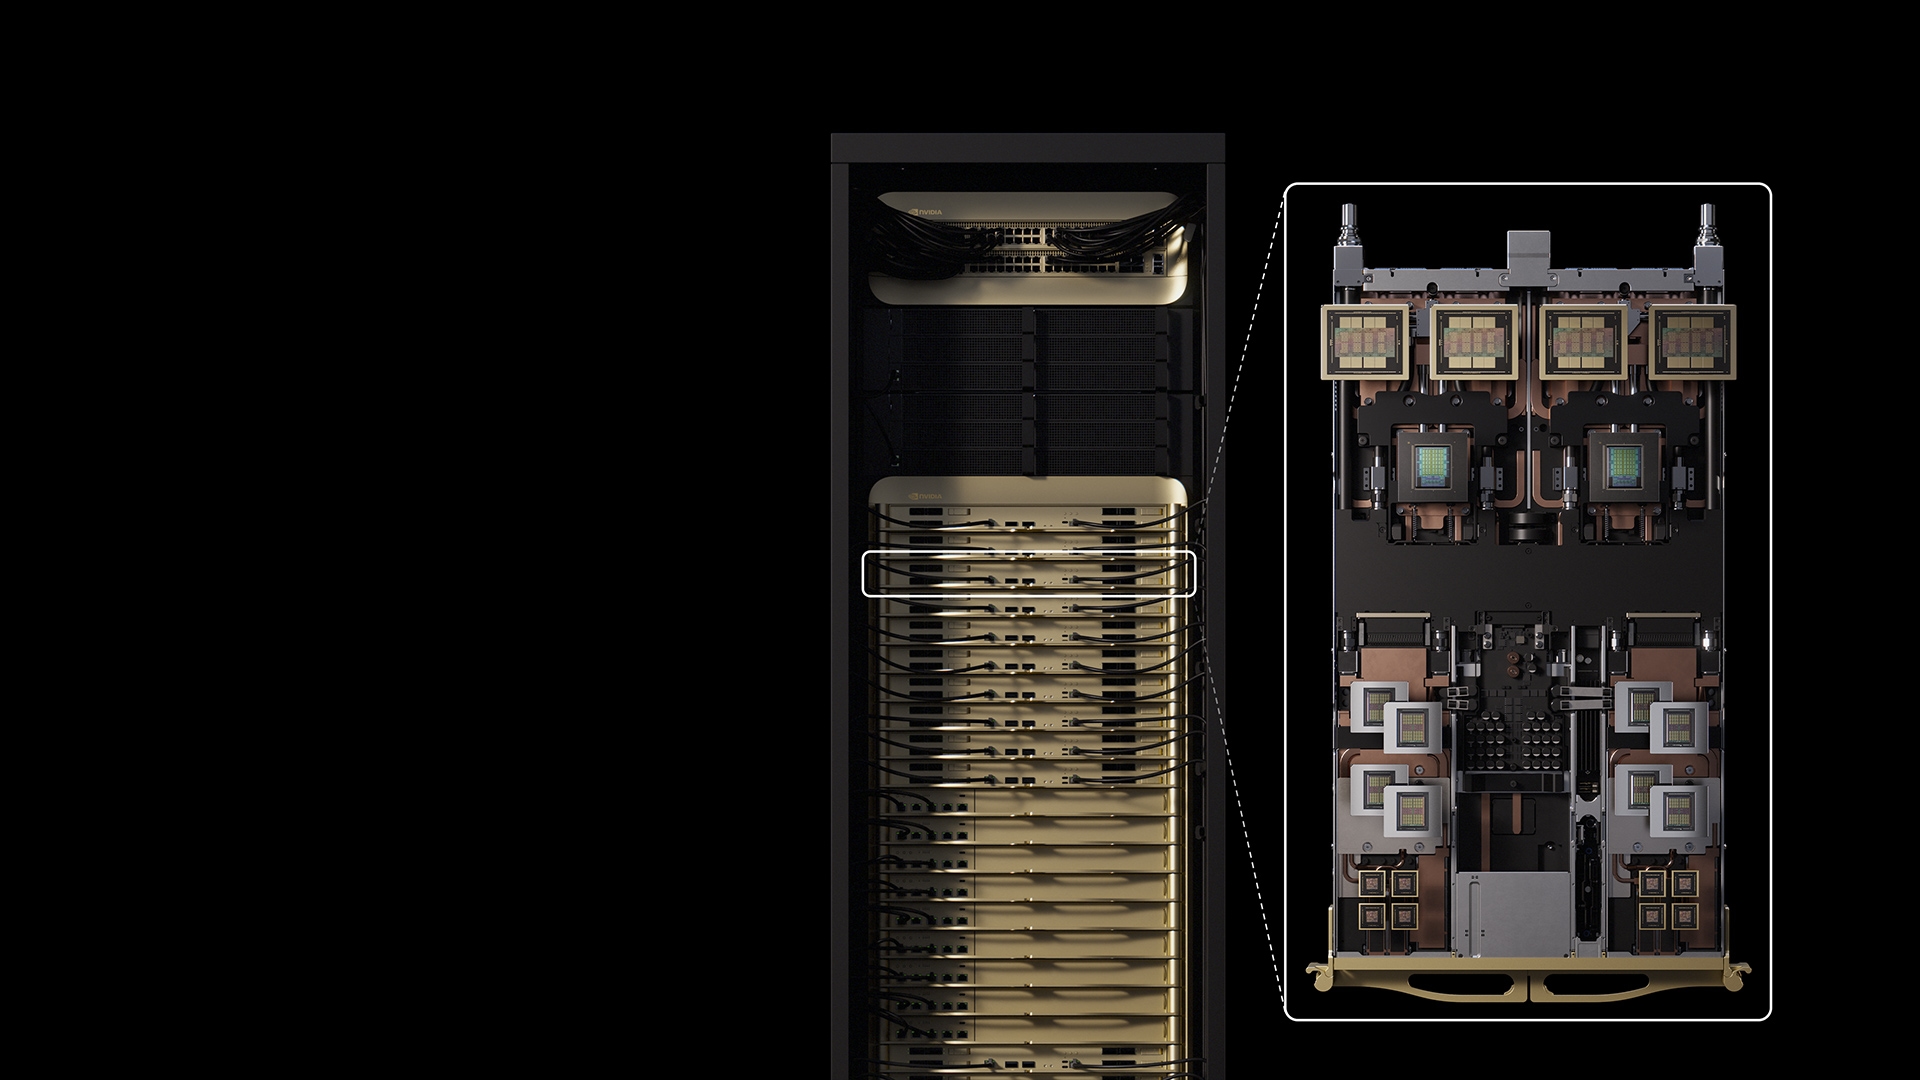
NvidiaはGroq 3 LPX推論アクセラレータを本格生産に移した。Artificial Analysisによる独立ベンチマークでは、オープンモデルのGemma 4 31Bで毎秒3,400トークンを記録し、同モデルで過去最高となった。
なぜ重要か
Nvidiaはこのチップが毎秒882トークンのCerebrasチップより4倍高速だと主張する。エージェント型AIは多数の推論ステップで膨大なトークンを生成するため、速度は不可欠だ。トークン生成が速ければ、ユーザーが待てる時間内に推論ステップやツール呼び出しを増やせる。国内のAI推論を手掛ける企業は、応答速度の競争が激化する可能性がある。
注目点
このベンチマークは実運用の性能を反映していない可能性がある。比較ではチップ数を考慮しておらず、Cerebrasは1〜2個のアクセラレータを使うのに対し、Nvidiaは少なくとも64個必要だ。さらにCerebrasの最新世代CS-4も考慮に入っていない。NebiusはこのチップをToken Factoryを通じて提供する最初のクラウドプロバイダーになる計画で、Groq自身も初期ユーザーだ。
こういう要約が、毎朝あなたのメールに届きます。
NvidiaがGroq 3 LPXを生産に移したのは、12月下旬にGroqライセンスを約200億ドルで買収し、創業者のJonathan Ross氏と社長のSunny Madra氏を迎え入れた後のことだ。Groqのプロセッサはトレーニングではなく推論に特化しており、高速なトークン生成が鍵となるエージェント型AIへのNvidiaの注力に合致する。ベンチマーク結果は印象的だが、The Registerが指摘するように、各LPUのメモリがわずか500MBというアーキテクチャ上の制約により、DeepSeek V3のような大規模モデルでは5ラック以上のアクセラレータが必要になる。またCerebrasとの比較ではチップ数や新しいCS-4世代が省略されている。つまり実際の優位性は、特に複雑で大規模な展開では、見出しの数字が示すほど大きくない可能性がある。Nebiusが最初のクラウドプロバイダーとして登場すれば、Nvidiaのエコシステム外でのチップ性能を実践的に試す機会になるだろう。
業界と使っているAIツールを選ぶと、仕事に関係するニュースが毎朝届きます。
登録無料・Googleアカウントなら30秒・いつでも解除できますAITodayについて →
この記事についてわからないことをAIに質問できます。AIはこの記事・AIToday の過去記事・Wikipedia を読み、出典を付けて答えます。Q&Aはこのページに公開され、他の読者も読めます。
このようなAIの動きを、御社の業界・競合に合わせて毎日届ける法人プランもあります → 詳しく見る
OneTrustはOneTrust CORIEを基盤とするFall '26リリースを発表し、厳選した基盤モデルライブラリからモデルの関連付けと非推奨指標を継続的に更新するAI台帳を追加した

11月18日の日経「Dialogues on the Future」で、ソフトバンクグループの孫正義氏はAnthropicへの出資見送りを「僕の失敗の一つ」と語った

Cassava TechnologiesがNvidia製チップ購入のため最大10億ドルの調達を検討

Microsoft Ignite 2026でマイクロソフトは赤・青・緑チームのエージェントを組み合わせ攻撃模擬・検知調査・脆弱性修正を行うMicrosoft Perceptionの一般提供を発表した

Microsoft Ignite 2026でWindows Server 2028のパブリックプレビューが公開され、Microsoft Foundry、Windows ML、vLLM、Llama.cppによるAI推論ホス…

BrightAIがSmith Point Capital主導のラウンドで97百万ドルを調達


