何が起きたか
IBM、Red Hat、Googleがllm-dのバージョン1.0を公開し、Kubernetesベースのモデル配信向けにマルチテナントのサービス品質、無停止アップグレード、エージェント向けルーティングを追加した。
なぜ重要か
オープンモデルを自社運用する企業は、単一のモデルプロバイダーやクラウド、ハードウェアへの依存を減らす手段を得られる。推論コストの削減を狙う。
誰に効くか主な対象は、オープンモデルをKubernetes上で自社ホストする企業のプラットフォーム・インフラチームだ。制御機能はマルチテナントのトラフィックと無停止アップグレードを狙ったものだからだ。Red HatとIBMのエンジニアはこれを、推論を他の重要サービスと同様に運用することだと位置づけている。
こういう要約が、毎朝あなたのメールに届きます。
llm-dプロジェクトは昨年、IBM、Red Hat、Google、CoreWeave、Nvidiaの協働として始まり、現在はCloud Native Computing Foundationのサンドボックスプロジェクトとしてホストされている。バージョン1.0は、モデルをとにかく動かすことから、本番サービスとして運用することへと焦点を移すもので、IBMはこれが企業導入に欠けていた段階だとしている。
このフレームワークはvLLMやSGLangといった推論エンジンと連携し、モデルサーバーの周囲に分散ルーティングを提供する。IBMは最近のエージェント型コーディング試験で、ルーターが利用可能なキャッシュ再利用の97%を捕捉したと挙げ、GPU容量が制約される状況でキャッシュ情報をGPUメモリ、CPUメモリ、ストレージ間で移動させる技術を説明した。
IBMによれば、エージェントが1つの作業ごとに推論、ツール利用、修正を何度も繰り返すようになるほど、経済性は重要になる。各段階で同一の内容を再処理することが余分な計算を消費するためだ。IBM ResearchのRuchir Puri氏は、オープンモデルとllm-dを、量子誤り訂正向けハードウェア設計のような計算負荷の高い作業で11.8倍の効率優位につなげたとし、バージョン1.0は運用面の準備性によってそうした削減をさらに広げると述べた。
業界と使っているAIツールを選ぶと、仕事に関係するニュースが毎朝届きます。
登録無料・Googleアカウントなら30秒・いつでも解除できますAITodayについて →
この記事についてわからないことをAIに質問できます。AIはこの記事・AIToday の過去記事・Wikipedia を読み、出典を付けて答えます。Q&Aはこのページに公開され、他の読者も読めます。
Thought Industries Inc.が製品知識の矛盾を事前検出するAI製品Lensを発表し、Academyのコース用ソフトをCustomer Knowledge AI Platformに移行した
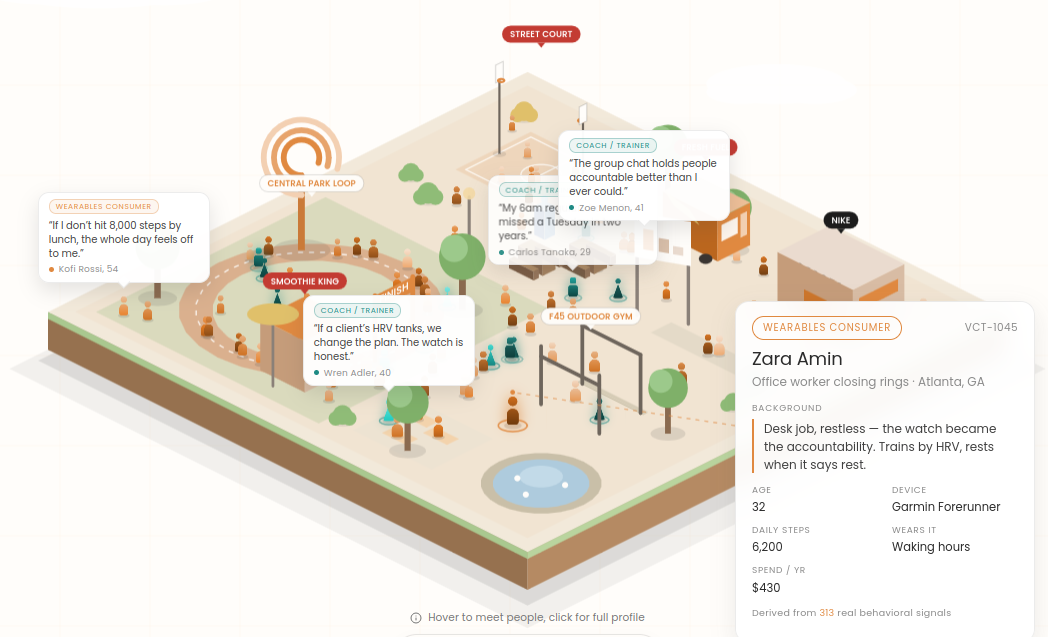
Vectorial AI Inc.がSmilegateとSenseAI Venturesの共同リードで300万ドルのシード資金を調達し、数千人をシミュレーションするAIプラットフォームを launch する
AuxoAI Inc.がNTT Venture Capital主導のシリーズAで2070万ドルを調達
Firefly Technology Inc.がDefinition Capital主導のシリーズAで20百万ドルを調達
Scaled Cognitionが音声合成モデル「Voice」を発表
Chief Telecomが中部科学園区で新しいAIデータセンターの起工式を行い、約33億台湾ドル(1億170万ドル)を投じる