何が起きたか
AWSは、Crawl4AIが公開サイトをクロールし、MarkdownとメタデータのサイドカーファイルをAmazon S3に書き込み、Amazon Bedrock Knowledge Basesがそれを取り込む流れを示すガイドとサンプルリポジトリを公開した。
なぜ重要か
ページ内容をより細かく制御したい、あるいは検索用にカスタムのメタデータフィルターを使いたいチームは、組み込みコネクタだけに頼らず、前処理ステップを追加できる。
こういう要約が、毎朝あなたのメールに届きます。
このガイドはCrawl4AIを、AWSのマネージドWebコネクタの代替ではなく、Amazon Bedrock Knowledge Basesの上流に置く任意の前処理レイヤーとして位置づけている。
ワークフローはスケジュールで実行される。Amazon EventBridgeがAWS Fargateタスクを起動し、タスクが公開サイトをクロールしてMarkdownとメタデータのサイドカーをAmazon S3に書き込み、その後インジェストジョブを開始する。Crawl4AIの役割はこれらのファイルがS3に置かれた時点で終わり、そこから先はAmazon Bedrock Knowledge Basesがパース、チャンク分割、埋め込み、インデックス作成、検索を担う。
サンプルは自らの限界も明示している。再試行ポリシー、デッドレターキュー、アラームは追加されておらず、インジェストジョブは一部のドキュメントが失敗してもCOMPLETEと報告されることがある。アップロードは追加式のため、クロール設定からURLを削除しても既存のS3オブジェクトは削除されない。このパターンを本番導入するチームは、監視と古いコンテンツのクリーンアップ処理を追加する必要がある。
業界と使っているAIツールを選ぶと、仕事に関係するニュースが毎朝届きます。
登録無料・Googleアカウントなら30秒・いつでも解除できますAITodayについて →
この記事についてわからないことをAIに質問できます。AIはこの記事・AIToday の過去記事・Wikipedia を読み、出典を付けて答えます。Q&Aはこのページに公開され、他の読者も読めます。
このようなAIの動きを、御社の業界・競合に合わせて毎日届ける法人プランもあります → 詳しく見る
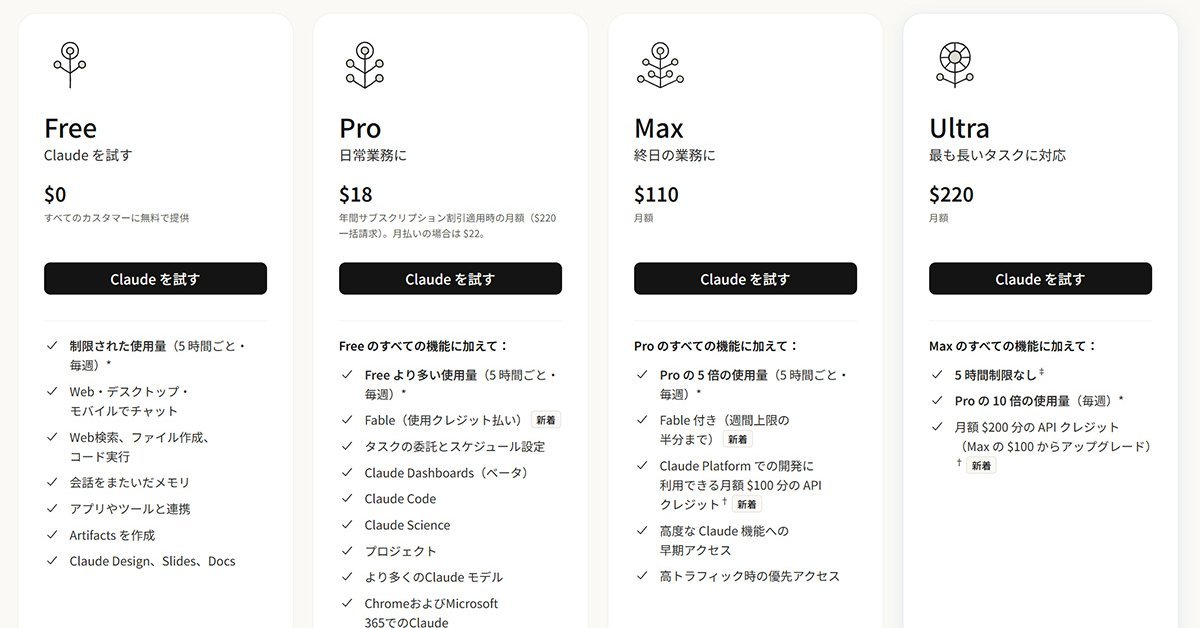
AnthropicはMax 5xをMaxに、Max 20xをUltraに改名し、月額110ドルと220ドルは据え置いた
Chrome 157の安定版がリリースされ、Android版ChromeにLanguage Detector APIが追加された
GoogleはK-12アカウントでGemini、Gemini Notebook、Gemini in Classroom、Google Searchを管理者が有効化するまで既定でオフにすると発表した
Nvidia DGX Spark上の自転車ルート判断テストで、TypeSafe AIのJevがwinnowモデルを動かすOllayaを破り1位
Anthropicは、AIの出力をその生成元の特定モデルに結びつける暗号学的証明を生成するオープンソースシステムFlashProveの研究成果、コード、技術仕様をGitHubで公開した
DellとMicrosoftは提携を拡大し、Dell Automation PlatformとPrivate CloudをAzure Local、Azure Arc、SQL Serverと統合