何が起きたか
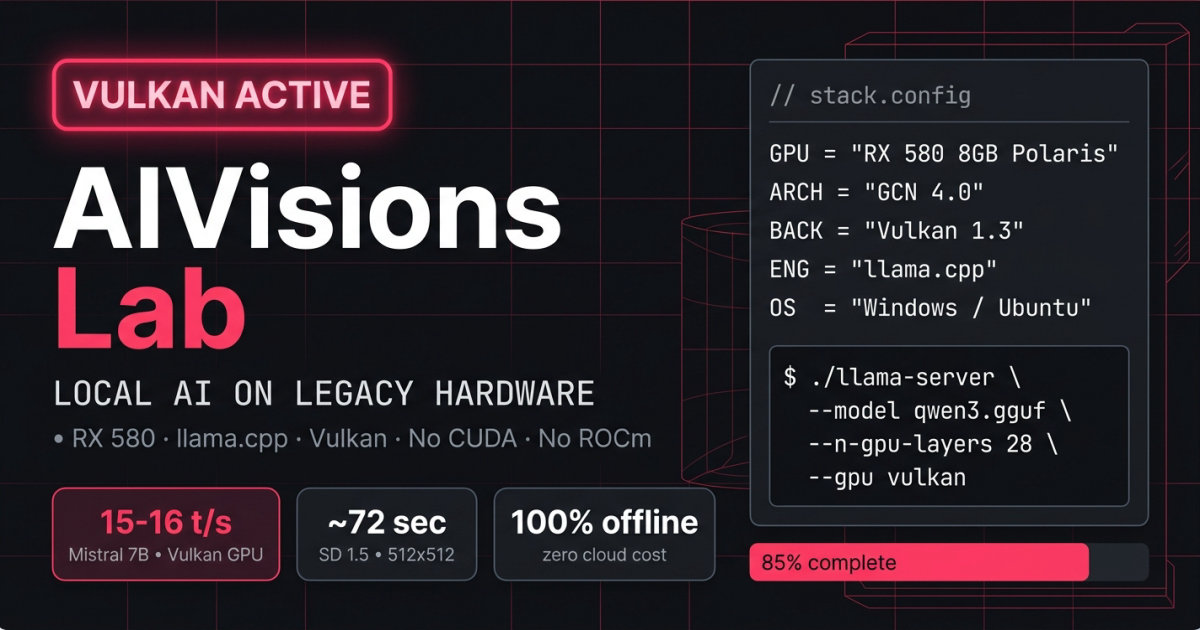
AMD RX 580 8GBを搭載したシステムでllama.cpp(テキスト生成AI)とstable-diffusion.cpp(画像生成AI)のVulkan版をコンパイルして実行。量子化されたMistral 7BやLlama 3などの7B~8Bパラメータモデルで毎秒15~16トークンの推論速度、SD 1.5での512x512解像度画像生成を72秒以下で達成しました。
なぜ重要か
RX 580はAMDが公式にROCmドライバを提供しておらず、MicrosoftのDirectMLも安定動作しないため、それまで有用なAI実行環境がありませんでした。Vulkanという低レベルAPI経由の直接アクセスにより、2017年製の廉価グラフィックスカードでも企業向けの安定したオフラインAI運用が可能になったとみられます。
注目点
NVMe SSDの高速データ転送(毎秒1.7~3.5GB)が重要な役割を果たし、量子化モデルの読み込みを従来の数十分から数秒に短縮しました。古いハードウェアの再活用と低コストでのローカルAI導入の選択肢が広がっています。
こういう要約が、毎朝あなたのメールに届きます。
業界と使っているAIツールを選ぶと、仕事に関係するニュースが毎朝届きます。
登録無料・Googleアカウントなら30秒・いつでも解除できますAITodayについて →
この記事についてわからないことをAIに質問できます。AIはこの記事・AIToday の過去記事・Wikipedia を読み、出典を付けて答えます。Q&Aはこのページに公開され、他の読者も読めます。
このようなAIの動きを、御社の業界・競合に合わせて毎日届ける法人プランもあります → 詳しく見る
次の記事へAnthropicが米国政府の輸出規制に直面し、Fableモデルを利用不可に――安全性への関心が規制の判断を左右している。
