何が起きたか
Amazon SageMaker AI MTRLでQwen3.6-27Bを微調整し、BrowseComp-PlusでnDCG@10が23.7%向上、失敗率は22.89%から0.68%に低下した。
なぜ重要か
失敗率の大幅な低下は、エージェントがターン数とトークン予算内でタスクを完了できるようになったことを示す。専用の小規模モデルで高い信頼性が得られるため、推論コストと遅延の削減につながるとみられる。
注目点
FreshStackではnDCG@10が0.4112から0.4089へ低下し、改善はベンチマーク次第である。
誰に効くか社内検索やカスタマーサポート向けのRAGシステムを運用する情報システム部門やMLエンジニアは、専門的なRL知識なしに小規模モデルを自社環境へ適応させ、検索品質と信頼性を高められる可能性がある。
こういう要約が、毎朝あなたのメールに届きます。
従来、検索エージェントのようなマルチターン行動の学習には課題があった。教師あり微調整(SFT)は理想的なマルチターン軌道の専門家によるデモンストレーションを必要とし、収集コストが高く、自社環境向けのデータは通常存在しない。単一ターンの強化学習(RLVRなど)は一度の応答のみを評価するため、検索エージェントが多数のターンにわたって相互依存的に行う意思決定を最適化できない。
MTRLはエージェントの全マルチターン軌道を最適化し、最終的な結果のみを反映する報酬信号を使う。今回の検証では、FRAMES、BRIGHT、Enterprise RAG、ESCI、Musique、MLQAを訓練に、FreshStack、WixQA、BrowseComp-Plus、Wandsをテストに使い、nDCG@10を報酬関数とした。訓練ではmax_epochs、global_batch_size、rollout_max_concurrencyの3つのハイパーパラメータのみを変更し、RLアルゴリズムやアドバンテージ推定器、オフポリシーの陳腐化境界はデフォルトのままとした。
結果として、WixQAで+18.4%、Wandsで+6%、BrowseComp-Plusで+23.7%のnDCG@10改善が見られ、FreshStackではわずかに低下した。特にBrowseComp-Plusの失敗率が22.89%から0.68%へ下がったことは、ターン数とトークン予算内でタスクを完了する能力が向上したことを示す。ただし、この改善はベンチマークやデータセットの性質に依存する可能性があり、自社環境への適用時には評価と反復が不可欠とみられる。
業界と使っているAIツールを選ぶと、仕事に関係するニュースが毎朝届きます。
登録無料・Googleアカウントなら30秒・いつでも解除できますAITodayについて →
この記事についてわからないことをAIに質問できます。AIはこの記事・AIToday の過去記事・Wikipedia を読み、出典を付けて答えます。Q&Aはこのページに公開され、他の読者も読めます。
Metaは新モデル「Muse Wonder」と「Muse Wonder Full」の2つを発表し、ザッカーバーグ氏はOpenAIとAnthropicの最新モデルに匹敵すると述べた
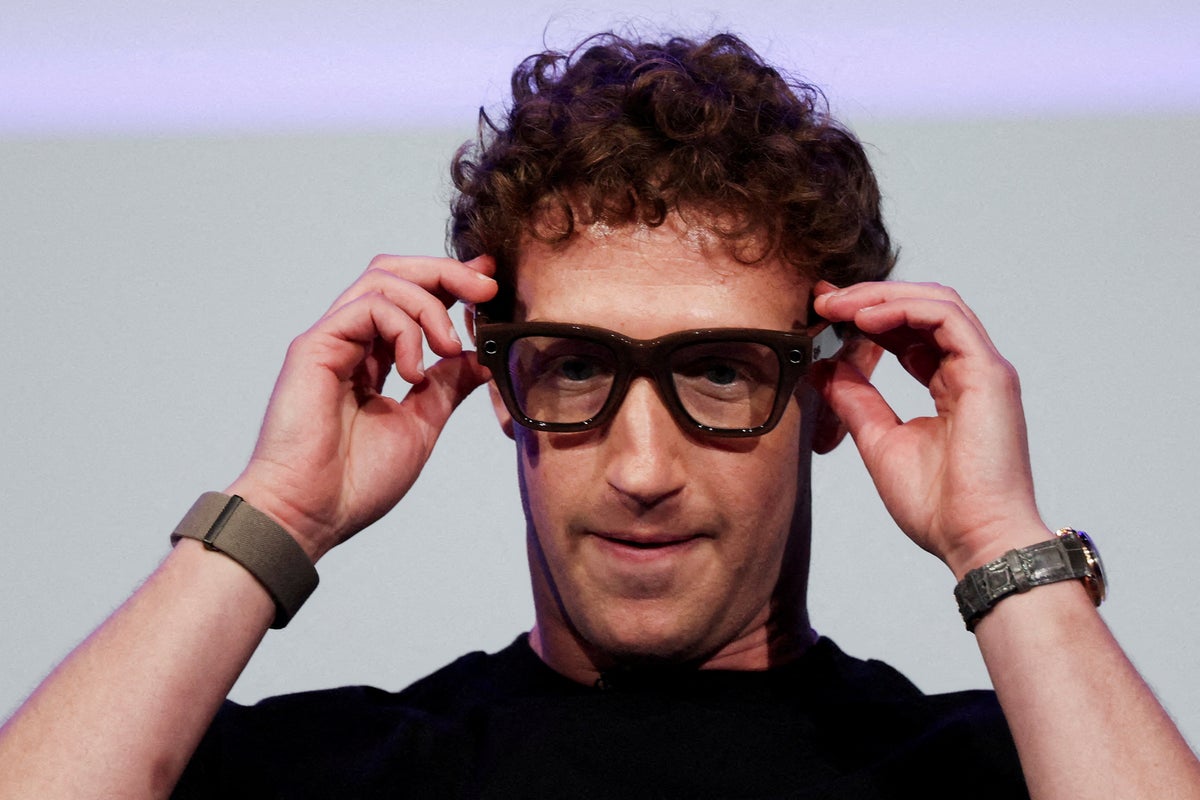
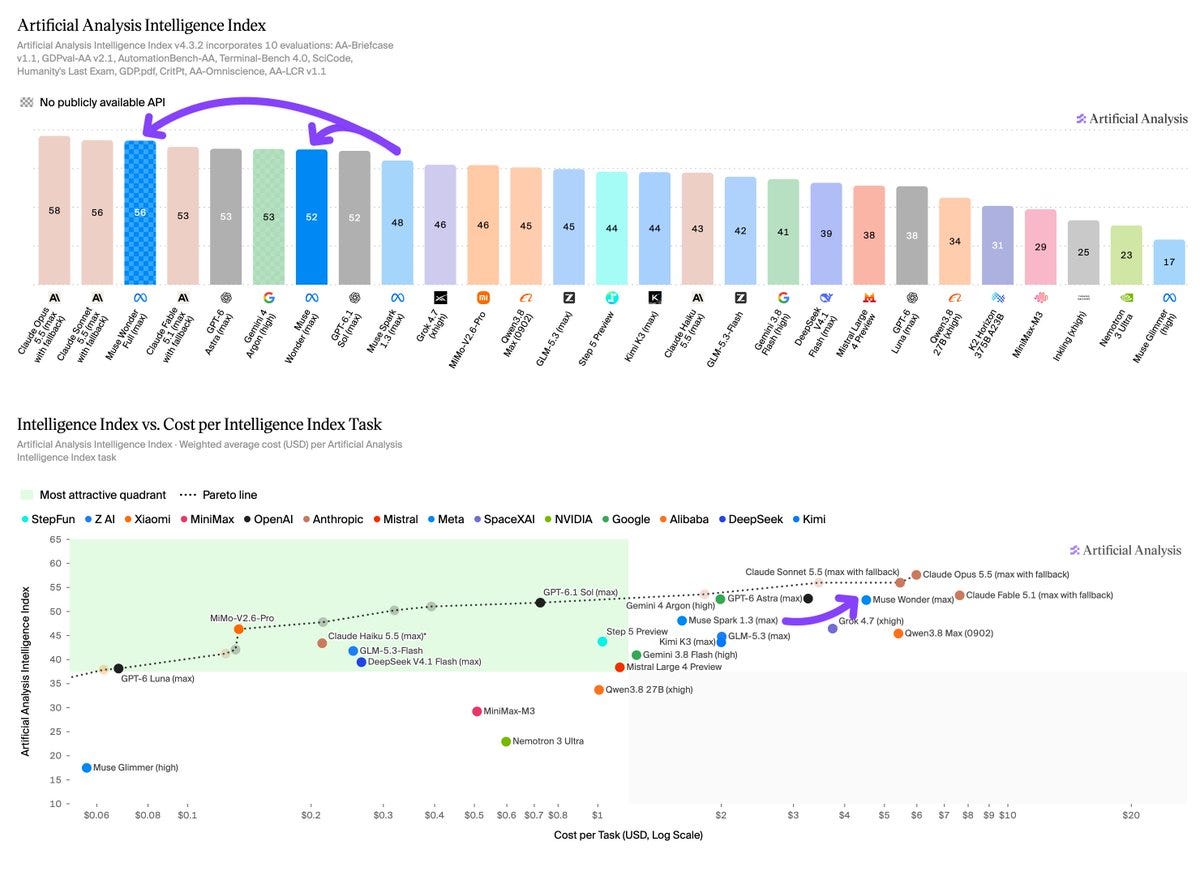
Meta Superintelligence LabsはMuse WonderとMuse Wonder Fullを投入し、Artificial Analysis Intelligence Index v4.3で52と56…
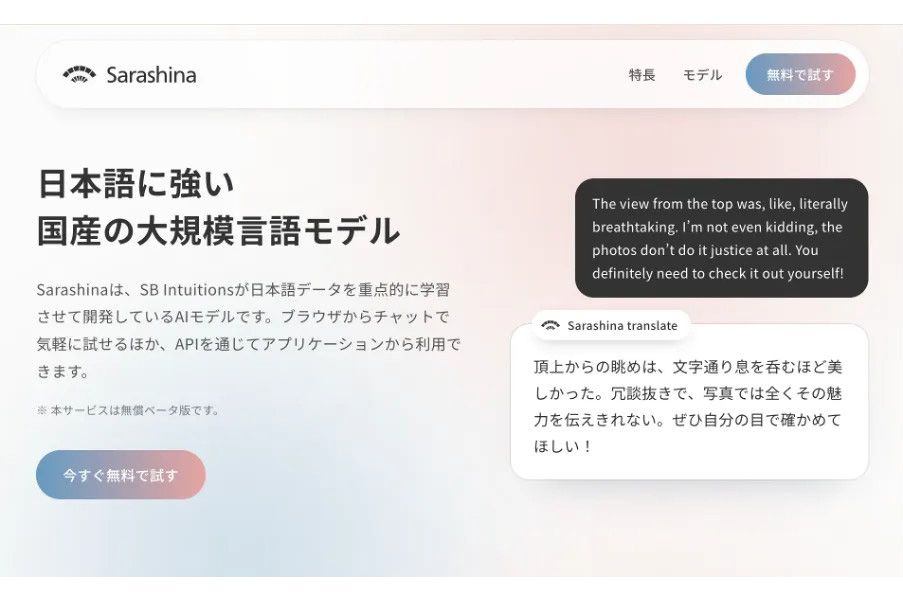
SB Intuitionsが10月13日、Sarashinaサービスの無償β版を開始
ビジネス読者向けの日本語解説記事が、ローカル推論――AIモデルを手元のPCやスマートフォンのCPU、GPU、NPUで動かし、データを端末外に出さない技術――を説明した
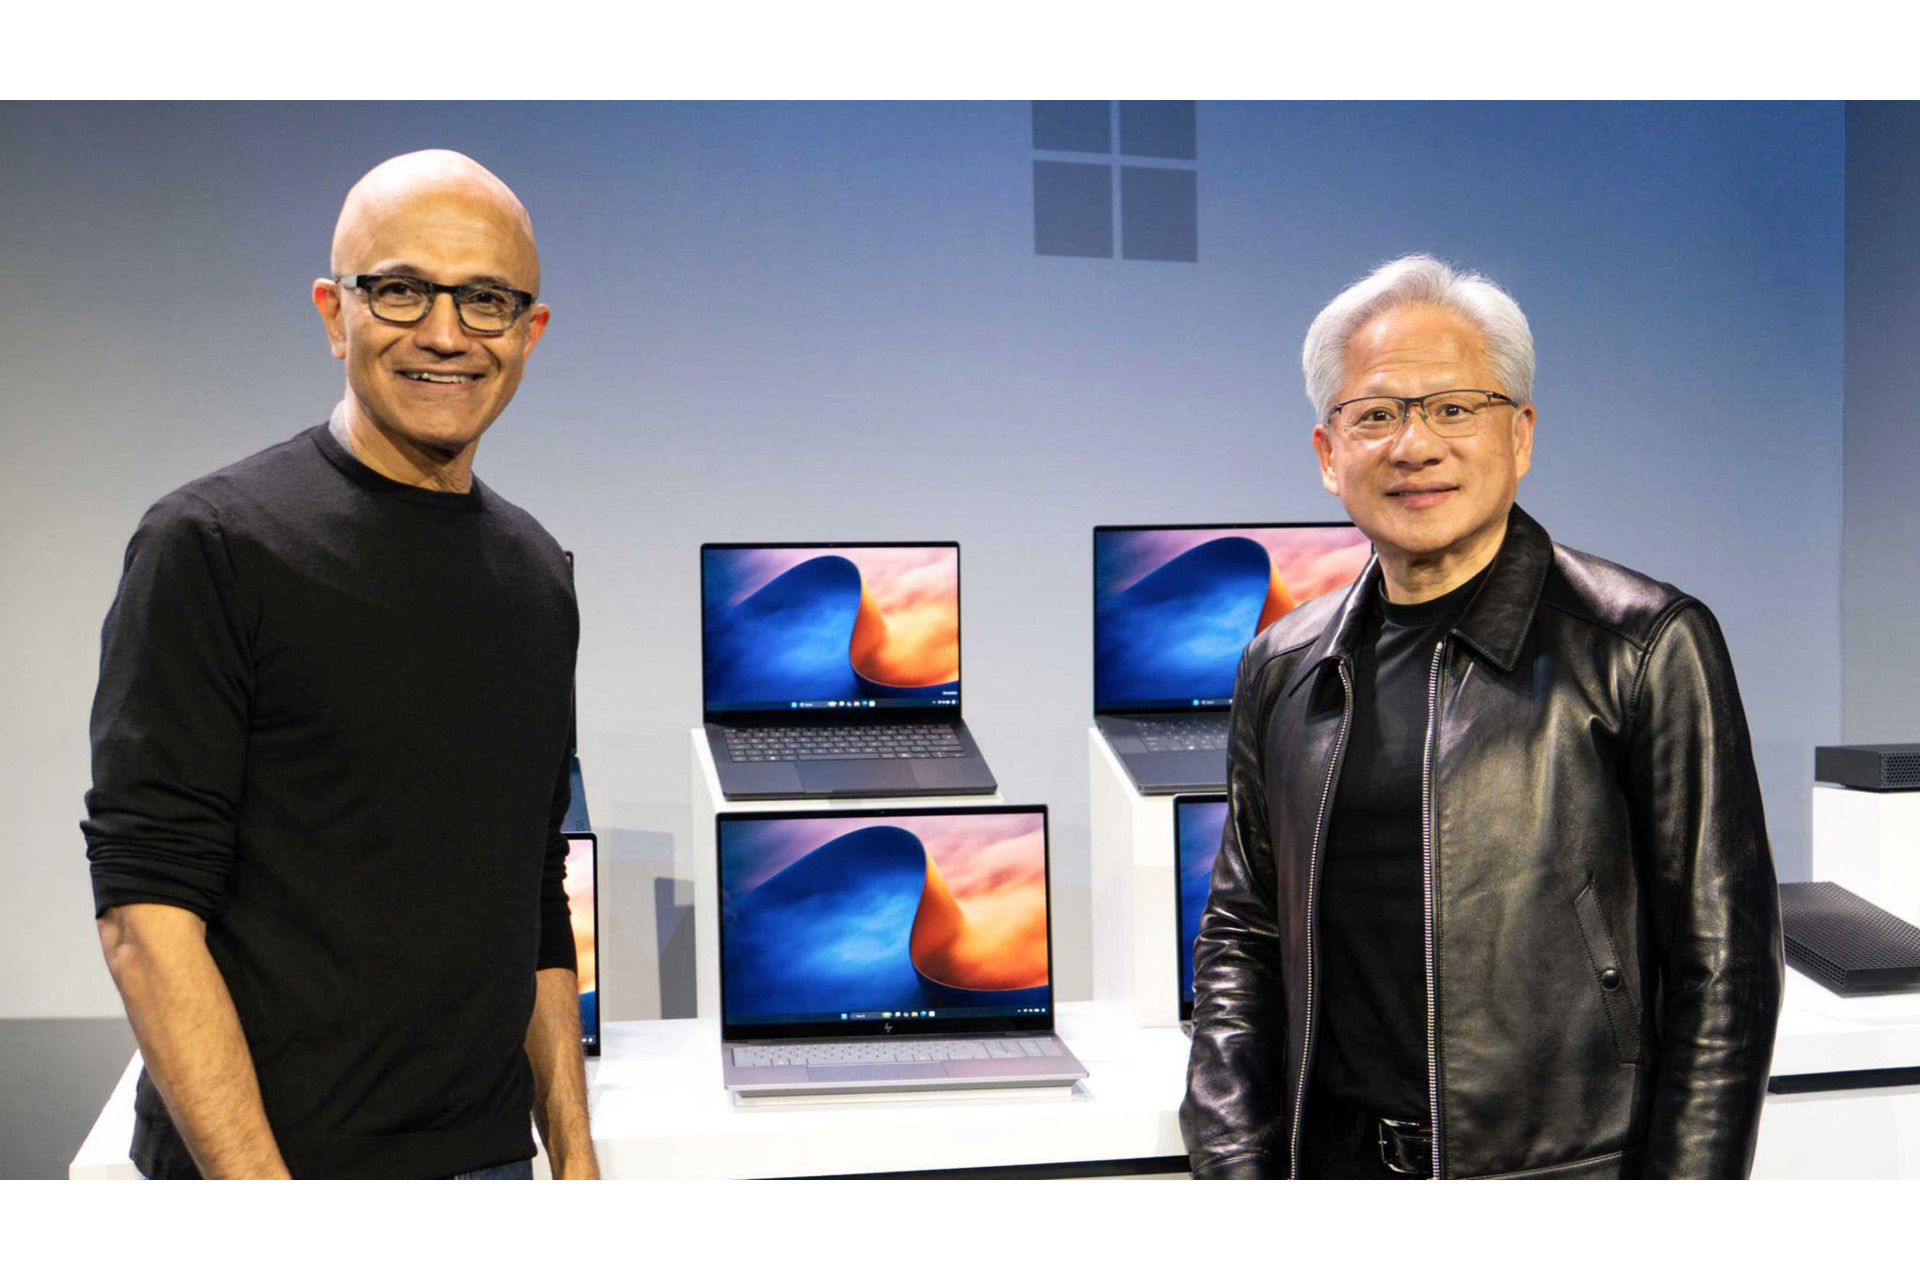
「Windows AI and Surface」でNVIDIAとMicrosoftがWindows PC上のAIエージェント計画を発表し、MXCを一般提供、DGX Station for Windowsを予告した
NTT西日本と茨木市は10月13日、市立小中学校で校務向け純国産プライベートLLMの実証を始める